
一句话总结:中科大周少华、熊鹏团队发布开源 RNA 序列基础模型 structRFM,用约 2100 万条经计算注释的序列-二级结构配对数据预训练,只输入序列就能输出序列级、核苷酸级、核苷酸对级三类特征,用于结构预测和功能推断。成果 11 月 5 日发表于《自然》,数据、权重、代码全部开放。
这条新闻我是在一堆模型发布的稿子里翻出来的,位置很靠后。
标题里没有"万亿参数",没有"超越 GPT",只有一句话:中国科研团队发布开源核糖核酸序列基础模型。
但它是这批新闻里唯一一个发在《自然》上的。
一、structRFM 是什么:给 RNA 建模加上结构
蛋白质那边有 AlphaFold,RNA 这边一直没有同等地位的东西。
原因不难理解。蛋白质由 20 种氨基酸组成,序列到结构的映射规律研究了半个世纪。RNA 只有四种碱基(A、U、G、C),但它的功能高度依赖折叠方式——一条链会自己跟自己配对,形成发夹、凸环这些二级结构,再叠成三级结构。
序列相似不代表功能相似,结构才是关键。 这是 RNA 研究的老问题。
structRFM 的思路是把结构知识塞进预训练阶段。团队先构建了约 2100 万条带二级结构注释的序列数据,然后在预训练时让模型同时学两件事:序列上下文,和结构依赖。
预训练完之后,模型只吃序列就能吐出三类特征:序列级、核苷酸级、核苷酸对级。这三类特征可以喂给不同的下游任务。
二、2100 万条数据从哪来:计算注释不是实验测定
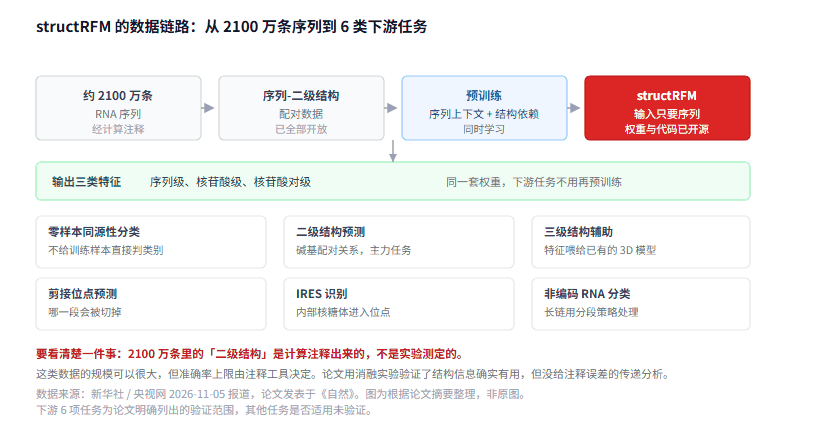
图 1:从序列到配对数据到模型到六类任务,中间那一步决定了数据质量的上限
这里有个细节值得单独说,因为它决定了这个模型的可信边界。
新闻原文写的是"约 2100 万条经计算注释的序列-二级结构配对数据"。
计算注释的意思是:二级结构不是实验测出来的,是算法算出来的。
这两种数据的区别很大:
| 实验测定 | 计算注释 | |
|---|---|---|
| 数据量 | 少,RNA 结构实验本身难做 | 可以到千万级 |
| 准确率 | 高,是金标准 | 取决于注释工具 |
| 覆盖范围 | 集中在少数研究充分的家族 | 可以覆盖全库 |
2100 万这个数字能成立,靠的就是第二条路。
这不是造假,是领域惯例——蛋白质那边也有大量预测结构被用于训练。但要清楚:模型学的是注释工具的判断,注释工具错了,模型也跟着错。
论文用消融实验验证了结构信息的引入确实带来提升,这一步做得规范。但我没看到它分析注释误差如何传递到下游任务。这是这类工作的共同短板。
三、模型结构:三类特征怎么输出
三类特征的划分是按粒度来的:
序列级 是整个分子的一个向量,用来做分类任务,比如判断这条 RNA 属于哪个家族。
核苷酸级 是每个碱基一个向量,用来做逐位点的预测,比如这个位置是不是剪接位点。
核苷酸对级 是任意两个碱基之间的关系,用来做配对预测,也就是二级结构的核心。
这个设计的好处是一次预训练、多种用法。不用为每个任务单独训一个模型。
论文里说"预训练后仅需输入序列即可提取"这三类特征。这句话的含义是:下游任务不需要结构标签,只要有序列就行。对那些拿不到实验结构的 RNA 来说,这是唯一可行的路径。
四、跑分:零样本、二级结构、三级结构
论文给的验证分四块,口径都是作者自报,没有第三方复现。
零样本同源性分类:表现良好。零样本的意思是训练时没见过这个类别,直接判。这类测试最能看出模型的泛化能力。
二级结构预测:性能提升。这是主力任务,也是数据注释的主要目标。
三级结构:把 structRFM 的特征融进已有的 3D 结构预测模型,三维结构和对应的二级结构预测都有改善。
功能推断:支持剪接位点预测、内部核糖体进入位点(IRES)识别、非编码 RNA 分类三项。
还有一个细节值得注意:在新发布的 RNA 家族上,模型保持了较好的二级结构预测表现。这说明它不是死记硬背训练集里的家族。
长链非编码 RNA 用分段策略处理——太长的序列一次喂不进去,切成段分别编码再拼。这是工程妥协,不是方法创新,但必须做。
五、RNA 模型和蛋白质模型差在哪
很多人会拿它和 AlphaFold 比。这两件事不完全可比。
| 蛋白质(AlphaFold 系) | RNA(structRFM) | |
|---|---|---|
| 输入 | 氨基酸序列 | 碱基序列 |
| 主输出 | 三维结构 | 三类特征 + 二级结构 |
| 数据基础 | PDB 实验结构十几万条 | 计算注释 2100 万条 |
| 成熟度 | 接近实用 | 研究阶段 |
| 开源范围 | 部分开源 | 数据、权重、代码全开 |
差别最大的是数据基础那一行。蛋白质有几十年的实验结构积累,RNA 没有。所以 RNA 这边只能走"大规模计算注释 + 预训练"的路子。
全开源这件事值得肯定。 论文说完整配对数据、模型权重、源代码都已开放,这意味着别人可以复现、可以微调、可以拿去试新任务。基础科学模型能做到这一步的不多。
同类工作里,Mol-1 那篇走的是生物分子路线,抗体预测加约束能到 88.3%。两个模型分处 RNA 和小分子两头,凑在一起能看出科学模型这半年在往哪走。
站内之前写过 Carbon-X 的 DNA 分词器,那篇讲的是把六个碱基切成一个 token,压缩到六分之一。这篇讲的是给 RNA 加结构信息。两件事都在解决同一个问题:生物序列怎么变成模型能吃的形式。
六、structRFM 常见问题
structRFM 能预测 RNA 的三维结构吗?
不能直接预测。它输出的是三类特征,三级结构要靠这些特征喂给专门的 3D 预测模型。论文说的是"融入后改善了预测结果",不是端到端出结构。
2100 万条数据都是真实的 RNA 吗?
序列本身来自公共数据库,二级结构是计算注释的。所以"真实"指的是序列,结构部分是预测值。
和 ESM 系列什么关系?
思路同源,都是"大规模序列预训练 + 下游微调"。ESM 针对蛋白质,structRFM 针对 RNA。RNA 这边可用的结构数据少得多,所以 structRFM 更依赖计算注释。
普通开发者能用吗?
能拿到,但用起来有门槛。需要懂 RNA 二级结构的表示方式(点括号记法之类),也需要有具体的下游任务。不是那种装个包就能跑的通用工具。
为什么发在《自然》而不是 ML 会议?
因为贡献的主体是生物学问题——RNA 结构预测和功能推断,不是新的网络结构。这类工作的方法创新可能一般,但领域价值大。
七、边界
我没跑过这个模型。 所有分析基于新华社和央视的报道,以及论文摘要级别的信息。具体的评测数字、基线对比、消融实验细节,我没看到原文。
"性能提升"没有具体数字。 报道里用的是"表现良好""提高了""改善",没有一个百分比。这在科学新闻里很常见,但对判断实际价值不利。
计算注释这个前提的影响我没法量化。 注释工具本身的准确率是多少、错误在哪些类型上集中、对下游任务的影响有多大,这些决定了 2100 万条数据的实际含金量。论文有没有做这个分析,我不知道。
开源的具体范围要自己去仓库确认。 报道说"完整配对数据、模型权重和源代码"都开放,但许可证类型、商用是否允许,这些要看实际文件。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。