
一句话总结:把任务按难度分给不同价位的模型,实测每 1000 个任务能省 42% 成本,准确率从 97.7% 降到 93.8%。但真正的风险不是分类器判错多少,而是往哪个方向错。随机误判会互相抵消,把难题低估成简单题才会翻车。准确率也不是线性可交易的,93.8% 和 84.1% 之间有断崖。
上一篇算过算力涨价对内容站的影响,结论是「人工驱动的影响接近零,全自动的躲不掉」。
那有没有办法在不大幅掉质量的前提下把成本降下来?
有,而且大部分团队都能做:按任务难度路由到不同价位的模型。
我写了一遍,算了账。
一、先算一笔账:全大、全小、路由
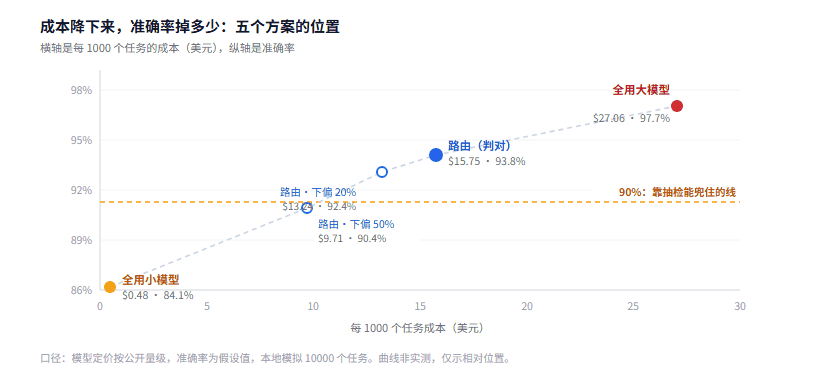
图 1:横轴是成本(对数),纵轴是准确率。越靠左上越好
设定是这样:
三个价位的模型,按公开定价的量级:
| 档位 | 输入 | 输出 |
|---|---|---|
| 小 | $0.15/M | $0.60/M |
| 中 | $2.50/M | $10/M |
| 大 | $10/M | $30/M |
任务分三档难度,token 用量分别是 500、2000、8000。分布按 60% 简单、30% 中等、10% 困难。
各模型在各难度上的准确率是模拟的(这个必须说清楚,不是实测):
| 简单 | 中等 | 困难 | |
|---|---|---|---|
| 小 | 0.95 | 0.75 | 0.45 |
| 中 | 0.98 | 0.92 | 0.75 |
| 大 | 0.99 | 0.97 | 0.92 |
跑 10000 个任务,三种策略的结果:
| 策略 | 每 1000 任务成本 | 准确率 |
|---|---|---|
| 全用大模型 | $27.06 | 97.7% |
| 路由 | $15.75 | 93.8% |
| 全用小模型 | $0.48 | 84.1% |
路由省了 42% 的钱,掉了 3.9 个点。
全小模型省 98%,但掉 13.6 个点。这个折扣太大了,除非你的任务本来就简单。
二、成本路由省 42%,代价是 3.9 个点
先说这 42% 从哪来。
任务的分布是 60/30/10。如果把简单任务全扔给小模型:
简单任务占 60%,单价降到大模型的 1/66
这一块就省掉了整个预算的一大半
中等任务走中模型(1/4 单价),困难任务才用大模型。
成本的大头永远在「量大的那一档」,不在「贵的那一档」。 60% 的简单任务乘上 1/66 的单价,比 10% 的困难任务省钱多得多。
3.9 个点从哪来?
简单任务上,小模型 0.95,大模型 0.99,每个简单任务掉 4 个点。占 60% 的任务量,加权后就是 2.4 个点。中等任务上,中模型 0.92 vs 大模型 0.97,掉 5 个点,占 30%,加 1.5 个点。
合计约 3.9。对得上。
三、误判的方向比概率更重要
这部分是我做完实验后最意外的发现。
我原本以为「分类器判错概率越高,损失越大」。实际跑出来不是。
对称误判(随机判成相邻档)几乎没影响:
| 判错率 | 节省 | 掉分 |
|---|---|---|
| 0% | 41.8% | 3.9pt |
| 10% | 42.7% | 4.1pt |
| 20% | 43.3% | 4.2pt |
| 30% | 42.8% | 4.4pt |
判错 30% 和判对,成本和准确率几乎一样。
原因是误差互相抵消:判高了(简单题当中等题)会多花钱但提高准确率,判低了会省钱但掉准确率。两个方向一平均,净效果接近零。
但单向下偏就不一样了:
| 误判率 | 节省 | 掉分 |
|---|---|---|
| 0% | 41.8% | 3.9pt |
| 10% | 46.2% | 4.5pt |
| 20% | 51.1% | 5.3pt |
| 30% | 55.2% | 6.0pt |
| 50% | 64.1% | 7.3pt |
误判率越高,省得越多,掉分也越多。因为所有错误都在同一个方向:把难题当简单题做。
这就是真实的失败模式。 分类器不会随机犯错,它倾向于把难题判成简单题,因为难题的表面特征(短 prompt、常见词汇)和简单题很像,真正难的地方要做了才知道。
所以做路由的第一件事不是提高分类准确率,是保证分类器的错误不要系统性偏向「低估难度」。宁可多花点钱往上判,也别往下判。
四、准确率掉到哪一档,决定方案能不能用
这是第二个发现。
看这两个选择:
| 方案 | 成本 | 准确率 | 每掉 1pt 省多少 |
|---|---|---|---|
| 路由 | $15.75 | 93.8% | 10.8% |
| 全小 | $0.48 | 84.1% | 7.2% |
单看数字,全小模型「更划算」:每掉 1 个点省得更多。
但这是错的。
97.7% 到 93.8% 这一段,掉的是「边缘 case」;93.8% 到 84.1% 这一段,掉的是「基本能力」。
前者你能接受,多几个人工复核就行。后者不行:错误会成批出现,而且集中在同一类任务上。
所以「每省 1% 成本掉多少准确率」这个指标本身有误导性。正确的问法是:掉的这部分准确率,是不是我能兜住的?
我的判断:93% 以上,靠抽检能兜;90% 以下,得上全量人工;85% 以下,不如不做。
五、怎么定自己的路由策略
四条实操建议。
一、先用规则,别急着上分类器。 任务长度、是否带代码、是否要检索、输出格式是否固定,这几条规则能覆盖大部分判断,而且比模型便宜、比模型可解释。
二、错误方向往上偏。 拿不准的时候用贵的模型。多花的钱远小于返工的成本。
三、留 5% 的抽样用大模型。 定期把路由到小模型的任务抽一部分用大模型重跑,对比结果。这是监控质量漂移的唯一办法。
四、按业务结果而不是准确率定阈值。 准确率掉 4 个点,落到业务上是「多几个客服工单」还是「多几笔错账」,差别很大。后者的话 4 个点也不能接受。
站内之前算过投机解码的加速上限,那个是「省钱要什么条件」。这篇是「省钱要付什么代价」。一个算上限,一个算底线。
还有一篇算算力涨价对内容站的冲击,结论是人工驱动的影响小、全自动的躲不掉。这篇正好是那条结论的解法:在「全自动」和「全人工」之间,还有一条按难度分流的中间路。
六、成本路由常见问题
路由需要自己训分类器吗?
大多数场景不需要。规则 + few-shot 提示就够了。训分类器要标注数据,而且任务分布一变就得重训。
三个档位够吗?
通常够。档位太多会让判断变难,而且价差小的两档之间路由的价值不大。
怎么知道路由的效果?
两条线:成本看账单,质量看抽样。不要只看账单降了多少,一定得配一个质量的对照。
如果所有任务都很简单呢?
那就直接用最小的模型,不用路由。路由的价值在任务分布有差异的时候才体现。
这套方法对大模型 API 和自建推理都适用吗?
思路通用,但自建的话「小模型」的边际成本更低,路由的收益会更大。
七、边界
所有数字都是模拟的。 模型定价用的是公开量级,准确率是我设的假设值,不是任何真实模型的实测。数字的形状能说明道理,绝对值不能当参考。
我没考虑重试成本。 真实系统里小模型失败要重试,重试又要花钱。这部分会让路由的优势缩小一些。
任务分布 60/30/10 是拍的。 如果你的任务 90% 都是困难题,路由几乎没用武之地。
「断崖」的位置我没法精确定位。 93% 和 90% 这两个阈值是我的经验判断,不同业务差别很大。你的场景得自己测。
分类器的真实错误模式我没测。 「下偏」这个结论是基于逻辑推的(难题的表面特征和简单题像),但没有数据支撑。真要做这个项目,第一步是把历史任务拿出来,看分类器在哪些样例上出错。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。