
一句话总结:伯克利、普林斯顿、斯坦福和英伟达联合开源的 SpecPilot,让 Agent 自己找投机解码的性能瓶颈、自己写优化、自己验证效果。Qwen3.8-27B 上单请求从 4.46 倍提到 10.87 倍,批处理从 1.94 倍到 3.93 倍,全程不训练、不改输出。
看到 10.87 这个数字,我第一反应是参数写错了。
投机解码我算过两遍。按常规配置——接受率 0.9、草稿长度 8、草稿成本 15%——理论上限是 3.4 倍左右。这个数字我在投机解码那篇里推过一遍,又在MTP 那篇里反解过一次,两次结论对得上。
10.87 倍,等于把那个上限翻了三倍。
所以我去翻论文原文,想看它到底改了什么。看完发现:它没改投机解码本身,它改的是"调参"这件事。
一、SpecPilot 的四组数字:单请求和批处理差三倍
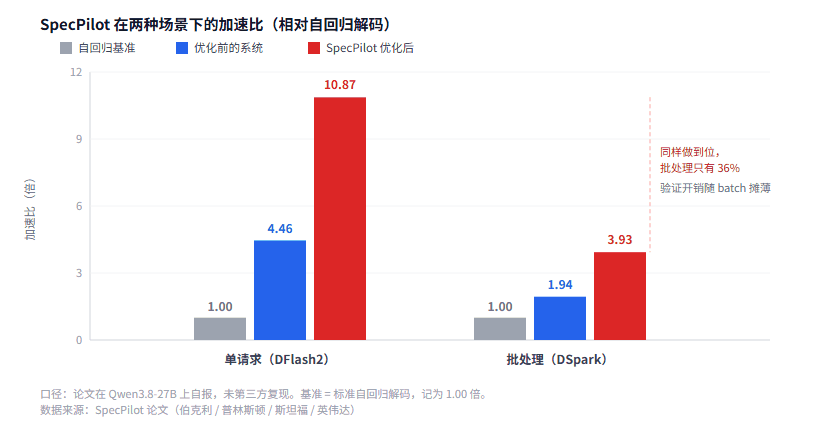
图 1:同一个框架,两种场景的起点和终点完全不同
三组数字的基准都是自回归解码(就是老老实实一个 token 一个 token 生成,记为 1.00 倍)。
| 场景 | 原来的系统 | 原加速比 | SpecPilot 后 | 提升 |
|---|---|---|---|---|
| 单请求 | DFlash2 | 4.46× | 10.87× | 2.4 倍 |
| 批处理 | DSpark | 1.94× | 3.93× | 2.0 倍 |
测试模型是 Qwen3.8-27B。
注意批处理那组的绝对值:3.93 倍,只有单请求的 36%。 这不是 SpecPilot 做得不好,是批处理本身就更难加速。原因后面讲。
一行代码没改,凭什么快一倍多
论文给的答案是:原来的系统没吃满自己的潜力。
这句话听着像公关话术,但它给了具体的分解方法。SpecPilot 把每一次推理步的时间拆成三个因子的乘积,算出来最大的那个就是当前最该优化的方向。
这套东西叫成本模型,是整个框架的 Phase 0。
二、SpecPilot 的三因子模型:瓶颈到底在哪
三个因子分别是 τ 因子、内核因子、开销因子。
τ 因子衡量"每一步接受了几个 token"。 算法拿当前系统的实际接受数量,去比对"精确回放里最优 best-first 树、在最佳节点预算下能接受多少"。这个比值就是 τ。τ 小于 1,说明草稿树的结构没选好,本来是能多接受几个的。
内核因子衡量"硬件跑满了没有"。 算法取每个内核(目标模型 GEMM、循环层、注意力、草稿器、Prefill)的两个理论下限:FLOP 时间(按 60% 峰值稠密吞吐算)和字节时间(按 90% 峰值带宽算),取两者中较大的那个。把所有内核的下限加起来,再和实际剖析到的步时间比。比值越高,说明内核实现离硬件极限越远。
开销因子衡量"剖析之外还有什么"。 实际步时间除以剖析步时间。大于 1 说明有没被 profiling 覆盖的额外开销,比如调度、同步、内存拷贝。
三个因子乘起来就是理论差距。每轮开始都重算一遍,最大的那个因子就是本轮该攻的方向。
这个设计的聪明之处在于承认瓶颈会转移。 你把 τ 优化上去了,瓶颈立刻跑到内核效率上;内核也压榨完了,开销因子又冒出来。所以它是循环迭代的,不是一次性调优。
论文说这个循环跑下来,机制库攒了 140 条。这是第五部分要讲的。
三、投机解码的 Agent 并行探索:一张 GPU 试一个方向
Phase 1 是并行探索。
具体做法:多个 Agent 同时开工,各自负责一个优化方向,每个方向占一张 GPU。Agent 在这个方向上写代码、跑基准、量结果。
跑出有效果的,进 Phase 2 自动集成到主系统。
这里有个成本问题得说清楚:每个 Agent 占一张 GPU,探索是多卡并行的。 论文没说具体用了多少张卡,也没说整个优化过程花了多久。这个信息缺失比较关键,因为如果是 8 卡跑两天才换来 2.4 倍提升,那对大部分人来说不划算。
所以我只能把它当成"研究性质的一次性投入",不是"你部署的时候随手跑一下"。
四、Token Forcing:怎么防住刷分
这里我认为是整篇论文最值得抄的设计。
Agent 的奖励是"加速比变高"。这就有个天然的作弊路径:改输出,让它更容易预测。
比如让模型输出更短、更套路化的句子,接受率自然就上去了,加速比也好看。但模型已经不是在干原来那个活了。
Token Forcing 的做法很直接:把每一个输出 token 和原系统做严格比对。对不上就判失败。
这条约束把所有"靠改变输出换速度"的路都堵死了。Agent 只能去找真正的系统优化。
我觉得这个思路比它的加速比更值得关注。 现在越来越多系统用 Agent 做自动优化, rewarding 什么、怎么防止走捷径,是绕不过去的问题。SpecPilot 给的答案很朴素:拿原始输出当基准,逐 token 对。
代价是验证成本:每一步都要多做一次比对。但相对于整个循环的开销,这个成本可以忽略。
五、140 条投机解码机制:凭什么能跨硬件迁移
论文提到验证过的机制会进结构化记忆库,目前累计 140 条,支持跨模型、跨硬件迁移。
这句话的含义是:优化经验被沉淀成了可复用的条目,不是每次从零试。
举个具体的例子。假设某轮发现"草稿树的分支宽度设成 4 比 8 好",这条经验会被记下来。下次换一个模型,Agent 先去记忆库里查有没有相关条目,有的话直接试,不用重新摸索。
这个设计和站内讲过的 Skill 很像:都是把"做过一遍的事"固化成下次能直接用的东西。区别是 Skill 是人写的经验,这个记忆库是 Agent 自己试出来的。
能迁移到什么程度,论文没给数字。 有多少条只对特定 GPU 有效、多少条能跨架构,这个比例决定了记忆库的实际价值。如果 140 条里只有 20 条是通用的,那它更像个日志。
六、SpecPilot 常见问题
SpecPilot 需要重新训练模型吗?
不需要。全程零训练、零质量损失。它改的是推理系统的调度策略和草稿树结构,模型权重一个字节都没动。
10.87 倍是所有模型都能拿到吗?
不是。这个数字是在 Qwen3.8-27B 上测的,配套 DFlash2 草稿器。换模型、换草稿器、换 GPU,最优解都不一样——这恰好是论文强调的第三个痛点:部署强相关,人工调优跟不上。
批处理为什么只有 3.93 倍?
每个请求的验证计算要单独算。batch 越大,验证开销在总时间里占比越高,加速比被摊薄。单请求时验证几乎免费(反正权重都要读一遍),批处理时不是。
能直接拿来用吗?
开源了。但它是"优化框架",不是"优化结果"。你拿到的是那套循环,不是一个已经调好的配置。想受益得自己跑一遍,成本见第三部分。
和 vLLM 里现成的投机解码什么关系?
vLLM 里那套是"能跑"的版本,SpecPilot 是"榨干"的版本。它默认你已经有 DFlash2 或 DSpark 这类并行草稿器,然后在此基础上找差距。
七、边界
我没跑过它。 所有分析基于论文和公开报道,加速比数字是论文自报,没有第三方复现。
三个因子里的系数值得推敲。 FLOP 时间按 60% 峰值算、字节时间按 90% 峰值算——这两个数是怎么定的、对结果敏不敏感,论文里我没找到敏感性分析。系数偏一点,判断的瓶颈方向可能就变了。
10.87 倍这个数字的成立条件比看起来窄。 它要求草稿成本压得极低、接受率极高。我下一篇文章会把这两个条件的数量级算出来,到时候能看出这个数字离"普遍可用"还有多远。
站内另一条线可以对照着看:message threads 那篇省的是重复传输,这篇省的是串行步数。两件事都在打同一个目标——首 token 之后的等待时间。
参考资料
- 腾讯新闻 - 伯克利、英伟达开源优化推测解码的 RSI 框架,Qwen3.8-27B 平均加速 10.87 倍
- arXiv - SpecPilot: Autonomous Algorithm Discovery and Systems Optimization for Speculative Decoding
- 网易 - AI 自己改推理系统,SpecPilot 把 Qwen3.8-27B 单请求加速硬拉到 10 倍
- 一行代码没改,凭什么快一倍多
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。