
一句话总结:清华和伯克利联合开源的 uni-robot-agent,给机器人 agent 做了一层统一工具接口,RoboDojo 上把 Qwen3.8-Flash-Next 从 28.97 分推到 31.39 分。但同一个框架换上 GPT-6 Astra 能拿 51.90——框架值 2.4 分,模型值 20 分。
论文挂 arXiv(2611.01560),代码在 GitHub 上开源。作者阵容里有刘知远、周伯文,伯克利那边是 Pieter Abbeel。
机器人 Agent 为什么需要统一接口
Coding Agent 能跨任务复用经验,靠的是同一套工具:读文件、执行代码、看输出,换个项目接口不变。
机器人这边完全不是这样。单臂和双臂的动作接口不同,坐标系不同,控制规则也不同。模型学会"抓取"这件事,换一台机械臂就得重新理解参数含义。经验没法迁移。
uni-robot-agent 要做的事,就是把这层差异挡在接口后面:模型只管调用标准化的感知和动作工具,底层是哪种硬件由 Harness 翻译。
思路和 Gemini 4 Argon 那套不同。Argon 是把仿真构建做成 API,替你做数据;这套是把硬件差异做成 API,替你做适配。一个在数据侧,一个在接口侧。
RoboDojo 上的 31.39 分:框架带来多少
| 配置 | RoboDojo 分数 |
|---|---|
| Qwen3.8-Flash-Next + 官方 RoboProbe | 28.97 |
| Qwen3.8-Flash-Next + RUA 框架 | 31.39 |
| GPT-6 Astra + RUA 框架 | 51.90 |
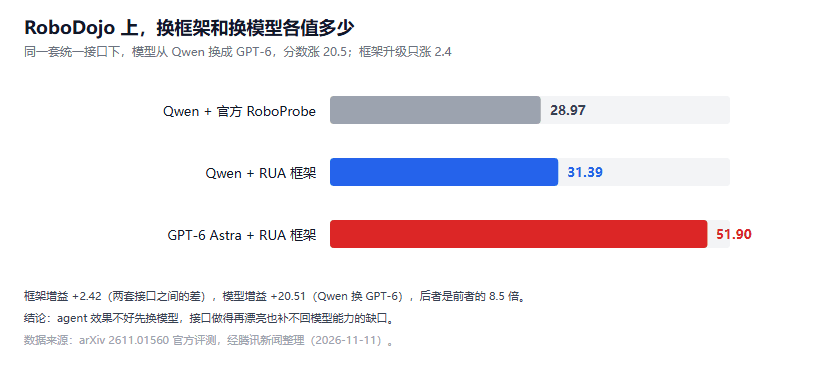
图 1:RoboDojo 基准,三个配置的对照
框架本身带来 2.42 分。这个幅度不大,但要注意基线的口径:官方 RoboProbe 也是套工具接口,所以这 2.42 分是"两套接口之间"的差距,不是"有接口和无接口"的差距。
有接口和无接口的差距,在这类任务上是几十个点——没有工具接口,模型只能输出文本,连动作都发不出去。
机器人 Agent 真机 19 项:开源模型 53.50 分
真机测试比仿真更能说明问题:
| 配置 | 19 项任务得分 |
|---|---|
| Qwen + RUA(未做任务微调) | 53.50 |
| π₀.₅(微调后) | 47.75 |
| Dream-1(零样本) | 43.50 |
| GPT-6 Astra + RUA | 80.50 |
一个没针对任务微调过的开源通用模型,打赢了微调过的专用策略 π₀.₅,领先 5.75 分。
这个结果的意义在于路线之争:过去做机器人策略,主流是"针对每类任务微调专用模型";这套结果显示,通用模型加一套好接口,可以不微调就打平甚至超过专用模型。省下的是每个任务的采数据和训练成本。
统一接口省下的到底是什么
前面说"经验没法迁移",这句话拆开看,是三层东西在挡路。
第一层是参数含义。 单臂机器人的"移动到 (x, y, z)"是末端执行器的位置;双臂机器人的同一个动作要指定用哪只手,还要给另一只手一个协调约束。模型看到同样的接口名,要做的事完全不同。
第二层是坐标系。 有的机器人用基座坐标系,有的用世界坐标系,相机还有自己的坐标系。同一句"向前移动 10 厘米",在不同坐标系下是三个方向。
第三层是控制粒度。 有的接口接受末端位姿,逆解由底层做;有的只接受关节角度,逆解要上层算。前者简单但没法做避障,后者灵活但要求模型懂运动学。
这三层叠起来的结果是:每换一台机器人,之前调好的提示词、动作序列、失败处理,全部要重写。
uni-robot-agent 的做法是把这三层都收到 Harness 里,对外只暴露一套标准工具。模型看到的是"抓取(物体描述)""移动到(位置描述)"这类语义接口,底层怎么解算由 Harness 决定。
这个设计和 Coding Agent 的工具抽象是同一个思路——先定接口,再让模型学怎么用接口,而不是让模型直接面对每种环境的细节。
代价也有:语义接口会丢掉一部分精度。Harness 把"抓取"翻译成具体动作时,必须做一些假设,这些假设在特殊场景下会出错。所以真机测试里那 53.50 分,有一部分损失来自这层翻译,不只是模型能力。
和 π₀.₅ 那条路线的分歧
π₀.₅ 代表的是另一条路:针对每类任务微调专用策略。这条路在过去几年是主流,因为它能榨干单一任务的表现。
53.50 对 47.75 这个结果,说明通用模型加好接口,可以在"没微调"的前提下赢过"微调过的专用模型"。
但要看清条件:这 19 项任务是同一批硬件、同一套评测环境。换成完全不同的机器人,微调派需要重新采数据训练,通用派只需要 Harness 适配。成本结构不一样,短期表现和长期成本是两件事。
我的判断是这两条路会并存:追求单一任务极致性能的场景继续微调,需要快速适配多种硬件的场景用通用模型加接口。开源这套框架的价值,是让第二条路的门槛降下来了。
机器人 Agent:换模型比换框架重要得多
把上面两组数字放一起看:框架值 2.42 分,换模型值 20.51 分(31.39 到 51.90)。差了八倍。
这个结论对工程决策很直接:如果你的机器人 agent 效果不好,先看模型够不够强,再考虑换框架。接口做得再漂亮,模型能力不够也补不回来。
反过来也成立——接口做得差,强模型会被浪费。GPT-6 Astra 在官方 RoboProbe 上的成绩没有公开,所以"框架对强模型的增益"这个数我没法算。这是个缺口,官方应该补。
失败原因和成本也一起测了
这项工作还测了失败原因、能力短板和运行成本。这一点比分数有用得多。
机器人基准的常见问题是只报成功率,不报失败模式。"失败了"和"抓起来摔了"是两回事,前者可能是识别错误,后者是控制参数问题。
运行成本也一样。真机实验的开销按小时算,一个任务要跑几百次才算得准。这些数字如果不公开,别人没法判断这套东西在自己场景里划不划算。
开源的价值也在这里:不只是放个模型权重,是把评测环境、失败案例、成本结构一起放出来。这条路线和 Cosmos 3 那种造仿真环境的做法可以叠着用——一个负责生成训练场景,一个负责统一控制接口。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。