
一句话总结:Meta 的 Muse Ember 把输入价打到 0.1 美元每百万 token,是 Fable 5.2 的 1/80。按一个 1 次规划加 1 万次执行的 agent 任务算,全用大模型要 104.1 美元,大小模型分层只要 1.32 美元——省 98.7%,而且省下来的不是我算错的小数点。
11 月 9 日,Meta 超级智能实验室发布 Muse Ember。输入 10 美分每百万 token,支持文本、图像、音频,定位不是替代大模型,而是跟更大的 Muse Wonder 分工:Wonder 定规则,Ember 把规则套到成百上千个相似案例上。
这个价格放进当前的市场里,位置很清楚。
agent 成本档位:0.1 美元是什么概念
| 模型 | 输入价(美元/百万 token) | 相对 Ember |
|---|---|---|
| Meta Muse Ember | 0.10 | 1× |
| DeepSeek V4.1 Flash | 同区间 | — |
| GLM 5.3 Flash | 同区间 | — |
| Claude Haiku 系列 | 更高 | — |
| Claude Fable 5.2 | 8.00 | 80× |
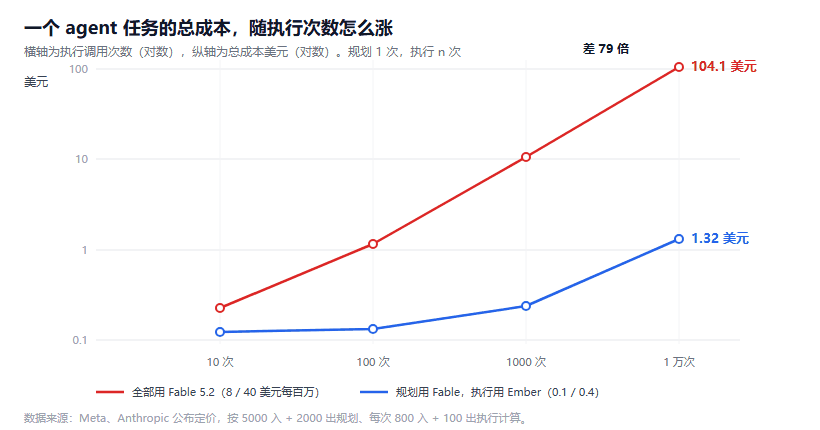
图 1:执行 1 万次的总成本随调用次数增长,纵轴为对数刻度
Ember 和两个开源 Flash 模型挤在同一个价位区间,这一点比"比 Haiku 便宜"更值得注意。开源模型把价格锚定在 0.1 美元附近之后,闭源厂商要么跟,要么在别的地方证明自己值 80 倍。
这个路子不新鲜:混元 Hy4 把缓存价打到 1/20,本质也是"不降能力,降重复读取的单价"。区别在于 Hy4 降的是同一模型的复用成本,Ember 降的是换一个模型跑。
Meta 自己的说法是用 Artificial Analysis 的合成基准,声称"比 Haiku 和 Luna 更便宜也更聪明"。这个比较我没法独立验证——合成基准的分数和真实任务表现经常对不上,尤其在这种定位为"执行"的小模型上。
算一笔 agent 的账:模型分层省 98.7%
假设一个客服 agent 处理一张工单:先用大模型判定意图、出计划(5000 输入 + 2000 输出),然后 1 万次工具调用和字段抽取(每次 800 输入 + 100 输出)。
全用 Fable 5.2(8 / 40 美元每百万):
  规划   5000×8/1e6 + 2000×40/1e6        = 0.120 美元
  执行   10000×(800×8 + 100×40)/1e6      = 104.0 美元
  合计   104.12 美元

分层(规划用 Fable,执行用 Ember 0.1 / 0.4):
  规划   0.120 美元
  执行   10000×(800×0.1 + 100×0.4)/1e6   = 1.20 美元
  合计   1.32 美元
差 79 倍。这个数字大到不像真的,所以要说清楚它的前提:执行步骤必须真的"可复制"——同样的输入格式、同样的判定逻辑、不需要跨步骤推理。一旦某个执行步骤需要回头改计划,分层就断了。
真实业务里这个前提经常不成立。工单处理到第 300 张时冒出一个特殊案例,需要重新判意图,这条链路就得回到大模型。所以 98.7% 是理论上限,不是平均值。
什么时候不能分层
分层的成本优势来自"执行步骤便宜且独立"。下面三种情况,硬分会出问题。
错误会连锁的。 10 次调用里错 1 次,摊下来还能忍;1 万次调用里错 1% 就是 100 次错。小模型准确率低几个点,在这个尺度上会被放大成事故。
判定边界模糊的。 "帮客户查订单"和"帮客户改地址"在文本上可能只差几个字,小模型容易串。串了之后要回滚,回滚成本比省下的钱高。
需要长上下文的。 Ember 这类小模型的上下文窗口通常比旗舰小得多。要带着前 50 轮的对话历史做判断,它塞不进去。
判断方法很土:把执行步骤抽 200 条出来,人工核对一遍。准确率 98% 以上、且错误可以单条回滚,就分层;低于 95%,或者错误会传导,就别分。
这条曲线改变的是什么
把成本画成调用次数的函数,全用大模型是一条斜率 0.0104 的直线,分层是 0.00012。前者 1 万次调用就破百美元,后者要 100 万次才到 120 美元。
这个差别不是"便宜一点",是决定的业务能不能上线。一个每天要跑 10 万次工具调用的产品,按第一种账是每天 1040 美元,一个月 3.1 万美元——这个数直接决定项目批不批。按第二种是每月 40 美元。
所以真正的问题从来不是"选哪个最强的模型",是流程能不能被正确拆开:哪些节点值得付高价,哪些步骤能沉下去批量跑,哪些判断必须留给人。拆分能力比选型重要。
这件事跟编程模型那条线是同一个方向。Fable 5.2 这类旗舰在往上走,把复杂任务的成功率从 32% 推到 49%;Ember 这类小模型在往下走,把重复执行的成本压到 1/80。中间那层——曾经靠"什么都还行"活着的通用中号模型——正在被两头挤掉。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。