
一句话总结:一个 12B 模型权重常驻 3.34GB,跑 128K 上下文时 KV cache 要 25GiB,是权重的 7.5 倍;显存的大头从来不在权重,在随上下文线性增长的 KV。
上周有篇新闻挺唬人:12B 参数的模型压到 3.34GB 常驻显存,说是消费级显卡的福音。评论区一片"这下老卡也能跑大模型了"。我第一反应不是质疑压缩率,是想算另一笔账:权重是省下来了,上下文一开长,KV cache 会把省出来的部分加倍还回去。
这篇把 KV cache 这笔账完整算一遍,从公式到代码到优化手段。所有数字都来自实际运行的脚本,贴的是真实输出。
一个 12B 模型的账:3.34GB 权重和 25GiB KV
拿那个 12B 模型的公开架构做例子:d_model 5120、40 层、GQA 32 个注意力头配 8 个 KV 头、head_dim 160。这个配置不是我编的,来自模型发布页的架构描述,是消费级 12B 模型的典型形态。
KV cache 的公式一行就写完:2 × 层数 × KV头数 × head_dim × 序列长度 × 每元素字节数。乘 2 是因为 K 和 V 各存一份。代进去:2 × 40 × 8 × 160 × 131072 × 2 字节,等于 25.0 GiB。
对照权重 3.34GB,128K 上下文的 KV 是它的 7.5 倍。更扎心的是 32K 这个不算长的档位:KV 6.2GiB,已经是权重的 1.9 倍。也就是说上下文超过 30K 左右,"12B 模型只占 3GB"这句话就开始骗人了。
KV cache 公式只有一行,变量藏在层数里
把这个公式写成可复算的脚本,跑一遍对照几个常见规模:
def kv_gib(layers, kv_heads, head_dim, seq, bytes_per=2):
    return 2 * layers * kv_heads * head_dim * seq * bytes_per / 2**30

# 输出:
# 12B 架构(40 层、8 KV 头、160 维)各档位 KV:
#    4K:    0.8 GiB
#   32K:    6.2 GiB  (权重的 1.9 倍)
#  128K:   25.0 GiB  (权重的 7.5 倍)
#  256K:   50.0 GiB  (权重的 15.0 倍)
同为 128K 上下文,不同模型的 KV 差异也很大:7B 级架构(32 层、8 KV 头、128 维)要 16.0 GiB,上面这个 12B 要 25.0 GiB,70B 级(80 层、128 维)要 40.0 GiB。层数翻倍 KV 就翻倍,这个线性关系意味着越深的模型长上下文代价越大。
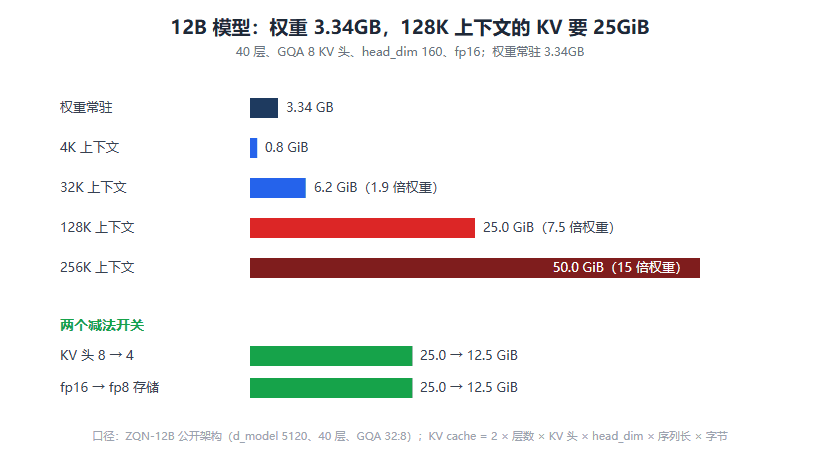
图 1:权重固定 3.34GB,KV cache 随上下文档位翻倍增长,256K 时到权重的 15 倍
注意 head_dim 这个变量容易看漏:它是每个头的维度,不是模型总维度除以头数就完事。GQA 下 32 个查询头共享 8 个 KV 头,每个头的 head_dim 是 5120 除以 32 等于 160,KV 按的是这 160 和 KV 头数的 8,不是 5120。看 config 时把这两层除法都做对,算出来的数才对得上。
GQA 是唯一的减法:KV 头砍一半省一半
既然 KV 线性于 KV 头数,减头数就是最直接的省法。GQA 的设计初衷正在这里:32 个查询头共享 8 个 KV 头,比传统 MHA(KV 头等于查询头数)直接省了 4 倍。
往更狠的方向砍还有余地。把 8 个 KV 头减到 4 个,128K 的 KV 从 25.0 降到 12.5 GiB;减到 1 个(MQA)只剩 3.1 GiB,和权重一个量级。代价是能力损失:KV 头减半通常掉几个点,砍到 MQA 在长文本检索任务上损失明显。开源权重改不了结构,这条减法只对自训或微调的人有效。
# 输出:
# KV 头数对 128K KV 的影响(40 层、head_dim 160):
#   8 头: 25.0 GiB
#   4 头: 12.5 GiB
#   2 头:  6.2 GiB
# 1 头: 3.1 GiB顺带一提,上一篇 27B 的 24GB 卡账里 40K 的上下文边界,用的就是同一套公式。两篇对照着看,会发现"模型多大"和"上下文多长"在显存里是两个独立轴,宣传时只说其中一个。
fp8 存 KV:最便宜的省显存开关
改不了结构的人有一个现成开关:KV 量化。fp16 存 KV 改成 fp8,25.0 GiB 直接变 12.5 GiB,128K 上下文从"两张卡"变"一张 24GB 卡加一点运气"。
# 输出:
# fp8 存储 128K KV: 12.5 GiB(省一半)
精度代价存在但要客观:KV 量化对输出质量的影响通常小于权重量化同等力度的影响,因为 KV 是临时缓存、生命周期只有一次请求,个别离群值影响的是单次注意力而不是永久权重。主流推理框架都提供这个开关,vLLM 和 llama.cpp 里各有一两个参数的事。
真要抠精度,还有折中路线:K 用 fp8、V 保持 fp16,或者只对超过一定长度的序列启用 KV 量化。这些混合策略在工程上都验证过,效果比一刀切稳。
什么场景会真的撞上这堵墙
写了这么多,撞墙的场景值得点名。第一是 agent 类应用,多轮工具调用把历史全塞上下文,几轮下来 32K 没了,KV 直接翻着倍涨;第二是代码库级问答,整个仓库几十万 token 喂进去,权重 3GB 的模型配 50GiB 的 KV,画面的荒诞程度不低;第三是多路并发服务,每路请求各有一份 KV,这笔更要单独算。按 12B 架构每 1024 token 消耗 0.195GiB 的比率,10 路并发各 16K 上下文,KV 总量 31GiB,再加权重和激活,一张 32GB 的卡已经爆了。并发服务和单用户试用是两道完全不同的题,前者要按「每路 KV 乘并发数」做容量规划,乘出来的数字经常比直觉大一个量级,这也是推理服务成本容易被低估的主因。
所以选模型时看两个数的乘积:权重决定它住多大房子,层数乘 KV 头决定它开长上下文时再买多大的房。3.34GB 的权重很便宜,25GiB 的 KV 才是房东递来的真账单。这笔账我在K3.1 Pro 部署那篇也算过一遍:1.56TB 的权重配 1M 上下文,单请求 KV 488GiB,比权重本身还吓人。
留个边界声明:本文架构参数取自模型发布页,正式容量规划请以 config.json 实际数值复算;KV 量化的精度影响各框架实现差异不小,上线前拿自己的任务回归一遍。
FAQ
Q:KV cache 为什么随上下文线性增长?
注意力机制要求每个已生成的 token 都保留 K 和 V 向量供后续 token 查询,token 多一个就多一份。没有任何机制让它饱和,这是架构决定的,不是实现问题。
Q:为什么用 KV 头数而不是总头数算?
GQA 架构下多个查询头共享同一组 KV 头,显存里只存 KV 头的份额。12B 例子中 32 个查询头共享 8 个 KV 头,省了 4 倍,这是 GQA 的核心价值。
Q:fp8 存 KV 会掉点多少?
没有统一数字,框架和模型差异大。经验上对常规任务影响在噪声级,长程精确检索任务可感知。建议 A/B 一遍自己的任务再决定,开销就是改一个配置项。
Q:PagedAttention 这类技术能省 KV 吗?
它省的是碎片不是总量。PagedAttention 把 KV 切成页管理,消除预留浪费,同卡能塞更多并发,但每个请求自身的 KV 字节数不变。
Q:官方宣传的上下文长度能信吗?
模型能力上可信,显存预算上是两回事。宣传口径说"支持 128K",你的卡得按 25GiB KV(本例)另算,两个数字都看再做决定。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。