
一句话总结:百度开源了 ERNIE-5.5-Flash-Base,280B 总参数、每 token 只激活 14B,33.5 万亿 token 从零预训练,推理支持 1M 上下文。43 层里 37 层用压缩注意力,每 128 个 token 只缓存一条。但它是纯预训练基座——没做中训练和后训练,下载下来不能直接对话,要自己补 SFT 和 RLHF。
昨天有人问我,这个模型能不能直接在本地跑。
我说能跑,但你打开它,它不会跟你说话。
他不信,说他看过跑分,MMLU 93.3,比很多能聊天的模型都高。
问题就在这。跑分高和能对话,是两件事。
一、ERNIE-5.5-Flash-Base 的规格:280B 里只激活 14B
先把参数摆清楚。
| 项目 | 数值 |
|---|---|
| 总参数 | 2800 亿(280B) |
| 每 token 激活 | 140 亿(14B,占 5%) |
| 路由专家 | 512 个,每 token 选 10 个(占 2%) |
| 预训练数据 | 33.5 万亿 token |
| 训练上下文 | 128K |
| 推理上下文 | 1M |
| 层数 | 43 |
| 权重格式 | FP8 与 BF16 两版 |
| 优化器 | Muon |
280B 里激活 5%,这是 MoE 的常规操作。但 512 个专家选 10 个(2%)比常见配置更稀疏——稀疏度越高,同等激活参数下总容量越大,但路由的难度也越大。
跑分(官方自报):
| 基准 | 分数 |
|---|---|
| MMLU | 93.3 |
| MMLU-Pro | 78.4 |
| HumanEval+ | 82.3 |
| MBPP+ | 81.5 |
这组数字放在同尺寸模型里确实靠前。但下面这段才是关键。
二、压缩注意力:43 层里 37 层,每 128 token 存 1 条
长上下文最贵的不是权重,是 KV cache。它随 token 数线性增长,1M 上下文的开销能轻易超过模型本身。
ERNIE 这次的做法是:43 层里,37 层用压缩注意力——每 128 个 token 只缓存一条表示。
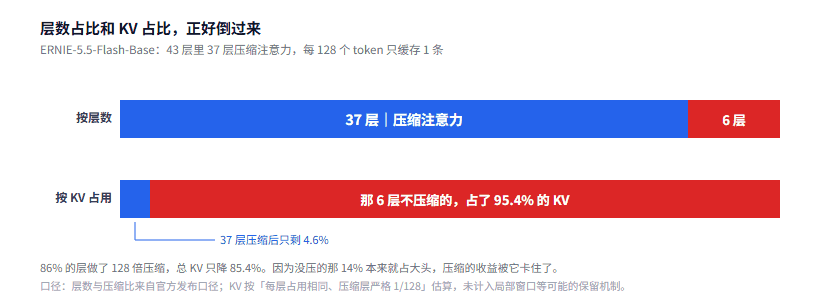
图 1:两根条的颜色分配正好反转,这是我最想让人看到的一处
直觉上,86% 的层压到 1/128,KV 应该省下接近 128 倍。
算完发现只省 85.4%。
压缩层贡献:(37/43) ÷ 128 = 0.67%
不压缩层贡献:(6/43) = 14.0%
合计:14.63%,即省 85.4%原因很简单:那 6 层不压缩的,占了大头。 它们的 KV 是压缩层的 128 倍,所以哪怕只有 6 层,也吃掉了总 KV 的 95.4%。
这个结论有点反直觉,但很重要:压缩注意力不是「无限长上下文」的钥匙,它的收益被未压缩的那几层封顶了。
我猜那 6 层是故意留的。有些层需要完整的注意力精度(比如处理首个 token、处理跨段指代),压了就废。这属于「知道该在哪里不省」的设计。
三、省了 85%,不是 128 倍
这个区别值得单独说。
如果宣传口径写「压缩 128 倍」,听起来像 1M 上下文只花 8K 的钱。但实际省 85%,相当于 1M 的 KV 占用约等于 15 万 token 的普通方案。
85% 已经是很大的节省了(1M 上下文从不可行变成勉强可行),但它和 128 倍不是一个量级的事。
我在27B 那篇算过类似的账:262K 上下文光 KV 就要 48GB。按这个量级推,1M 上下文如果不做压缩,KV 需求在百 GB 级别;压到 15% 之后,才落进 8 卡机器的余量里。
所以这个设计不是锦上添花,是 1M 上下文能不能成立的前提。
四、它是纯基座,下载下来不能聊天
回到开头那个问题。
这次开源的是 Base 版,官方明确说明:纯预训练权重,没有经过中训练(mid-training)和后训练(post-training)。
意味着什么?
- 它没有学过「对话格式」。你输入一句话,它可能接着往下续写,而不是回答你
- 它没有经过指令微调(SFT),不知道「用户指令」和「文档内容」的区别
- 它没有经过 RLHF,不会拒绝,也不会控制语气
用一句话概括:它是个「读完 33.5 万亿 token 的文本预测器」,不是助手。
一个具体的例子。你输入「中国的首都是」,它会输出「北京」。你输入「请告诉我中国的首都是哪里」,它可能输出「请告诉我美国的首都是哪里」——因为它学到的是「续写类似的句子」,不是「回答问题」。
这个坑很深。因为跑分高(MMLU 93.3 是基座模型的零样本成绩),很容易让人以为它已经能用了。
实际上要让它能对话,还得做三件事:
- 中训练:用高质量语料做继续预训练,把分布往「对话」上调
- SFT:用指令-回答对做监督微调
- RLHF/DPO:做偏好对齐
这三步的工作量,不比训练一个小模型少。这和中科大/清华那边给的理由是一样的:基座开源是为了「让别人在上面盖楼」,不是「给你一个成品」。
这一点和 DeepSeek 全栈开源那篇讲的是同一件事:三层都给(权重、训练框架、部署链),但「给全」和「能用」中间还隔着后训练。
五、和 DeepSeek 那几个比,要先补齐后训练
官方说在代码测试上对 DeepSeek-V4-Flash-Base 有优势。
这个对比是「基座对基座」,公平。但对使用者来说没意义——你不会拿两个基座来用,你会拿两个「能对话的模型」来选。
所以这个开源真正的价值在于二次开发:
- 想在自己领域做垂直模型,有 280B 的基座可以微调
- 想研究 MoE 路由和压缩注意力,有完整权重可以拆
- 想省预训练成本(33.5T token 的训练费是天文数字)
不适合的场景:想直接拿来当聊天机器人。
另外权重体积要有心理准备:FP8 是 280GB,BF16 是 560GB。加上 1M 上下文的 KV,这不是一台机器能装下的东西。
六、常见问题
这个模型能商用吗?
要看许可证。报道里没给具体许可条款,我查不到。下载前先去 Hugging Face 页面确认,别默认「开源=可商用」。
Base 和 Chat 版差多远?
差三步训练。具体差多少分,取决于 SFT 数据质量。做得好能接近 Chat 版,做得差会比小模型还笨。
14B 激活是不是意味着 14B 的显存就够?
不是。激活参数决定计算量,不决定显存。权重还是 280B 全量要装(FP8 280GB),只是每个 token 只用其中 14B 参与运算。
压缩注意力会影响效果吗?
理论上会。它把 128 个 token 压成一条表示,细节必然有损。但官方说在长上下文基准上领先,说明损失在可接受范围。具体掉多少,得看独立评测。
国内个人开发者值得下吗?
不值得。280GB 权重、要自己做后训练、要 8 卡级硬件,这三条挡住了绝大部分个人场景。关注它的技术方案(压缩注意力)比下载权重更有用。
七、结语
这个模型最值得看的是那 37/43 的分配,不是 280B 这个数字。
它承认了一件事:不是所有层都能省。 留 6 层不压缩,等于承认「有些地方必须精确」。
这种「知道哪里不能省」的判断,比「全面优化」更能说明工程成熟度。
至于「开源」这两个字,我现在的理解是:它开放的是「可能性」,不是「可用性」。 可能性对做研究的人有价值,对想直接用的没价值。
这个区分,中文语境里经常被模糊掉。
参考资料
- 快科技 - 33.5 万亿 Token 喂出来!百度文心 5.5 Flash Base 正式开源 - 本文参数、跑分、层结构与压缩注意力的主要来源
- 网易 - 百度文心 5.5 Flash Base 正式开源 - 同一发布的技术细节补充,含「纯基座」的明确说明
- Hugging Face - ERNIE 模型页 - 权重、许可与模型卡的原始出处(下载前务必核对许可)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。