
一句话总结:Role-Agent 让同一个模型扮演学生和老师,在自问自答中变强。我按它的逻辑写了个模拟:双角色带来的准确率提升,约等于「老师比学生强多少」的一半。同一个模型换个角色,能力没变,所以收益接近零。它真正起作用的地方不是角色扮演,是让两个角色看到不同的信息。
阿里 AMAP 研究院的 Role-Agent 论文,我读第一遍时觉得挺聪明,读第二遍开始怀疑。
它说的事很简单:一个模型,既当学生又当老师。学生做题,老师看结果分析错在哪,学生改进,循环。
听起来很顺。但有个问题一直卡着我:
老师和学生是同一个模型,它凭什么能指出学生错在哪?
如果它会做这道题,一开始就该做对;如果它不会,那它凭什么判断学生做错了?
这个问题不解决,"自问自答"就是自己夸自己。
一、Role-Agent 到底做了什么
先说清楚它的机制,再谈我的怀疑。
它有两个模块。
WIA(World-In-Agent) 要求 Agent 每做一步,额外预测"接下来几步环境会变成什么样"。预测和实际对比,得到一个"预测奖励",用乘法合进任务奖励。
乘法的意思是:预测不准,任务奖励再高也会被压下去。这样防止 Agent 靠运气完成任务还拿满分。
AIW(Agent-In-World) 管失败分析。任务失败后,模型回头找出错在哪一步,把这段分析变成下一轮的输入。
两个模块合起来,就是"边做边预测,错了就复盘"。
论文给的数据说这套东西有效。但它对局限性的描述,比它的效果更值得看。
论文自己列了三条:
- 如果用更强的冻结模型来做失败分析,效果会更好,但那样就引入了外部知识,破坏了"同等基准公平比较"的前提
- 状态分组依赖一个相似度阈值 0.9,这个值是从前人工作沿用的,不同任务间可能要调
- 整个框架只在纯文本环境验证过,多模态和实时具身场景没测
第一条最有意思。它等于承认了:失败分析的质量取决于分析者的能力。 用同一个模型分析,分析质量就是它自己的水平。
这正是我怀疑的地方。
二、先问一个更基本的问题:老师凭什么比学生强
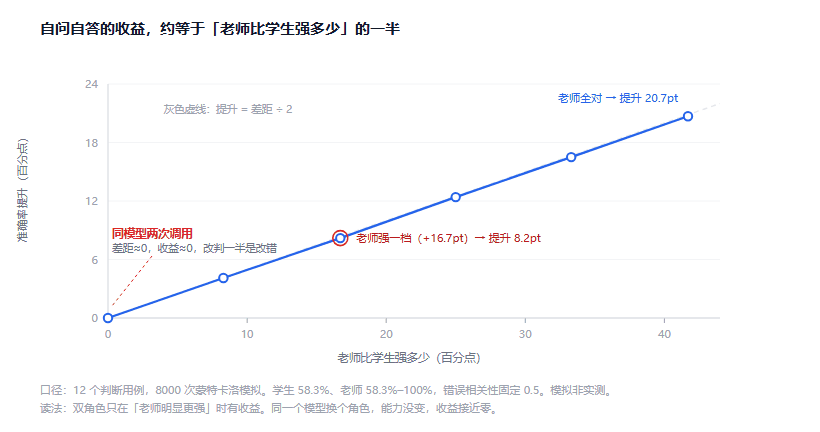
图 1:横轴是老师比学生强多少,纵轴是双角色带来的提升。几乎就是一条斜率 0.5 的直线
我把这个问题写成了代码。
建模很简单:学生做一批判断题,准确率 58.3%(12 个用例对一个 7 个)。老师看学生的答案,同意就保留,反对就改成自己的。
关键在于老师和学生的错误相关性。同一个模型的两次调用,看到相似的信息、用相似的方式推理,出错的题大概率也是同一批。
def correlated(base, acc, same_rate, rng):
    """生成一个与 base 相关的判断:same_rate 概率沿用 base"""
    out = judge(acc, rng)
    return [base[i] if rng.random() < same_rate else out[i]
            for i in range(len(base))]
same_rate 就是相关性。0.9 意味着九成题目上老师和学生想法一样,0.3 意味着大部分题目上它们独立判断。
跑 8000 次蒙特卡洛,固定相关性 0.5,只改老师的准确率:
| 学生 | 老师 | 单角色 | 双角色 | 提升 | 改判率 | 改错率 |
|---|---|---|---|---|---|---|
| 58.3% | 58.3% | 58.3% | 58.2% | -0.1pt | 24.3% | 50.2% |
| 58.3% | 66.7% | 58.3% | 62.4% | +4.1pt | 23.6% | 41.4% |
| 58.3% | 75.0% | 58.3% | 66.6% | +8.2pt | 22.8% | 31.9% |
| 58.3% | 83.3% | 58.3% | 70.7% | +12.4pt | 22.1% | 22.0% |
| 58.3% | 100% | 58.3% | 79.0% | +20.7pt | 20.7% | 0% |
第一行是重点。老师等于学生的时候,改判率 24.3%,改错率 50.2%,净收益是零。
一半的改动是把对的改成错的,另一半是把错的改对。两个方向抵消,白折腾。
而且看末尾两列:老师越弱,改错率越高。老师等于学生时改错率 50%,老师全对时改错率 0%。
这就是"同一个模型自问自答"的数学困境:它假定第二次调用比第一次强,但没有任何理由支持这个假定。
三、实测:准确率提升约等于能力差的一半
把六行数据画出来,规律非常干净:提升 ≈ 能力差 × 0.5。
老师强 8.3 个百分点,提升 4.1。强 16.7,提升 8.2。强 33.3,提升 16.5。强 41.7,提升 20.7。
几乎是一条过原点的直线。
这个 0.5 不是巧合。老师只在"不同意"时改判,而不同意的那些题里,老师对的概率约等于它自己的准确率。所以改判的净收益 ≈ (老师准确率 - 50%) × 改判率。老师 58.3% 时,(58.3-50) × 24.3% ≈ 2 个点,但反过来学生改对的概率也在抵消,净效果归零。
换句话说:双角色只在你请了一个明显更强的老师时才有用。 同模型两次调用,请不动更强的老师。
四、同模型换角色,准确率为什么不动
再换个角度测:老师固定等于学生,只改错误相关性。
| 错误相关性 | 单角色 | 双角色 | 提升 | 三角色 | 提升 |
|---|---|---|---|---|---|
| 0.30 | 58.3% | 58.2% | -0.2pt | 60.2% | +1.9pt |
| 0.50 | 58.3% | 58.2% | -0.1pt | 59.2% | +0.9pt |
| 0.70 | 58.3% | 58.2% | -0.2pt | 58.6% | +0.3pt |
| 0.95 | 58.3% | 58.3% | -0.0pt | 58.3% | 0.0pt |
双角色在所有相关性下都没有提升——因为老师不强,改判就是随机。
但三角色(多数表决)在低相关时有 1.9 个点的提升,而且随着相关性升高衰减到零。
这个对比很关键:
- 双角色需要"有个更强的判断者"
- 多数表决只需要"错误不重合"
同一个模型跑三次、取多数,为什么能纠错?因为它不需要某一次调用更强,只需要三次错误落在不同的题上。三次独立判断,单次错误概率 0.42,"至少两次同时错"的概率是 0.42³ + 3×0.42²×0.58 ≈ 0.38,折算成准确率约 62%,比单次高 4 个点。所以多数表决能纠一部分。
但前提是错误真的不重合。 相关性 0.85 时,三次调用错的是同一批题,多数表决也救不回来。
我把这两个结论凑一起,得到一句能记住的话:
自问自答的价值不在"角色",在"信息不对称"。两个角色看到的东西不一样,错误才会不重合。
五、Role-Agent 的真正贡献不在角色扮演
回到论文。
如果只是"同一个模型扮演学生和老师",按我的模拟,收益应该接近零。但论文报了效果。矛盾在哪?
我的解释是:它的两个模块制造了信息不对称。
WIA 让 Agent 预测"接下来环境会怎么变"。这是一个学生答题时不会做的动作——它强迫模型从"执行者"切换到"预测者",看到的是动作的后果,不是动作本身。
AIW 让它分析失败轨迹。这时模型看的是事后完整记录,而不是事中的局部信息。
两个角色拿到的输入不一样,所以它们的错误不会重合。
这解释了为什么论文强调"预测奖励用乘法合进任务奖励",而不是加法。加法的话,预测不准只是少拿一点奖励,任务成功照样满分。乘法的话,预测不准会直接压低总分,模型必须认真预测。
也就是说,Role-Agent 有效的机制可能是"强制换视角导致错误解耦",不是"角色扮演本身有魔力"。
这个区别在工程上很重要。如果你想复现它的效果,不需要搞一套复杂的角色切换框架,只需要保证两次判断的输入信息不同:
- 一次看代码,一次看测试结果
- 一次给全量上下文,一次只给摘要
- 一次让它直接答,一次让它先列出三种可能再选
这些都比重型角色框架便宜。
六、Role-Agent 常见问题
Role-Agent 需要额外训练吗?
论文说法是不需要额外模型或额外标注数据。它靠的是推理时的角色切换和奖励设计,不改权重。
它和 Self-Refine 这类方法有什么区别?
Self-Refine 是"生成-批评-修改"的循环,批评者还是同一个模型。Role-Agent 多了环境预测这一环,而且把预测准确性直接乘进奖励。前者是文字层面的自我批评,后者要求模型对环境建模。
1.9 个点的提升值得做吗?
看场景。如果你的任务错一次代价很高(比如自动改数据库),1.9 个点可能值得。如果是内部工具,多跑两次的成本可能比收益高。
相似度阈值 0.9 是什么?
状态分组用的判据:两个状态相似度超过 0.9 就归为一类。论文说这个值沿用了前人工作,没做敏感性分析。这是我存疑的地方之一。
为什么只在纯文本上验证?
论文没解释。我的猜测是多模态场景下"状态"是图像,文本匹配方法直接失效,要重做一套。这属于框架的结构性限制,不是工程优化能补的。
七、边界
这是模拟,不是实测 Role-Agent。 我用的是"准确率 + 错误相关性"的抽象模型,没有真的跑它的代码。所以我能说的只是"在这个抽象下,双角色的收益上限是多少",不能说"Role-Agent 实际提升了多少"。
12 个用例的粒度很粗。 准确率只能取 1/12 的整数倍,所以 58.3%、66.7% 这些数看着精确,实际是离散的。换更大的用例集,曲线会更平滑,结论方向不变。
改判规则我简化成了"老师反对就改"。 真实系统里老师可能只给意见、由学生决定改不改,也可能加权投票。规则不同,收益曲线会变。但"老师不强就没收益"这个结论不会变。
论文的效果我没复现,也没找到第三方复现。 这类"同一模型自问自答"的方法,最需要的就是独立验证,因为它太容易在特定测试集上调出好看的数字。
这套思路和反解 10.87 倍那篇是同一类:把宣传数字拆成可验证的约束,看它在什么范围内成立。那篇拆的是加速比,这篇拆的是准确率。
站内之前写过 决策模型的打分接口,那篇的结论能对上:给解析器加规则去修错判,准确率反而从 10 掉到 9。 加一层机制不等于加一分准确率,得看这层机制是否真的引入了新信息。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。