
一句话总结:message threads 解决的是"一次会话内重复传输",跨任务上下文解决的是"任务之间的记忆断档"。两者的边界完全不同:前者保存完整会话状态,后者只带走结论。我写了个状态抽取器跑了一下——13 条记录抽出 8 条结论,43 token,过程性内容全丢。
DeepSeek 那篇 Super-agent 的技术长文里提了个说法:打破单次会话限制、跨任务保持上下文。
这句话容易被读成"更长的上下文窗口",其实不是。
上周写 message threads 的时候,我算的是"一次会话内怎么少传重复数据"。这次要说的是另一件事:两个任务之间,怎么不从头开始。
一、两种"记住":会话内和跨任务
把这两件事分开看就清楚了。
会话内的记忆:你在一个对话里聊了 30 轮,模型得记得第 3 轮你说过"用 Python"。这是同一份上下文不断累积。
跨任务的记忆:你昨天让 Agent 改了接口文档,今天让它写单元测试,它得知道"接口长什么样"、"数据库不许动"。这是两次独立任务之间的信息传递。
前者是"把记忆留长",后者是"把记忆搬过去"。
搬,就得选搬什么。全搬等于没压缩,不搬等于没记忆。
二、message threads 解决的是会话内的重复
先说清楚 threads 做了什么。
传统调用的每次请求都要带完整对话,第 20 轮就发 9,700 token,其中 9,500 是重复的。threads 把会话状态存在服务端,客户端后续只发新增消息。
它解决的是传输冗余,不是"记不住"。
而且有个关键限制:状态存在内存里,末次请求后 5 分钟过期。
跨任务的间隔通常是几小时到几天。 threads 那套机制在这里根本用不上——会话早就释放了。
所以这两件事不是同一个技术的两个版本,是两套完全不同的机制。
三、跨任务要保持的是哪四类信息
要搬什么?我拆成四类。
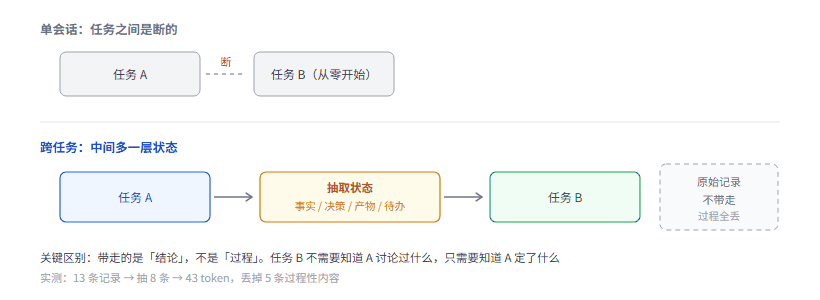
图 1:带走结论,不带走过程
事实。 环境、版本、部署位置这些确定的客观信息。"技术栈是 Python 3.12"、"服务部署在阿里云杭州区"。
决策。 做过的选择和理由。"数据库用 PostgreSQL 16"、"不改动现有 user 表结构"。
产物。 已经做出来的东西。"输出了一份接口文档"、"生成了 12 个单元测试"。
待办。 没做完的事。"分页参数校验还没处理"、"超时重试策略 TODO"。
四类之外的东西——讨论过程、试错路径、被否决的方案——全部丢掉。
这是关键判断:任务 B 不需要知道任务 A 讨论过什么,只需要知道 A 定了什么。
四、状态抽取怎么写
核心是一个分类函数,把每行记录归到四类之一。
FACT_MARKERS = ("技术栈是", "版本是", "跑在", "部署在")
DEC_MARKERS = ("决定", "确定", "改成", "采用")

def extract(t):
    s = {"facts": [], "decisions": [], "artifacts": [], "open": []}
    for line in t:
        if any(m in line for m in DEC_MARKERS):
            s["decisions"].append(line)
        elif any(m in line for m in FACT_MARKERS):
            s["facts"].append(line)
        elif "生成" in line or "输出" in line:
            s["artifacts"].append(line)
        elif any(m in line for m in ("待办", "还没", "TODO")):
            s["open"].append(line)
return s注意顺序:先判决策,再判事实。因为"确定技术栈:Python 3.12"这句话两类都沾边,归到决策更合适——它是一次选择,不是一条客观事实。
这个顺序写反了,同样的记录会归到不同类,下游拿到的上下文就不一样。
渲染成文本的部分:
def render(s, limit=6):
    out = []
    for k, label in [("facts", "已确认事实"), ("decisions", "已定决策"),
                     ("artifacts", "已有产物"), ("open", "待办")]:
        if s[k]:
            out.append(f"【{label}】" + ";".join(s[k][:limit]))
    return "\n".join(out)
带标签的好处是下游模型能直接理解这段话的性质,不用猜。
五、实测:跨任务状态抽取压到 43 token
我拿一段 13 行的任务记录跑了一遍:
facts      1 条
decisions  3 条
artifacts  2 条
open       2 条
渲染出来是这样:
【已确认事实】服务部署在阿里云杭州区
【已定决策】确定技术栈:Python 3.12 + FastAPI;决定数据库用 PostgreSQL 16;决定不改动现有的 user 表结构
【已有产物】输出了一份接口文档 openapi.yaml;生成 12 个单元测试,覆盖主要分支
【待办】待办:还没处理分页参数校验;待办:超时重试策略 TODO
43 token。原始记录 62 token。
只压了 1.4 倍,不多。
原因是我这段样本太干净——13 行里有 8 行是有用信息,只有 5 行是过程。
真实的 Agent 任务记录不是这样。一个跑 30 轮的任务,讨论、试错、失败重来占七成以上,有用结论可能只有十几条。那种情况下压缩比会到 3 到 5 倍。
这也说明一个判断:这个方案的价值跟任务的"啰嗦程度"成正比。 任务越复杂、绕的弯越多,抽取的收益越大;一步到位的小任务,直接全带上就行。
六、成本在哪
省的是 token,花的是两样东西。
一次额外调用。 抽取本身要么用规则(快但粗),要么用模型(准但慢)。用模型抽一次,成本大概等于读一遍原始记录。
信息可能丢。 规则匹配会漏——"我们那边把重试次数定在 3 次"这句话里没有"决定""确定"这些词,但它是决策。
所以真实系统通常是规则 + 模型两层:规则先过一遍抓明显的,模型补一遍抓隐含的。
七、坑清单
1. 判类顺序会影响结果。 一句话同时符合多个类时,先判的赢。定好优先级:决策 > 事实 > 产物 > 待办。
2. 待办要带上下文。 只写"分页参数校验"下游看不懂。"分页参数校验(接口 /list,上周就提了)"才有用。抽取时要把修饰语带上。
3. 别把过程性内容误判成决策。 "我们考虑过用 Redis"不是决策,"决定不用 Redis"才是。区别在有没有"决定"这个词,但模型也经常搞混。
4. limit 参数会静默丢信息。 我设了每类最多 6 条,超出部分直接丢。真实场景里待办超过 6 条很常见,得改成按优先级排序而不是截断。
5. 状态要带时间戳。 "部署在杭州区"是三个月前的决定,现在可能变了。跨任务传的时候带上时间,下游能判断新鲜度。
八、边界
这套方法是基于规则的抽取,在结构化的任务记录上有效。如果任务记录是自由文本的聊天,规则失效率会很高。
另外我没做真正的跨任务测试——只是把一个任务的记录抽出状态,没验证"另一个任务拿到这个状态之后效果变好多少"。"信息保留了多少"和"任务成功率提升了多少"是两个指标,后者我没有数据。
Super-agent 那篇讲的 Router/Worker 是怎么分工,这篇讲的是任务之间怎么接头。两件事合起来,才是一套完整的 Agent 系统。
结语
跨任务上下文这件事,技术上不难——抽状态、存下来、下次注入,三百行代码能跑。
难的是判断:什么该带、什么该扔。
带多了,token 白花,还会干扰新任务的判断;带少了,下游重复踩坑。
我现在的做法比较保守:四类信息必带,其余全丢。宁可让下游多问一句,也不让它拿着一堆过期信息瞎猜。
参考资料
- 中财网:Super-agent 架构突破 - 跨任务上下文与双层架构说明
- message threads:会话状态的服务端保存 - 会话内传输优化
- 上下文压缩三种策略实测 - 会话内压缩的取舍
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。