
一句话总结:混元 Hyra 2.0 用三层 Agent 架构做科研——规划层拆任务、执行层写代码跑实验、复核层判断结果过不过。真正值得看的不是分层本身,是两条规则:复核不过就退回重做,跑成功的步骤沉淀成可复用的 Skill。官方说这是从"单题求解"转向"工具研发"。
AI 做科研这件事,过去两年的形态基本是"给一道题,求一个答案"。
比如给一个蛋白质序列,预测它的结构;给一组实验数据,拟合出一条规律。做完了就结束,下一次换个问题重新来。
Hyra 2.0 想改的是这个模式。
一、Hyra 2.0 做了什么:从解题到造工具
官方对这次升级的描述是:推动 AI 科研从单题求解转向工具研发。
这两个说法的差别在哪,我用一个例子说明。
单题求解:给你一批量子材料的实验数据,帮我找出哪几个参数决定导电性。
工具研发:做一套能自动筛量子材料的方法,以后每来一批新数据都能直接用。
前者产出一个答案,后者产出一套能力。前者的价值随问题结束而消失,后者会累积。
混元说这条路能带来"智能复利"——每一步的成果都成为下一步的基础,而不是每次从零开始。
二、三层 Agent 的分工
架构是三层。
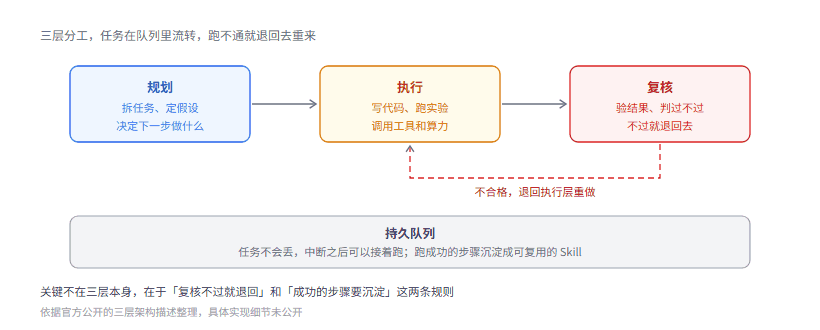
图 1:分层不新鲜,新鲜的是一条虚线——复核不过就退回去
规划层拆任务。把一个研究目标拆成可执行的步骤,决定先做什么、后做什么、哪一步是关键的。
执行层干活。写代码、跑实验、调工具、用算力。这一层是实际产生数据的地方。
复核层判断。实验跑完了,结果对不对?假设成立不成立?不成立就退回去重做。
这三层分开,在 Agent 设计里不算新东西。多个 Agent 分工、互相检查,是现在比较通行的做法。
真正不一样的是那个回退箭头。
三、Hyra 的三层 Agent 怎么保证质量
科研场景里,最怕的不是"做不出来",是"做出来一个看起来对的结果"。
假阳性在科研里代价极高。一个错误的实验结论,可能让团队沿着错方向走半年。
所以复核层的设计比规划层更重要。我理解它的作用是:
- 检验结果是不是统计显著,还是噪声
- 检验实验设计有没有漏洞(比如对照组缺失)
- 检验结论能不能被同一批数据之外的东西支撑
过不了这三关,就退回执行层重做。
这里有个细节我觉得关键:回退是回到执行层,不是回到规划层。 意思是它默认"任务拆得对,只是执行出了问题"。如果回退太频繁,说明规划层本身有问题,那就该整体重来。
另外还有个"持久队列"。任务不会因为一次中断就丢失,可以接着跑。科研实验动辄跑几天,这个设计是必要的。
四、沉淀 Skill 这件事最值得看
三层架构是骨架,真正让"智能复利"成立的是这一条:跑成功的步骤沉淀成可复用的 Skill。
这句话翻译一下:这次为了验证某个假设,摸索出了一套跑分子动力学模拟的流程,包括用什么参数、怎么处理边界条件、结果怎么判断。这套流程如果只服务这一次,用完就散了。
把它存成 Skill,下次遇到同类问题直接调,不用重新摸。
这个思路和 Claude 的 Skill 体系是一回事——Skill 不是给模型知识,是给它"遇到这类事该怎么做"的流程。
区别在于,Claude 的 Skill 是人写的,Hyra 这个是 Agent 自己跑出来的。自己总结出来的流程,比人写的更贴合实际执行细节。
这也是我认为这件事有想象空间的地方。如果 Agent 能在每个领域都沉淀出一批 Skill,那它的能力会随着使用次数增长,而不是停在一个固定水平。
五、七大方向的科研成果要打折看
官方说覆盖了七大前沿方向,蛋白质、量子、芯片等都有突破。
这部分我建议打折看,原因有三个:
一是自报数据没有第三方复现。 官方描述里也承认"稳定性和跨领域泛化仍需长期检验"。
二是"突破"的定义模糊。 在科研语境里,跑出一个有意思的结果和做出一项能发表的成果,中间隔着很远。
三是七个方向同时有成果,本身就值得怀疑。 一个团队如果同时在七个前沿领域都拿到突破,那要么是这些"突破"的门槛不高,要么是判断标准比较宽。
我的判断是:架构设计值得学,具体成果等论文。
六、常见问题
Hyra 2.0 是模型还是框架?
从描述看是一套 Agent 系统,底层可能调用混元系列模型。它本身更像框架。
能用来做什么方向的科研?
官方说七大方向,包括蛋白质、量子、芯片。具体能力边界要看能不能拿到实测数据。
和自己搭 Agent 有什么区别?
自己搭也能实现三层分工,但"沉淀 Skill"和"持久队列"这两块要自己写。Hyra 是打包好的。
会开源吗?
没有消息。混元系列有开源传统,但这套系统涉及大量工程实现,开不开源不好说。
普通开发者能用吗?
从描述看是面向科研机构的。个人开发者可能暂时接触不到。
结语
这件事的意义不在"AI 又能做科研了"——那个已经说了两年。
在于它换了目标:不再追求单次任务的正确率,追求的是每一轮之后系统本身变强了多少。
这个思路对不对,得看它沉淀出来的 Skill 到底能不能复用。如果三个月后那些 Skill 还是只能在原场景用,那"智能复利"就只是个说法。
三者配合那篇讲过 Skill、Command、Subagent 怎么分工。Hyra 算是把这个组合自动化了——连 Skill 都是自己写的。
参考资料
- 腾讯新闻 AI 日报 2026-11-03 - Hyra 2.0 发布信息与三层架构描述
- 腾讯混元 - 官方产品信息
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。