
一句话总结:Hyper-Agent 把 Agent 从会话里拽出来,让它常驻,会话降级成工作队列。我复刻了一遍:一个 Agent 挂三个群交替发消息,上下文零串味;挂 20 个群、400 条历史,单轮装配还是 31 token。真正难的不是存状态,是划清哪部分该共享、哪部分该隔离。
以前做 IM 机器人,架构都长一个样:一个群一个实例。
群里来人提问,起一个进程;群没人说话,进程等着;会话结束,状态清空。想让它记住上周说过的事?自己存数据库。
这套做法在单群场景够用,一上规模就露馅:20 个群就是 20 个进程,20 份重复的 prompt,20 次重复的加载。改一条规则要重启 20 次。
openJiuwen 的 Hyper-Agent 给的是另一个答案:Agent 常驻,会话是它手上的活。
一、Hyper-Agent 改了什么:从管会话到管智能体
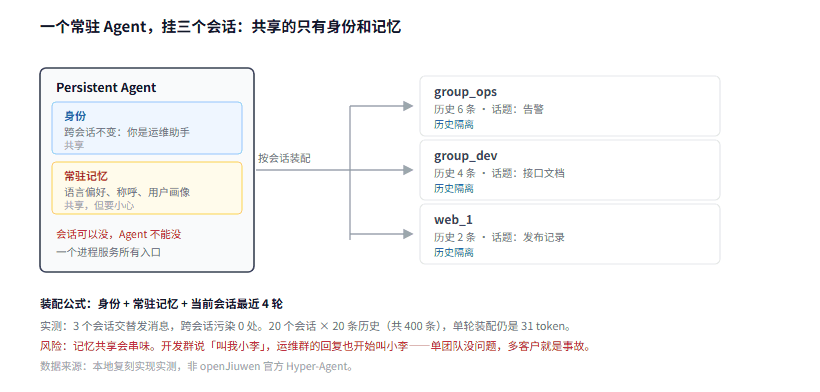
图 1:左边是常驻的 Agent,右边是它接的活。会话结束,Agent 还在
它的设计重心从"会话"挪到了"智能体"。
具体的变化有三处:
第一,Agent 有独立身份,不附着于会话。 一个 Persistent Agent 可以接多个 IM 群,持续跟进不同的事,同时和其他 Agent 协作。它保留自己的身份和状态,各会话分别保存上下文和进度。
第二,会话降级成调度资源。 系统负责分配、并发调度、上下文接续。Agent 不再关心"我在哪个会话里",只关心"我手上有哪些活"。
第三,支持跨群交付。 从一个渠道接需求,向另一个渠道交结果。
架构上分了三层:Gateway 统一接入 IM 和 Web UI,AgentServer 调度 Agent 和会话,SwarmEngine 管群聊里的多方协作(人、永续智能体、专家、专家团在同一个群对齐任务)。
材料里有个说法我觉得挺准:把设计重心从会话转向智能体本身,让 Agent 以"数字员工"的形态进入真实的工作群。
数字员工这个比喻,比"助手"准确。助手是按次服务的,员工是长期在岗的。
二、我复刻了一遍:常驻 Agent 加多会话队列
核心就两个类。
会话只存自己的历史,绝不跨会话取:
@dataclass
class Session:
    sid: str
    channel: str
    history: list = field(default_factory=list)

    def context(self, limit: int = 4) -> str:
        """只取本会话最近几轮,绝不跨会话"""
        tail = self.history[-limit:]
        return "\n".join(f"{m['role']}: {m['text']}" for m in tail)
Agent 持有身份、常驻记忆和一堆会话:
@dataclass
class PersistentAgent:
    aid: str
    name: str
    identity: str                          # 跨会话不变
    memory: dict = field(default_factory=dict)   # 跨会话共享
    sessions: dict = field(default_factory=dict) # sid -> Session

    def assemble(self, sid: str) -> str:
        """装配本轮上下文:身份 + 常驻记忆 + 本会话历史"""
        s = self.sessions[sid]
        mem = "\n".join(f"- {k}: {v}" for k, v in self.memory.items())
        return f"[身份]\n{self.identity}\n[常驻记忆]\n{mem}\n[当前会话 {sid}]\n{s.context()}"
assemble 这个方法是整个设计的关键。它决定了哪部分共享(身份、记忆)、哪部分隔离(历史)。
这一行代码的位置,就是解耦的核心。
三、多会话串味检查:三个群交替发消息
跑起来是这样。一个 Agent 挂三个群:运维群、开发群、网页会话。
交替发六条消息,模拟真实的工作节奏:
group_ops   <- 线上 CPU 告警了,看一下
group_dev   <- 接口文档更新了吗
group_ops   <- 用中文回复我
web_1       <- 帮我查一下昨天的发布记录
group_dev   <- 叫我小李就行
group_ops   <- 告警恢复了吗
然后检查每个会话的历史里有没有混进别人的话题:
group_ops   历史 6 条,包含话题 ['告警'],跨会话污染 无
group_dev   历史 4 条,包含话题 ['接口文档'],跨会话污染 无
web_1       历史 2 条,包含话题 ['发布记录'],跨会话污染 无
零污染。
原因很简单:context() 只从 self.history 取,而 history 是每个 Session 自己的。装配时拼的是"Agent 的共享部分 + 当前 Session 的私有部分",没有别的入口。
多会话架构里最常见的 bug 就是在这里:图省事,把所有历史塞进一个全局 list,然后按 session_id 过滤。 过滤条件写错一次,A 群的敏感信息就跑到 B 群去了。
四、Session 的边界:什么该共享、什么该隔离
这部分是我做完实验后改主意的地方。
一开始我以为"记忆共享"是纯优点。跑完发现它有代价。
看这个测试:开发群里有人说"叫我小李就行"。下一条运维群的消息进来,Agent 的回复是:
[group_ops] 收到「告警恢复了吗」。上下文 214 字符,历史 5 条。 记忆:中文,称呼:小李称呼跨群生效了。
在"一个 Agent 服务一个团队"的前提下,这是对的。在"一个 Agent 服务多个客户"的前提下,这是事故。
所以这条线不能一刀切。我现在的判断是:
| 内容 | 该共享还是隔离 | 理由 |
|---|---|---|
| 身份定位(你是谁) | 共享 | 换群不该换人格 |
| 语言偏好 | 共享 | 同一个人格的语言习惯 |
| 用户称呼 | 看情况 | 单团队共享,多客户必须隔离 |
| 业务事实(服务名、环境) | 隔离 | 不同群的业务上下文不通用 |
| 对话历史 | 隔离 | 这是底线 |
材料里提到"各会话分别保存上下文与进度",说明官方也是这个思路。但它没讲共享部分怎么管。这部分在实际使用中一定会踩坑。
五、20 个多会话并行,单轮成本没变
这项我单独测了,因为它是这套架构能不能规模化的问题。
造 20 个会话,每个塞 20 条历史,合计 400 条:
会话数 20,每会话 20 条历史,合计 400 条
单会话装配 127–131 字符(31–32 token)
全部历史在内存里约 16000 字节
单轮装配成本 31 token,和只有 3 个会话时一样。
原因在 context(limit=4) 这个参数:装配只取最近 4 轮。历史再多,进上下文的就那 4 轮。
这一条很重要。如果按"全量历史拼进上下文"的做法,20 个会话跑一天,上下文能涨到几万 token,成本直接失控。
但代价是旧信息会丢。第 5 轮之前的对话不进上下文了,只留在磁盘上。
所以这套架构必须配一个"从历史里捞关键信息"的机制——这正是我上一篇写的 PenguinHarness 文件化 能补上的:常驻记忆用文件存,装配时按需读,不占常驻上下文。
两个设计凑一起才完整:Hyper-Agent 解决"谁在干活",文件化解决"记在哪"。
六、Hyper-Agent 常见问题
Hyper-Agent 和普通的 Agent 框架有什么区别?
普通框架里 Agent 是会话的附属品,会话没了 Agent 就没了。Hyper-Agent 里 Agent 是主体,会话是它接的活。这个反转决定了状态该往哪存。
一个 Agent 能接多少个会话?
理论上不设限,实际上受内存和调度能力约束。我测的 20 个会话、400 条历史只占 16KB,瓶颈不在存储,在并发调度的实现质量。
跨群交付是怎么实现的?
按材料的说法,Agent 从一个渠道接需求,按需向另一个渠道交付结果。实现上就是把"输出目标"和"输入来源"解耦,写的时候指定 channel。
和 DeepSeek Harness 那类架构什么关系?
材料自己提到"与 DeepSeek Harness 等业界超级智能体架构的探索形成了呼应"。共同点都是让 Agent 摆脱单次会话限制,差异在于 openJiuwen 更强调团队协作——多个 Agent 在同一个群里分工。
适合什么场景?
多群运维、客服分流、跨部门协作这类"一个人要同时盯着好几个入口"的场景。单群单任务的场景用不上,反而增加复杂度。
七、边界
我只复刻了调度骨架,没做并发和持久化。 真实系统里 20 个群同时来消息是并发处理的,我用的是顺序循环。并发下共享记忆会有竞态条件——两个会话同时写 memory,后写的覆盖先写的。这个风险我知道,没测。
"零串味"是我这个实现的结论,不代表所有实现。 只要有人图省事把历史塞全局,一样会串。
跨群交付、SwarmEngine 多方协作这些我没实现。 材料里只有描述,没有接口细节,硬写会变成编造。
Hyper-Agent 本身我没跑。 所有分析基于公开报道和我自己写的复刻版。它的实际调度策略、失败重试、上下文接续精度,都需要看代码才能判断。
站内另有一篇讲跨任务上下文怎么抽取,那篇解决的是"换任务时带什么走",这篇解决的是"多个任务并行时怎么不打架"。两篇合起来是上下文管理的两个方向。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。