
一句话总结:我拿一个 30 轮、3122 token、含 3 条硬约束的会话测了三种压缩策略。滑动窗口压到 833 token 但丢了 2 条约束;全文摘要压到 106 token 保留 2 条(按 30% 漏检模拟);分层压缩 1146 token,一条不丢。省 token 和保信息是两条相反的路,分层是唯一在现实条件下稳的。
Grok Build 0.2.60 的那次更新,把三件事列为重点:会话恢复、上下文压缩、MCP 工具输出。
前两件其实是同一件事的两面——压缩是为了让会话活得更久,恢复是为了让活下来的会话能接着用。
我拿一个典型场景测了一下:一个编码 Agent 跑 30 轮,中途定下 3 条硬约束,怎么压才不丢。
一、先看三种上下文压缩策略差在哪
滑动窗口。 只保留最近 N 轮,更早的直接扔掉。实现最简单,成本最低。
全文摘要。 把整个会话压成一段话。token 省得最多,但摘要器会漏东西。
分层压缩。 硬约束原样保留,最近几轮原样保留,中间无关紧要的部分压成一句。
三种策略的差别不在算法复杂度,在"丢什么"。
滑动窗口按时间丢——它假设越早的内容越不重要。这个假设在编码任务里经常不成立:第 3 轮定的技术选型,到第 30 轮还在约束你。
摘要按重要性丢——它假设摘要器能判断什么重要。这个假设依赖摘要器的质量,而摘要器本身是个模型,也会出错。
分层不丢硬约束,只丢"过程"。它假设你能识别出什么是硬约束。
二、实测:833 和 1146 的 token 差别
测试设定:30 轮对话,共 3122 token,其中 3 轮含硬约束:
- 第 3 轮:用 Python 写
- 第 12 轮:不准改数据库 schema
- 第 25 轮:目标是下午 5 点前上线
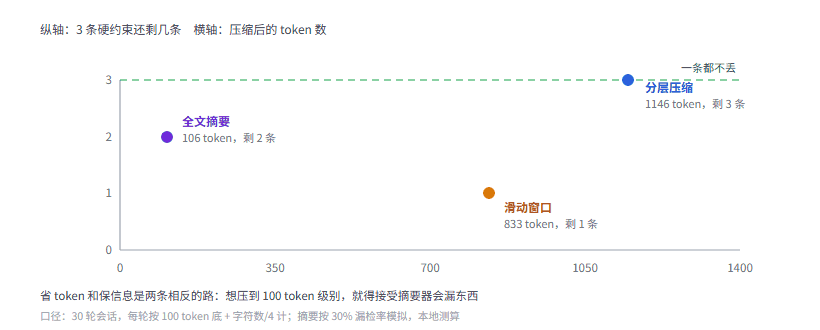
图 1:横轴往右是花更多 token,纵轴往上是不丢约束,三个点各占一角
结果:
| 策略 | 压缩后 token | 压缩率 | 硬约束保留 |
|---|---|---|---|
| 滑动窗口(留 8 轮) | 833 | 26.6% | 1/3 |
| 全文摘要(30% 漏检) | 106 | 3.4% | 2/3 |
| 分层压缩 | 1146 | 36.7% | 3/3 |
滑动窗口只留住了第 25 轮那条(因为它落在最近 8 轮里),前面两条全丢。
摘要丢了一条,因为我按 30% 漏检率模拟——真实的摘要器漏检率不好说,可能更低也可能更高。
分层一条不丢,代价是 token 只压到 36.7%。
这个 36.7% 看着不划算,但它保住了最关键的东西。 一个丢掉了"不准改数据库"的 Agent,后面可能真的去改数据库。
三、分层上下文压缩怎么实现
核心是"分类",不是"压缩"。你得先能判断哪些轮次是硬约束。
def is_hard_constraint(turn: dict) -> bool:
    """判断一轮是不是硬约束。真实实现用模型分类,这里用规则演示"""
    markers = ("不准", "必须", "不要", "只能", "截止", "目标")
    return any(m in turn["text"] for m in markers)


def compact(turns: list[dict], keep_recent: int = 8) -> list[dict]:
    recent = turns[-keep_recent:]
    recent_idx = {t["n"] for t in recent}

    # 关键点:已经在最近 N 轮里的,不要再算进 keys,否则会被重复计入
    keys = [t for t in turns
            if (t.get("hard") or is_hard_constraint(t))
            and t["n"] not in recent_idx]

    middle = [t for t in turns
              if t not in keys and t not in recent]
    if middle:
        summary = {
            "n": 0,
            "text": f"中间 {len(middle)} 轮讨论实现细节,无新硬约束",
            "is_summary": True,
        }
    else:
        summary = None

    out = keys + ([summary] if summary else []) + recent
    return sorted(out, key=lambda t: t["n"])
跑这 30 轮,输出是:
3 条硬约束原样保留
1 条摘要(覆盖 19 轮)
最近 8 轮原样保留
合计 1146 token
关键是 keys 那一步。它决定了压缩的上限——识别不出来的约束,再好的压缩策略也保不住。
实际产品里这一步通常交给模型做,判断"这轮说话是不是在定规矩"。规则匹配只能兜底。
四、会话恢复比压缩更难
Grok Build 把"会话恢复"和"上下文压缩"并列,但我觉得后者比前者简单。
压缩是"把长的变短",纯计算问题。
恢复是"把停下的状态接上",涉及状态一致性。难在哪:
一是压缩必须可逆到"够用"。 恢复之后 Agent 要能接着干,它不需要知道第 15 轮聊了什么,但必须知道那 3 条约束。所以压缩时丢的东西,必须是恢复时用不上的。
二是工具调用状态要单独存。 会话里不只有文本,还有"调用了什么工具、返回了什么、哪个还没完成"。这些状态压缩不掉,得序列化。
三是恢复点要能对齐检查点。 如果恢复时 Agent 正做到一半(比如改了一半文件),得知道从哪继续。这要求每次改动前记快照。
第三点最容易出 bug。代码库健康度那篇讲的"状态复杂"就是这个意思——代码库的状态不是几个变量能描述的。
五、坑清单
1. 关键轮可能和"最近 N 轮"重叠,重了就会重复计入。 我第一次写的时候没做去重,第 25 轮的约束既在 keys 里又在 recent 里,算出来 4 条约束、1251 token。真实场景里这个 bug 不会报错,只会让 token 数字虚高。
2. 硬约束的识别不能只靠关键词。 上面那段代码是演示用的,真实场景里"尽量别动那个文件"也是约束,但不含任何标记词。要靠模型判断。
3. 压缩之后要重算 token。 按字符估 token 会有偏差,尤其是中英混排。压缩后必须用真实 tokenizer 数一遍,否则你以为压到 1200,实际是 1800。
4. 摘要里要保留原始轮次编号。 不然恢复时顺序会乱,Agent 可能以为约束是后来才定的。
5. 别在压缩后再压缩。 多轮压缩会累积信息损耗,第二遍摘要会把第一遍的细节再模糊一层。要么一次性压到位,要么保留原始会话做冷备。
6. 恢复后第一件事是确认状态。 让 Agent 复述一遍当前的约束和进度,比直接让它接着干安全。
六、边界
这组数字是本地模拟的,摘要的漏检率(30%)是我拍的,不是实测。
真实的压缩效果取决于三件事:模型识别硬约束的准确率、摘要器的质量、任务本身的信息密度。任务越"无状态"(比如纯问答),压缩越容易;任务越"有状态"(比如改代码),越难。
另外我只测了文本轮次,没有测工具调用的结果。实际会话里工具返回的内容往往占大头,压缩它们需要另外的策略(比如只留关键字段、丢掉冗余日志)。
结语
选哪种策略,看一个判断:丢了会不会出事。
丢了没事,用滑动窗口,最省。
丢了会出事但能接受偶尔漏,用摘要。
丢了绝对不能接受,用分层。
分层压不到 40%,这是它的成本。但这个成本比"Agent 改错数据库"便宜太多。
参考资料
- Grok Build 0.2.60 更新说明 - 会话恢复、上下文压缩、MCP 工具输出三项优化
- message threads:长会话的另一种解法 - 服务端保存会话状态
- Anthropic 上下文工程指南 - 上下文管理通用实践
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。