
一句话总结:Google Cloud AI 把 85 个"持照工程师愿意签收"的工程交付任务做成基准,七个 agent 框架里最好的配置平均只拿到 50.6%,每个任务烧掉 2700 万 token、耗时 63 分钟。
一个做结构设计的朋友看完这个基准的样例任务,说了一句很到位的话:这些活儿我会做,但我不敢让机器替我签字。
这句话正好是这个基准的题眼。它不是问 AI 懂不懂工程,是问 AI 交出来的东西,有没有人敢签字。
PLE 测的是「能不能签收」
PLE 全称 Physical-Engineering's Last Exam,Google Cloud AI Research 出品。85 个长周期 agent 任务,覆盖电气、土木、结构、机械四个方向。
任务的要求写得很硬:要能跨多格式的项目资料建模物理规律和规范条款,要优化材料与安装成本,要产出"持照审核人会签字的 2D/3D 设计包"。
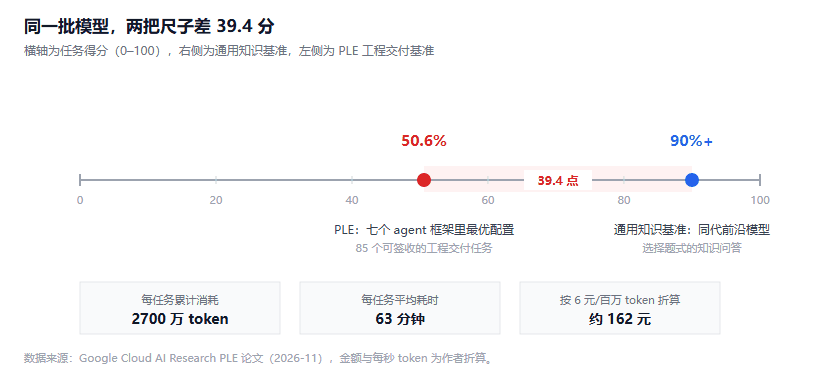
图 1:横轴为任务得分(0–100)。前沿模型在通用知识基准上已过 90 分,在 PLE 上均值 50.6 分,中间约 40 分的差距来自"交付物能不能签收"。数据来源:Google Cloud AI Research PLE 论文
这个设计把评分标准从"答案对不对"换成了"东西能不能用"。两者的距离比想象中大。
论文里有一句对比:前沿语言模型在流行知识基准上已经超过 90%,但在模拟真实计费工程工作的任务上过不了 51%。
PLE 的任务是怎么造出来的
两条造题路径,值得拆开看。
一条是专家出题:由执业工程师写,保证任务在专业上站得住。另一条叫 Co-Authored,用一个"创作者—解题者"的对抗流水线生成:先让一个 agent 出题,再让另一个 agent 去解,解出来了就把难度加大,最后过专家校验。
第二条路径的用意很清楚。人工出题贵,而且高手出的题往往"太规矩"。用对抗方式刷出来的题,难度会自然爬到当前模型的能力边缘。
85 个任务里,29 个公开,56 个留作竞赛榜单的私有集。公开部分连同 grader 和 agent harness 一起放出。
PLE 的 50.6 分是怎么测出来的
七个公开可用的 agent 框架都跑了一遍,取每个任务的平均分,最好的那个配置拿到 50.6%。
关键是代价:每个任务平均消耗 2700 万 token、63 分钟。
这两个数放在一起看才有意思。63 分钟 2700 万 token,折下来是每秒 7143 token。单条推理流跑不到这个速度,差着一到两个数量级。
所以这 2700 万里绝大部分不是模型生成的,是 agent 循环里反复重读的上下文。按每轮重读 20 万 token 算,2700 万相当于 135 轮;63 分钟摊下来,每轮 28 秒。
这个数字比 50.6% 更能说明当前 agent 的形态:它不是"想一次想明白",是"反复看、反复改、反复验证"。真人的设计流程也长这样,只是真人看图纸的速度比 agent 快得多,而且不会在第三十轮把前面的约束忘掉。
按 6 元/百万 token 的输入价折算,一个任务 162 元。听着不贵。但这是"平均",跑完 85 个任务要 23 亿 token。
为什么工程交付比写代码难
代码有个天然优势:能跑。跑不起来就是错,跑起来至少过了一关。
工程交付物没有这个特权。一张结构图对不对,要看荷载路径、要看规范条款、要看施工可行性、要看成本,还要看画得清不清楚。这些东西没有一个编译器能替你判定。
PLE 的 grader 是可执行的,但它比对的是"参考交付物",不是"跑通"。这意味着评分对格式、对细节的容错很低。
论文里点出的三项能力,恰好是当前 agent 最弱的三项:
- 跨多格式资料建模物理约束(规范是 PDF,图纸是 DWG,参数在 Excel 里)
- 在材料与安装成本之间做优化(这是多目标,没有唯一解)
- 产出审核人能签字的成品(这是格式与完整性问题,不是智力问题)
第三项最容易被低估。一个 agent 算出正确答案但画了一张标注不全的图,在计费场景里等于零。
另一边:RWE-Bench 想把它变成训练场
同一个月,Xplore AI 发布了 Real World Engineering Bench,20 个任务,机械、电气、航空三个方向,每个任务用基于物理的 verifier 自动评分。
和 PLE 的区别在定位。PLE 是考卷,RWE-Bench 想做训练场——它背后是强化学习的思路:模型在有可验证奖励的领域里学得最快,代码和数学就是这样被啃下来的。
Xplore AI 的判断是:工程领域的训练数据不在公开仓库里,而在公司内部和资深工程师脑子里。所以要做的是高保真的 RL 环境,不是又一个排行榜。
Lightspeed 投了这家公司,公开发言里的那句"物理工程已经成为可验证强化学习的主要前沿"值得记一下。资本判断和基准发布撞在同一个月,通常不是巧合。
这条路线如果成立,PLE 今天的 50.6% 就是明年的及格线。但 RL 环境造起来比考卷慢得多——考卷只要有人会做,环境要求每个任务都能自动判分。
从漏洞挖掘那边看,差距在哪
AI 在软件缺陷上已经能出活了。前阵子有个公开的账单:GPT-6 在一个安全项目里跑出 1724 个漏洞,其中 948 个成功提权,折下来 1279 美元一个提权,这笔账我拆过一遍。软件领域能这么算,因为"成功提权"是个二值结果,机器自己就能判。
工程交付没有这个二值结果。你能算出"这份图纸能不能签收"吗?只有持照工程师能。
所以两个领域的进展速度会长期不一致。软件侧已经在讨论"每个漏洞多少钱",工程侧还在讨论"能不能过 51 分"。
顺带说一句,从公开账单反推流水线的方法也有边界,那次我试过,四个未知数只能解出三个。PLE 这种只公布均值和总消耗的论文,能反推的空间更小。
关于 PLE 的五个问题
50.6% 是什么口径? 七个 agent harness 里最优配置的任务均分,不是通过率。均值意味着部分任务得分很高、部分接近零。
为什么只公开 29 个任务? 防污染。私有集 56 个留给竞赛榜单,避免题目进入训练数据。
63 分钟是硬限制吗? 不是限制,是观测到的平均耗时。任务的复杂度决定了它快不了。
这个分数能说明 AI 不能做工程设计吗? 不能。它说明当前 agent 配置下,端到端交付还不到可签收的水平。拆开做单点任务(算荷载、查规范)的表现会好得多。
RWE-Bench 和 PLE 哪个更重要? 短期看 PLE,因为它给出了公开的分数坐标。长期看 RWE-Bench 这类环境,因为训练信号比考卷更能推动能力上位。
结语
50.6 这个数字不好看,但它诚实。它测的不是模型聪不聪明,是交付物能不能过审。
对做 agent 产品的人来说,这份基准最有用的部分不是分数,是那个 2700 万 token 和 63 分钟。它给出了一个真实的任务成本量级:一次专业级交付,按现在的架构要烧掉两块多钱的 token 乘以 60 多倍,加上一小时。
如果你的产品声称能替代专业人士,先把这两个数对上。对不上,说明你测的是另一个任务。
参考资料
- Physical Engineering Benchmarks Expose 50% Ceiling for Strongest AI Agents(The Agent Times)
- AI 资讯日报 2026 年 11 月 6 日:三机构同日补齐评测基准(CSDN DevPress)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。