
一句话总结:混元 Hy4 把 770B 总参数压成 49B 激活,价格与预览版持平,真正改变账本的是缓存命中 0.3 元/百万 token 这一行——它是输入价的二十分之一,但只对"重复读同一段上下文"的调用有效。
11 月 4 日晚上,一个做投研工具的朋友把 Hy4 的价目表截了半张图发我,只圈了一行:缓存命中 0.3。他问这是不是印错了,因为同一张表里输入是 6 元。
没印错。0.3 是 6 的二十分之一。这一行决定了你在这个模型上能跑什么形态的产品,也决定了哪些场景根本用不上它。
混元 Hy4 的 770B 是怎么压成 49B 的
官方给的数字是总参数 770B、单次激活 49B,稀疏度 15.7 倍。混合专家的老套路,896 个专家里选 16 个,另外挂 2 个共享专家。这套结构第一次出现在混元系列上是 Hy3,Hy4 把它推到了 770B 这个量级。
从 8 月底的 preview 到正式版,扩的是预训练和后训练规模,架构没换。真正新增的是两个能力:视觉理解,和电脑操作。
视觉这块,腾讯在演示里放的两个任务比较能说明边界。一是在 28 亿像素的航拍图里定位约 2 米大小的屋顶构件;二是把 900 片拼图重组回莫奈的《博尔迪盖拉》。前一个考的是在巨图里保住细节,后一个考的是空间关系推理。两个任务都不靠"看图说话",靠的是把图切块、逐块判断、再把结论拼回去。
电脑操作这块,官方明确说针对 Blender、CAD 这类专业软件做过专项训练,能结合命令行和图形界面。这一点比"能点鼠标"重要得多——大部分 Computer Use 的演示停在网页表单,专业软件里的状态判断难一个量级。
混元 Hy4 的规格和价格:一张表
| 维度 | Hy4 正式版 |
|---|---|
| 架构 | MoE,总参数 770B,激活 49B |
| 上下文 | 约 100 万 token(TokenHub 侧最大输入 960K、最大输出 64K) |
| 新增能力 | 视觉理解、Computer Use(GUI + CLI) |
| 输入价 | 6 元 / 百万 token |
| 输出价 | 18 元 / 百万 token |
| 缓存命中 | 0.3 元 / 百万 token |
| 优惠 | TokenHub 刊例价 5 折,至 2026-12-31 |
| 开源 | 权重近期开源,同步发系统卡片 |
价格结构和 preview 完全一致,没有涨。上下文从"支持长文"变成可以写进合同的 960K 输入上限,这个变化对做文档流水线的人有实际意义——之前 1M 是个宣传数字,现在是接口参数。
缓存命中 0.3 元,省在哪一分钱
我把四种典型调用方式都算了一遍,按官方价目表,不含折扣。
| 场景 | 输入/输出 | 缓存命中 | 无缓存成本 | 有缓存成本 | 省 |
|---|---|---|---|---|---|
| 短对话 | 1K / 0.8K | 0 | 0.0204 元 | 0.0204 元 | 0% |
| 缓存型 agent 单轮 | 20K / 2K | 18K | 0.1560 元 | 0.0534 元 | 65.8% |
| 长文摘要 | 100K / 2K | 90K | 0.6360 元 | 0.1230 元 | 80.7% |
| 输出密集 | 1K / 20K | 0 | 0.3660 元 | 0.3660 元 | 0% |
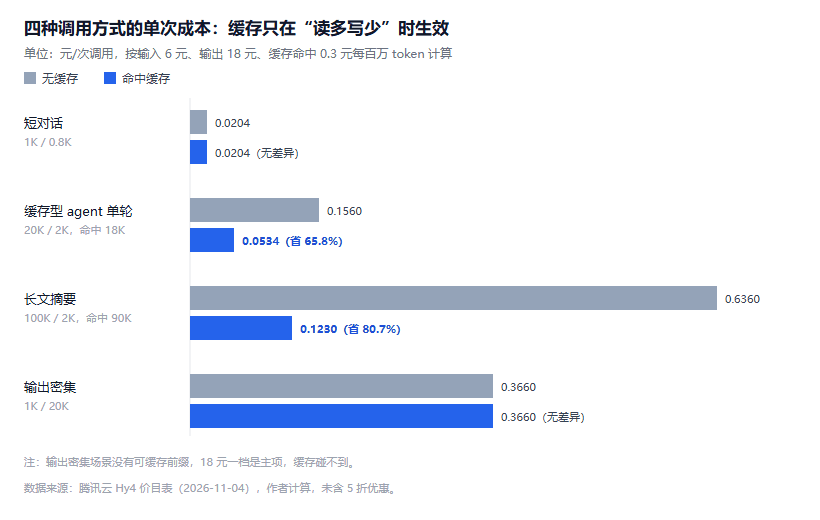
图 1:按 6/18/0.3 元每百万 token 计算,五折列按官方优惠价折算。数据来源:腾讯云 Hy4 价目表,作者计算
第三行是长文摘要,省 80.7%。因为你每次只改末尾几百字,前面九万字的 KV 都能命中缓存。这是缓存设计最舒服的场景,也是最容易被误认为"所有 agent 都省 66%"的场景。
第四行是反例,也是我一开始判断错的地方。
我原本以为 agent 场景一定吃满缓存红利。后来把一次真实的工具调用链拆开看:一轮输入 20K、输出 2K,看着很适合缓存。但如果这个 agent 的主要开销在生成——写代码、写长报告、连续输出结构化 JSON——那 18 元那一档才是主项,缓存碰不到它。输出密集型的调用,缓存命中率再高也省不动。
所以那句"缓存把成本砍了 66%",只对"读多写少"的调用成立。反过来,如果你的产品是代码生成,Hy4 的账要和别的模型按输出价重新比一遍。
按一个月 2000 次缓存型调用算,成本是 106.8 元;不走缓存是 312 元。差出来的 205 元不多,但这是同一件事的两种实现方式之间的差,不是砍价砍出来的。
幻觉率 12.95% 到 7.2%,省下来的是重试
腾讯自建测试里给了两个数:幻觉率从 preview 的 12.95% 降到 7.2%,因猜测导致的错误率从 23.1% 降到 5.6%。
第二个数降得更狠,接近四倍。这两个指标不是一回事。幻觉率是"说了不存在的东西",猜测错误率是"不知道但硬答"。降后者靠的是让模型学会说不知道,这在金融和法务场景里比提升准确率更值钱——因为下游流程通常能处理"拒答",处理不了"编得像真的"。
换算成钱要看你的重试策略。一次错的调用,在 agent 里往往触发整条链重跑。按前面 0.156 元一轮算,重跑三次就是 0.47 元,比省下来的缓存钱多得多。所以对 agent 产品,7.2% 这个数比 0.3 元那个数更值得记。
金融盲测 3.04 分,只领先 0.07
腾讯联合 213 位专家做了 579 项真实任务的盲测,Hy4 综合 3.04 分,同场比较里排开源第一。
第二到第四名分别是 DeepSeek-V4.1-Flash 的 2.97 分,Kimi K3.1 Pro 和 GLM-5.3 各 2.68 分。
3.04 对 2.97,差 0.07。在一个 5 分制上,这是 1.4% 的差距。样本是 579 项任务、213 位评审,这个差距在统计上未必站得住。我更愿意把它读成"这三家在一个水平线上,另外两家低半档",而不是"混元第一"。
同一批数据里更有信息量的是分布:12 项办公场景测试,Hy4 有 9 项国内第一,平均 83.18 分,任务通过率 96.15%。通过率比均分有用——96.15% 意味着 100 次里失败不到 4 次,这个量级才敢放进自动流程。
混元 Hy4 自己说的短板
混元团队的原话是与顶尖闭源模型"仍有较大差距",点名的三个方向是前沿数学、长程开发、视觉问答。
厂商主动列短板这件事本身值得记一笔,因为它给出了这张价目表的定位:770B、6 元输入,对标的是"用得起的第一梯队",不是"最强"。
安全侧的说法也具体:训练时剔除了攻击性网络安全数据,内部实验室审计了加密逆向、漏洞利用方向,结论是未展现突出的进攻性能力;生物安全方面,"把知识转化为可执行实验方案的能力仍然有限"。这两句都有边界词,读的时候别当成"没有风险"。
关于混元 Hy4 的五个问题
Hy4 能直接替代 Hy3 吗? 不能直接替。视觉和 Computer Use 是新能力,纯文本任务的收益要看具体场景,官方给的提升集中在办公、金融、前端游戏开发(GameDev +19.1%、GameLogic +9.8%),不在通用问答上。
1M 上下文真能用满吗? TokenHub 侧的硬上限是输入 960K、输出 64K,加起来略超 1M。要留出输出空间,实际输入控制在 900K 以内比较稳。
0.3 元的缓存需要自己做什么? 需要调用方复用前缀。同一段系统提示、同一份文档放在请求开头且内容不变,才可能命中。每次重排段落顺序都会让缓存失效。
权重开源后能在本地跑吗? 770B 的 MoE,即使按 4bit 也是 380GB 量级,单机消费卡没戏。这笔账上一篇讲 Kimi K2.7 自托管时算过一遍,640GB 权重就能把 8 卡机压到 57% 占用,770B 的规模只会更紧。开源的价值在可审计和可微调,不在本地部署。
5 折优惠到什么时候? 官方写的是即日起至 2026-12-31。折扣期内的有效输入价是 3 元/百万 token。
结语
Hy4 这次的发布,能力部分是加法:视觉、Computer Use、更大的上下文。价格部分是减法,而且减得很有针对性——缓存那一行把"反复读同一份材料"的成本打到了 1/20。
"开源"这个词最近被用得很松,权重给了算开、只能微调算开、带系统卡片算开,三种说法指的不是一件事,之前梳理过一次。Hy4 属于"权重近期开源 + 系统卡片",落地前先确认你拿到的是哪一层。
如果你的产品是文档问答、投研跟踪、长流程 agent,这一行值钱。如果你的产品是代码生成或者批量结构化输出,把输出价 18 元摆在第一位去比,缓存对你的意义不大。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。