
一句话总结:GGUF 文件开头 24 个字节就能定出四件事——是不是 GGUF、版本号、张量数量、元数据条数。真正的量化参数藏在后面的元数据里,关键是 general.file_type 这个字段,它的整数值直接对应量化类型,15 就是 Q4_K_M。我按规范构造了一个文件头,用解析器读回来验证了一遍。
下载一个 GGUF 模型,文件名通常写着 Q4_K_M、Q5_K_S,但你不一定信。
想知道它到底是什么量化,最直接的办法是读文件头。这事比想象中简单:前 24 个字节是固定结构,后面的元数据是「键值对」,按顺序读过去就行。
一、GGUF 前 24 个字节的布局
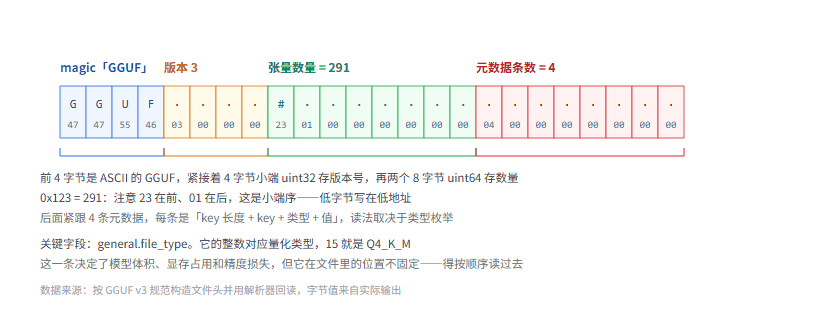
图 1:24 个字节分成四段,每段的长度和类型都是固定的
| 偏移 | 长度 | 类型 | 含义 |
|---|---|---|---|
| 0–3 | 4 | ASCII | 魔数 GGUF |
| 4–7 | 4 | uint32 | 版本号(当前是 3) |
| 8–15 | 8 | uint64 | 张量数量 |
| 16–23 | 8 | uint64 | 元数据条数 |
四条信息,结构固定。
我按规范构造了一个文件头,字节是这样:
偏移  0: 47 47 55 46 03 00 00 00  GGUF....
偏移  8: 23 01 00 00 00 00 00 00  #.......
偏移 16: 04 00 00 00 00 00 00 00  ........
第三行那个 04 就是元数据条数——后面有 4 条。这个数字决定了你要循环读几次。
二、理解文件头要先懂小端序
第二行那个 23 01 00 00 00 00 00 00,如果按大端读,结果是 0x2301000000000000,一个天文数字。
按小端读,是 0x123,也就是 291。
小端序的意思是:低位字节写在低地址。数字 291 的十六进制是 0x0123,拆成字节是 01 和 23,小端序把它倒过来存成 23 01。
x86 和 ARM 都是小端,所以 GGUF 直接用了小端,不用转换。
理解这一点很重要,否则你会把张量数量读成一个荒谬的值然后怀疑文件坏了。
三、元数据块的读法
24 字节之后是元数据,一条一条排列。每条的结构是:
[8 字节 key 长度] [key 字符串] [4 字节类型] [值]值的长度取决于类型。常见的类型枚举:
| 值 | 类型 | 值的长度 |
|---|---|---|
| 4 | uint32 | 4 字节 |
| 5 | int32 | 4 字节 |
| 6 | float32 | 4 字节 |
| 8 | string | 8 字节长度 + 内容 |
| 9 | array | 8 字节元素类型 + 8 字节长度 + 内容 |
注意 string 类型的读法:它不是"读到某个结束符",是"先读 8 字节长度,再读那么多字节"。所以解析器必须知道类型才能往下走——读错一个字段,后面全乱。
这就是为什么不能直接跳到某个字段。位置不固定,只能按顺序读。
四、从 file_type 反推量化类型
读完所有元数据,找到 general.file_type 这一条。它的整数值直接对应量化类型:
| 值 | 类型 | 8B 模型大致体积 |
|---|---|---|
| 1 | MOSTLY_F16 | 16 GB |
| 2 | MOSTLY_Q4_0 | 4.5 GB |
| 7 | MOSTLY_Q8_0 | 8.5 GB |
| 10 | MOSTLY_Q2_K | 2.7 GB |
| 12 | MOSTLY_Q3_K_M | 3.8 GB |
| 15 | MOSTLY_Q4_K_M | 4.9 GB |
| 18 | MOSTLY_Q6_K | 6.6 GB |
我的测试文件里 file_type 是 15,解析结果就是 Q4_K_M。
这个字段比文件名可靠。 文件名可以随便改,元数据不能——改错了加载器会按声明的方式解量化,结果直接是乱的。
MiniMax 那篇算过位宽和体积的关系,这里的 file_type 就是那个位宽的官方表述。
五、解析器怎么写
核心就三步:读头、循环读元数据、按类型分支。
import struct

data = open("model.gguf", "rb").read()
assert data[:4] == b"GGUF", "不是 GGUF 文件"

version,    = struct.unpack("<I", data[4:8])     # < 表示小端
n_tensor,   = struct.unpack("<Q", data[8:16])
n_kv,       = struct.unpack("<Q", data[16:24])

pos = 24
meta = {}
for _ in range(n_kv):
    klen, = struct.unpack("<Q", data[pos:pos+8]); pos += 8
    key = data[pos:pos+klen].decode();            pos += klen
    vtype, = struct.unpack("<I", data[pos:pos+4]); pos += 4

    if vtype == 8:                                 # string
        slen, = struct.unpack("<Q", data[pos:pos+8]); pos += 8
        val = data[pos:pos+slen].decode();         pos += slen
    elif vtype == 4:                               # uint32
        val, = struct.unpack("<I", data[pos:pos+4]); pos += 4
    elif vtype == 9:                               # array,跳过
        etype, = struct.unpack("<I", data[pos:pos+4])
        alen,  = struct.unpack("<Q", data[pos+4:pos+12])
        pos += 12
        val = f"<array[{alen}] 未展开>"
        # 这里要用 etype 逐个跳过元素,省略
    else:
        val = "<未支持>"

    meta[key] = val

print(meta.get("general.architecture"), meta.get("general.file_type"))
struct.unpack 里的 < 就是"小端"的声明。忘了写会读成 0x2301000000000000。
array 类型我没展开——展开要按元素类型逐个算长度,代码会长一倍。实际做工具的时候必须实现,否则遇到数组就卡住。
六、坑清单
1. 版本的字段布局可能有差异。 GGUF v1 和 v3 的头部长度不完全一样,先读版本号再决定怎么解析。我这份是按 v3 写的。
2. string 不做长度校验会读到垃圾。 如果 klen 读错了(比如类型判断错),后面 data[pos:pos+klen] 会读出一堆乱码,然后位置全偏。加一句 assert klen < 4096 能早发现。
3. array 必须先跳过整体长度。 遇到 array 时如果只跳了元素类型没跳长度,位置就错了。而且数组里的元素可能是嵌套数组,要递归跳过。
4. 不要一次性把整个文件读进内存。 一个大模型几十个 GB,open().read() 会直接 OOM。用文件句柄加 seek 只读头部。
5. 对齐问题。 GGUF 的张量数据区有对齐要求(默认 32 字节),元数据结束后可能要有 padding。只读元数据不影响,但要定位张量就得算上。
七、边界
我这次的测试文件是按规范构造的,不是从网上下的真实模型。所以这份解析器验证的是"字段位置和读法对不对",没有在真实的大模型文件上跑过。
真实文件里元数据条数通常上百条,包含 tokenizer 的词表(一个巨大的 string array)、各层的超参等。我的解析器省略了 array 展开,直接用在真实文件上会卡在第一个数组。
另外如果文件是分片的(-00001-of-00004.gguf 这种),第一个分片才有完整元数据,后面的分片只有张量。这一点文档里没写清楚,得自己试。
结语
读文件头这件事,技术含量不高,但很实用。
买了个标称 Q4_K_M 的模型,读一下 file_type 就知道真假;想知道一个模型能不能塞进你的显卡,读一下 block_count 和 hidden 就能算 KV 开销。
文件不会骗人,文件名会。
SSE 那篇讲的是另一类协议逆向——纯文本、靠换行分帧。GGUF 是二进制,靠长度前缀分帧。两种思路,一个原则:先搞清楚边界在哪,再往里读。
参考资料
- GGUF 格式规范 - 官方文档,字段定义与类型枚举
- llama.cpp 源码 - gguf.cpp 里的解析实现
- 8GB 跑 128K 的显存账 - 拿到 block_count 之后怎么算 KV
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。