
一句话总结:Caveman Code 宣称整个会话输入 token 降 33.2%,但按 agent 的实际账单结构复算,省下的钱只有 18.7%:输出侧不参与压缩却占四成账单,压缩自身还要再吃掉省下金额的 15%。
11 月 13 日 Caveman 上线了 Caveman Code,同时在 12 号的合并请求里给 Codex 加了原生压缩支持。仓库 11.9 万星,宣传口径是"整个会话输入 token 减少 33.2%,答案保持不变"。
33.2% 这个数字是真的,但它是 token 数,不是账单。这篇用上一篇那张 agent 账单做底,把压缩后的实际省钱算出来。
token 压缩的两层:输入和输出
思路分两半:response skill 压 agent 的输出表述,本地代理压 agent 的输入(日志、测试输出、JSON、diff、网页)。
这个思路和上一轮算的缓存折扣是同一个入口:都是盯着输入侧那 93% 的 token 动手,区别是一个降价、一个减量。这个分工是对的。agent 循环里输入远大于输出,每一轮都要把历史重读一遍,日志和测试输出的体积轻松上兆。压缩输入侧的收益理论上最大。
安装一行:npx skills add JuliusBrussee/caveman -g,支持 Claude Code、Codex、Gemini CLI、Cursor 等 30 多个工具,全部本地运行,不需要账号。仓库文档里也写了限制:HTML 没有压缩器,收益为零;按请求计费的产品(比如 Copilot 的 premium requests)压输出没意义,只能开代理层。
33.2% 是 token 不是账单
这是个必须分清的地方。33.2% 的降幅描述的是输入 token 数量,账单是 token 数量乘单价,四个价格档的单价差 200 倍,比例压缩不等于等比例省钱。
具体看:一份 454M 输入 + 6M 输出的会话,输入压 33.2% 后是 303M,省 151M token。听上去很多,但省下来的是哪一档 token 决定了值多少钱。
四档结构里,cache_read 占 93.5% 的 token 但只占 15.6% 的钱,output 占 1.3% 的 token 却占 43.6% 的钱。压缩主要作用在 cache_read 上,也就是那个最便宜的档。
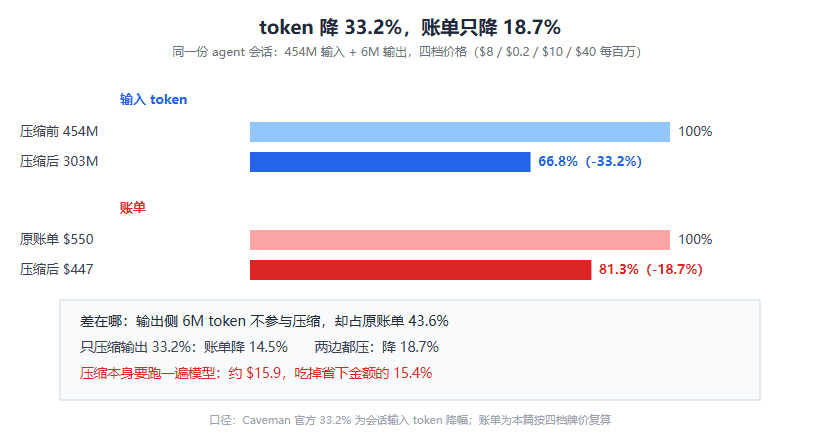
图 1:输入 token 降 33.2%,账单只降 18.7%,缺口全在输出侧
按四档输入价格重算:省 18.7%
把压缩比例套进四档价格:
PRICE = {'fresh': 8.0, 'cache_read': 0.20, 'cache_write': 10.0, 'output': 40.0}
M = {'fresh': 8, 'cache_read': 430, 'cache_write': 16, 'output': 6}
total = sum(M[k] * PRICE[k] for k in M)      # $550

M2 = {**M}
for k in ('fresh', 'cache_read', 'cache_write'):
    M2[k] = M[k] * (1 - 0.332)
t2 = sum(M2[k] * PRICE[k] for k in M2)
# 输出:
# 原账单 $550 -> 压缩后 $447,省 $103(18.7%)
差的那 14.5 个百分点全在输出侧。6M 输出 token 不参与压缩,它贡献 240 美元、占账单 43.6%,压不动。
反过来试只压输出 33.2%:账单降到 470 美元,省 14.5%。两个都压:18.7%。也就是说两份收益加起来,账单降不到两成。
这个结论对"33.2%"是个降温,但不是否定——省 103 美元仍然是省。只是别拿 token 降幅去估预算,两回事。
压缩自己也要花钱:吃掉省下的 15%
本地代理压缩不需要调 API,成本是 CPU 时间和内存。但如果用模型做压缩(response skill 那半),就有成本。
按最便宜的模型算:454M 输入过一遍、输出压缩后文本按原文 20% 计,成本 15.9 美元。占省下 103 美元的 15.4%。
# 输出:用 $0.015/$0.10 的模型压缩一遍 $15.89,占省下金额的 15.4%这笔账很多人不算。压缩比 33.2%、压缩本身吃掉 15%,净收益其实就是 15% 出头。用本地规则压缩(不调模型)能把这部分省掉,代价是压缩质量不如模型。
agent 长循环里最值得装的场景
三类场景装了就赚。
第一类是多轮工具调用。每次工具返回的日志、JSON、diff 都要进上下文,压这些是纯收益,它们的信息密度低、重复度高。第二类是测试失败后的重试循环,同一份报错反复出现,压缩能吃掉大量重复。第三类是长文档分析,同一份文档在多轮里反复读,压缩后的版本每轮都省钱。
压缩率还会随会话结构变化。一次典型的调试会话里,报错栈和测试输出占输入的六成以上,压缩率能到四成;换成多人协作、每轮都带完整 diff 的会话,可压缩的部分降到三成左右。官方那个 33.2% 应该是多类会话的平均值,你自己的工作流可能更高也可能更低,装之前先看一轮 token 分布。
判断标准很简单:输入占比超过七成的循环都值得装。输入占比低的(比如一问一答的短对话),压缩的收益抵不过安装和维护成本。
三个装了反而亏的场景
第一,按请求计费的产品。Copilot 的 premium requests 按次数算,压 token 不减次数,装了白装。文档里自己写了这一点。
第二,输出为主的任务。让模型写长文、生成长代码,输出占账单大头,压输入省不了多少,压输出又会掉质量。
第三,需要精确回溯的调试。日志压缩会丢细节,排查线上问题时反而要找原文。缓存经济学那篇算过,cache_read 便宜到几乎不要钱,为了省这点钱牺牲可读性不划算。
我在自己的脚本里试过一个简化版:只压 diff 和测试输出,日志保留原文。省下来的 token 大概两成,但调试时没再遇到过"这段日志被压没了"的情况。这个比例和官方 33.2% 差得远,因为我只压了一部分,也不打算为了数字把日志也压掉。
FAQ
Q:33.2% 是怎么测的?
官方口径是"整个会话的输入 token",包含系统提示、工具返回、历史对话。不同会话结构下比例会变,日志多的会话压缩率更高。
Q:为什么账单只降 18.7%?
输出侧不参与压缩,而输出占账单 43.6%。压缩主要作用在最便宜的 cache_read 档,所以金额降幅远小于 token 降幅。
Q:本地代理会泄露数据吗?
文档说全部本地运行、不需要账号。但它会读取你本地的日志、diff 和网页,安装前要评估信息暴露面,尤其是企业环境。
Q:压缩会影响答案质量吗?
官方称答案保持不变。逻辑上压的是低信息密度的重复内容,理论上无损;实际取决于压缩器的规则,涉及精确数值和路径的部分要谨慎。
Q:值得装吗?
输入占比高的 agent 循环值得,省 15% 到 18% 的账单。按次计费的产品、输出为主的任务、需要精确回溯的调试,装了没收益。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。