
一句话总结:Runway 把 27B 的世界动作模型 Praxis-1 全量开源,在 RoboLab-120 上以 46.2% 成功率登顶,比 π0.5 的 28% 高 65%;但单步成功率连乘之后,做 5 步任务只剩 2.1%。
11 月 13 日 Runway 宣布把 Praxis-1 全量开源,权重、推理代码、微调代码一起放,Apache 2.0,明确允许商用。27B 参数,MoE 扩散 Transformer,一个模型同时预测"世界会怎么变"和"机器人该怎么动"。
一家靠视频生成在创作者圈立足的公司,把最前沿的模型往机器人赛道开源,这个动作本身值得说。但更有意思的是那个成绩:RoboLab-120 上 1200 回合整体成功率 46.2%,登顶。一半以上失败,居然还能登顶。
Praxis-1 是什么:27B 的扩散 Transformer
技术路线说白了是把两件事塞进一个生成过程。传统做法里,视频预测和运动规划是两条流水线,前者算画面怎么变,后者算机械臂怎么动,两边对不上就靠工程去缝。Praxis-1 让模型在想象画面变化的同一时刻输出动作序列——机器人在执行前先在"脑内"演练一遍物理后果。
结构上是扩散 Transformer 加混合专家,27B 总参,每次只激活一部分。这个规模卡在一个务实的位置:太重的模型装不进机载算力,太轻的看不懂复杂场景。机器人规划下一秒动作的预算通常只有几十毫秒,模型必须能在边缘跑。
46.2% 的成功率怎么读
先看数字本身。RoboLab-120 是英伟达的机器人基准,1200 回合,Praxis-1 拿到 46.2%;第二名 FLUX3Action 42.9%,Cosmos3Nano 36.8%,机器人领域熟悉的 π0.5 只有 28%。46.2 比 π0.5 高 18.2 个百分点,相对提升 65%。
但和第一名的差距只有 3.3 个百分点(相对 7.7%)。这个领先幅度在 1200 回合的样本上,统计上不算压倒性——按二项分布粗算,两个 43% 到 46% 之间的成功率,几百回合的差距就可能颠倒。
我的看法是:登顶是真的,优势不算大。真正值得关注的是它把整个赛道的水位抬到了 40% 以上,两年前这类任务的成功率还在个位数。
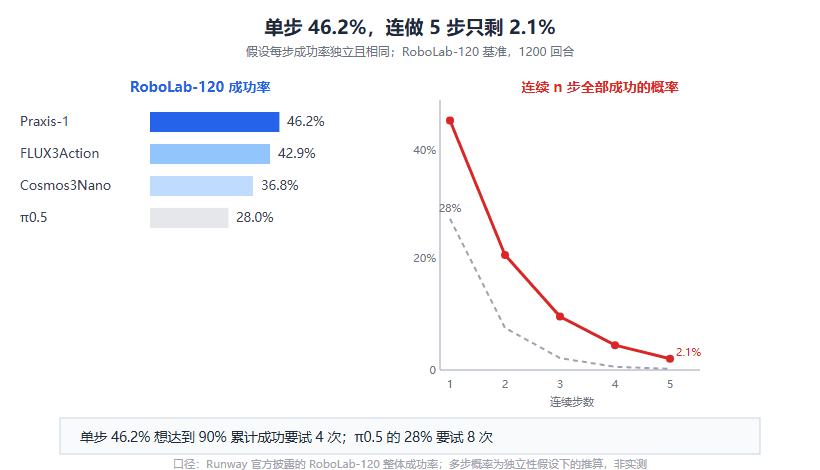
图 1:左图是基准成功率,右图是连续多步全成功的概率,5 步时只剩 2.1%
连做 5 步只剩 2.1%:多步任务怎么算
真正的机器人任务不是一步。抓取、搬运、装配,任何一件完整的事都要几步串起来。
假设每一步独立、成功率都是 46.2%,连做 n 步全成功的概率是 0.462 的 n 次方:2 步 21.3%,3 步 9.9%,5 步 2.1%。π0.5 那个 28% 连做 5 步是 0.2%,基本等于不可用。
# 输出:
# 46.2% 连做 3 步 = 9.9%,5 步 = 2.1%
# 28.0% 连做 3 步 = 2.2%,5 步 = 0.2%
这个算法有前提:每步独立。实际机器人任务里步骤之间有关联,前一步歪了后一步可以纠,所以真实概率比连乘高一些。但方向是对的——单步 46% 的模型,多步任务的完成率是个位数。
换个角度看更实用:允许重试的话,单步 46.2% 平均试 2.2 次能成一次,想达到 90% 的累计成功要试 4 次。π0.5 要试 8 次。在允许试错的场景(抓取、分拣),这个差距是能用和不能用的分界。
相对 π0.5 高 65%,绝对还是不到一半
两个数字要一起说。相对提升 65% 听起来很大,绝对值 46.2% 意味着一半以上的回合失败。
行业里对这类基准的解读有个惯性:看排名不看绝对值。46.2% 登顶,媒体标题就是"超越 π0.5 登顶",读者容易忽略一半以上失败这个事实。Runway 自己在发布里也提了"接近五成的成功率意味着一半以上回合仍然失败",这句比排名诚实。
对工程团队的含义:这代模型能进实验室和可控场景,进不了无人值守的生产线。要上产线,要么把任务拆到 1 到 2 步(把连乘损失压到 21%),要么加人工兜底。
机器人部署要多少显存
27B 参数按不同精度:4bit 是 12.6GiB,8bit 是 25.1GiB,16bit 是 50.3GiB。这个数字和27B 语言模型在 24GB 卡上的账完全一样,因为参数量相同,权重体积就相同。
差别在额外开销。世界动作模型要多一路视觉编码器和动作解码,激活值比纯文本模型大。24GB 卡跑 4bit 权重理论上可以,实际要给视觉分支留出空间,48GB 更稳。
开源的另一层价值在这里:权重和推理代码都给,团队可以自己量化、自己裁视觉分支,把模型压到机载算力能接受的范围。闭源 API 做不了这件事。
该不该接这个模型
三类团队值得动手。做工业抓取和分拣的,任务短、允许重试、场景可控,46.2% 加 2.2 次平均重试已经能算过账;做具身智能研究的,27B 开源底座目前市面上不多,Apache 2.0 可以随便改;做数据回流的,模型开源意味着可以用自己的场景数据微调,这是闭源方案给不了的。
两类先别急。要求高可靠性的(医疗、自动驾驶),46.2% 离安全线太远;没有真实场景数据的,开源只是拿到入场券,把模型接到自己的本体上、调通控制链路、攒够数据,才是真门槛。
最后说一句端侧模型那篇提过的判断:模型开源拉平的是起点,拉不平的是工程能力。Praxis-1 把水位抬到 46%,接下来比的是谁能用自己的数据把它推到 80%。
FAQ
Q:46.2% 的成功率算高吗?
在 RoboLab-120 这个基准上是当前最高,但绝对值意味着一半以上失败。历史上这类任务的成功率长期在个位数,46% 已经是明显进步,离生产可用还有距离。
Q:为什么要算多步连乘?
单步成功率是基准口径,真实任务是多步的。46.2% 连做 5 步只剩 2.1%,这个数字才反映"完整做完一件事"的概率。步骤之间有纠错空间,实际会比连乘高,但量级差不多。
Q:27B 在机器人上跑得动吗?
4bit 权重 12.6GiB,24GB 显存的边缘设备装得下,但视觉分支和动作解码要额外空间,48GB 更稳。实时性上,MoE 每次只激活一部分,规划延迟可以压到几十毫秒。
Q:Apache 2.0 意味着什么?
可以商用、可以改、可以闭源分发修改版,只要保留版权声明。对机器人公司来说,这意味着能把模型嵌进自己的产品而不必开源。
Q:和 π0.5 比该选哪个?
看场景。π0.5 的工程实践积累多,成功率 28% 但在特定任务上调优后表现稳定;Praxis-1 是新一代底座,上限更高但工程链路要自己搭。新项目从 Praxis-1 起步,已有 π0.5 产线的不急着换。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。