
一句话总结:一次 4.6 亿 token 的 agent 运行账单 550 美元,其中缓存读取占 93.5% 的 token 却只占 15.6% 的钱,输出只占 1.3% 的 token 却占了 43.6% 的钱;四个价格档相差 200 倍,账单结构完全由价格档决定。
看 agent 项目的账单时,多数人的直觉是"token 越多钱越多"。这个直觉在聊天场景大致成立,到 agent 场景就彻底失效。cheaptokens.dev 上有个示例账单:一次 agent 运行 4.6 亿 token,账单 550 美元。我把这个数字按四个价格档拆开复算了一遍,token 的分布和钱的分布几乎是两张图。
这篇把复算过程摆出来,说清钱到底花在哪一档、为什么 agent 的账单长这个形状、哪些动作真能省钱。
复算一张 550 美元的账单
先摆价格。Anthropic 的牌价分四档:新输入 8 美元每百万,缓存读取 0.2 美元,缓存写入 10 美元,输出 40 美元。最高档和最低档差 200 倍,这是理解账单的全部前提。
那次运行的 token 分布:新输入 800 万,缓存写入 1600 万,缓存读取 4.3 亿,输出 600 万。四档各自乘价格再加总,正好 550 美元,和原文对上了:
PRICE = {'fresh': 8.0, 'cache_read': 0.20, 'cache_write': 10.0, 'output': 40.0}
M = {'fresh': 8, 'cache_read': 430, 'cache_write': 16, 'output': 6}
total = sum(M[k] * PRICE[k] for k in M)
# 输出:
# $550
结构上的错位才是重点。cache 读取的 token 占 93.5%,花的钱占 15.6%;输出的 token 占 1.3%,花的钱占 43.6%。一个占绝对多数的量几乎不要钱,一个几乎可以忽略的量收走接近一半的钱。
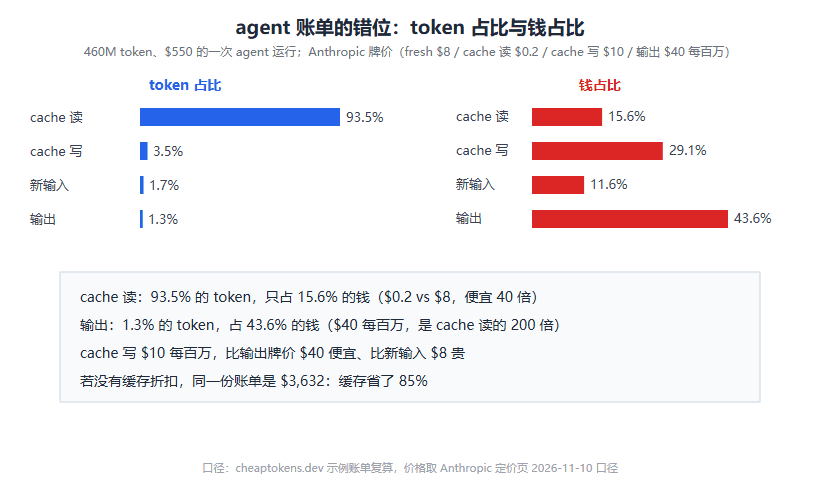
图 1:左列是四类 token 的占比,右列是四类钱的占比,排序完全颠倒
93% 的 token 只占 16% 的钱:缓存的功劳
为什么 agent 的缓存读取能到 93%?因为 agent 是循环结构。每一步工具调用之后,模型要把历史完整看一遍再决定下一步,上下文随着轮次单调增长。第 20 轮的 agent 任务,前 19 轮的内容全走缓存读,只有新增的工具有效输出是新输入。
缓存读取价 0.2 美元,是新输入价的四十分之一。没有这个折扣,同样的运行要把 4.3 亿 token 全按 8 美元每百万计费,账单是 3632 美元。缓存省了 85%。
这笔账换个方向看也成立:agent 模式的可行性本身就是建立在缓存机制上的。缓存读的价格如果回到原价的五分之一以上,多数长任务的账单会翻几倍,agent 产品的经济模型直接不成立。定价页上那一行小字,撑着整个品类的商业模式。OpenRouter 那篇的收入账里,调用量榜首的模型单价被压到每百万 token 不足一美分,靠的就是这套薄利多销的基础设施逻辑。
cache_write 比输出还贵:写缓存的价怎么定
第三贵的档位是缓存写入,10 美元每百万,占了账单的 29.1%。这个价格比新输入贵 25%,比输出便宜但量级接近,很多人第一次看到会愣一下:往缓存里写东西凭什么比普通输入贵?
定价逻辑是存储。写入的缓存要在 TTL 内留在显存里等后续请求来读,占用的是最贵的 HBM 带宽资源,而且写进去的不一定读得回来。这个价格本质上是把存储成本摊到写入请求上。
对使用者的含义是:缓存写入要精打细算。稳定不变的系统提示词、工具定义、长文档,这些会被反复读取的内容值得写缓存;每轮都变的内容写进缓存就是白扔钱,写进去没人读,TTL 一到清零。写入 1600 万 token 花了 160 美元,如果其中三分之一是白写的,就是 50 多美元的纯浪费。
同样的活换模型:968 美元和 7 美元
把同一份 workload 换到别的模型上,全部输入按无缓存的原价、输出按各自牌价,账单是这样的:
# 输出:
# GLM-5.3-Flash      $9.32
# DeepSeek-V4-Flash  $7.41
# MiniMax-M2.7       $23.60
# GPT-6.1 Sol        $968.00
同一个任务,最贵和最便宜差 130 倍。Sol 的 968 美元还没算缓存折扣,如果它的缓存体系同样成熟,实际会低不少;但即使用最乐观的折扣估计,也和 7 美元不在一个量级。
这张表不是要说"便宜模型更好"。430M token 的重读是机械性的上下文维护,不需要 65 分的智能;真正决定任务成败的是那 600 万输出 token。所以合理的架构是拆开:上下文维护和中间步骤走便宜模型,最终决策和代码生成走强模型。混合调度的账单能把两头的好处都拿到。
三个省钱的动作
按命中率排序说三个动作。第一,把稳定前缀钉死在上下文最前面,别在中间插时间戳或随机 ID,插一个字整段缓存就失效,这是最常见的缓存失效原因,一单能白扔几十美元。第二,控制输出长度,输出单价是缓存读的 200 倍,让模型少说废话比任何优化都直接,指令里明确"结果只给 JSON"比调温度有用。第三,用结构化截断代替全文重读,历史超过一定长度就把早期轮次摘要压缩,别让 cache_read 无限膨胀。
还有一个反面动作列出来避坑:为了省 cache_write 的钱关闭缓存。省下的是 29% 的写入费,换来的是 85% 的读取折扣消失,净效果是账单翻近五倍。上一篇 KV cache 的账说的是显存里的缓存,这一篇是计费层的缓存,两层的原理同源:重算一次的成本,永远比重读一次贵得多。
最后交代口径:550 美元的账单结构来自 cheaptokens.dev 的示例,价格是 Anthropic 2026 年 11 月 10 日的牌价,各家缓存计费的 TTL、最小写入粒度规则不同,换平台要重新对价目表。混合模型的账单拆分我的项目里还没有生产验证,数字是推算,落地前先小流量试。
FAQ
Q:缓存读取为什么比新输入便宜这么多?
缓存命中的内容不用重新计算,推理服务直接复用显存里已有的 KV 结果,边际成本接近于零。便宜的部分是省下来的算力,定价把节约让给了用户。
Q:cache_write 的 TTL 是多久?
Anthropic 的缓存默认 5 分钟,每次命中会刷新。5 分钟内没有后续请求,写入的钱就白花了。这也是为什么间歇性低频调用不适合开缓存。
Q:怎么判断我的任务该不该用缓存?
看一个比值:上下文会被重复读取的次数。同一份长上下文预期被读两次以上,开缓存就是赚的;一次性请求只写不读,开缓存纯亏。
Q:为什么输出 token 这么贵?
自回归解码每个 token 都要完整过一遍模型,无法并行,显存带宽全程吃满。生成阶段的计算密度和访存量都远高于一次性处理的输入,成本高几倍有物理依据。
Q:小模型换掉大模型,质量掉多少?
看任务环节。上下文维护、信息抽取这类环节,33 分和 65 分的模型差别不大;最终代码生成和复杂决策环节差距明显。拆开调度而不是整体替换,才不牺牲质量。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。