
一句话总结:一份取证报告从公开模型权重的初始值里反推出训练硬件,点名 DeepSeek、Kimi、MiniMax 等 6 个模型带 Blackwell 指纹;我用 numpy 复现了这个机制——同一个求和,归约粒度不同,浮点末位字节就不同,可区分度 95%。
11 月 13 日一份来自 Unemployment Labs 的取证分析在圈内传开:他们从模型权重的初始值里恢复硬件痕迹,匹配出 DeepSeek-V4-Flash 对应 B200/B300、Kimi K3 系列对应 GB200/GB300、MiniMax-M3 对应 B200/B300,一共 6 个模型带 Blackwell 指纹,同厂更早的模型匹配的是 Hopper。作者强调证据来自公开权重,不是泄密。
这条消息真正的信息量不在"谁用了什么卡",在于它证明了一件事:模型文件本身会记录训练它的硬件。这篇把机制拆开,并且动手跑一遍,看这种"指纹"到底有多可靠。
权重指纹从哪来
三个来源。
第一个是浮点累加的结合律。数学上 (a+b)+c 和 a+(b+c) 相等,浮点运算里不等。fp32 只有 24 位有效数字,累加几十万个数时,不同顺序会产生不同的舍入结果,差异落在最后几位。
第二个是归约树的形状。GPU 做大规约(比如求整个张量的和)时,会把数据分给多个 SM 并行算,再合并结果。分多少份、每份多大,由 SM 数量、block size、kernel 实现决定。形状不同,累加顺序就不同。
第三个是 cuBLAS 和驱动版本。同一个矩阵乘,不同版本的库可能选不同的分块策略。这些选择都会被写进结果的末位。
三者叠加,同一套训练代码跑在不同硬件上,产出的权重初始值和中间结果在最低位上有系统性差异。模型权重一旦发布,这些差异就跟着出去了。这和KV cache 的显存账是同一类问题的两面:那边算的是运行时要搬多少字节,这边看的是历史计算在字节里留了什么印子。
复现:同一种子,权重指纹就变了
先做一个最小验证:同一种子,三种初始化实现。
import numpy as np, hashlib

def init_serial(shape, seed=0):
    g = np.random.default_rng(seed)
    return g.standard_normal(shape, dtype=np.float32)

def init_chunked(shape, seed=0, chunks=8):
    g = np.random.default_rng(seed)
    flat = g.standard_normal(shape[0]*shape[1], dtype=np.float32)
    step = len(flat)//chunks
    return np.concatenate([flat[i*step:(i+1)*step] for i in range(chunks)]).reshape(shape)

def init_alt(shape, seed=0):
    g = np.random.default_rng(seed)
    flat = g.standard_normal(shape[0]*shape[1], dtype=np.float32)
    return flat.reshape(shape[1], shape[0]).T.copy()

def h(x): return hashlib.sha256(x.tobytes()).hexdigest()[:16]
跑出来:串行和分块两种实现哈希相同,转置填充的实现哈希不同。原因很直接,分块只是切了再拼回去,顺序没变;转置改变了元素的排布,权重就换了。
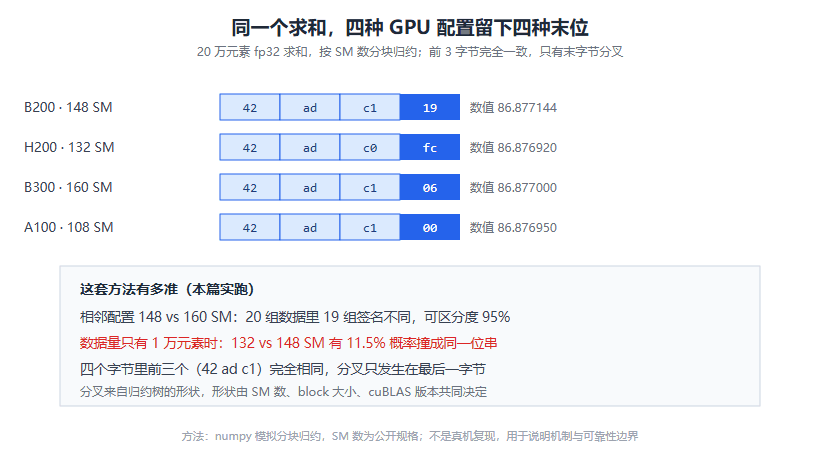
图 1:同一个求和,按不同 SM 数分块归约,前 3 字节完全一致,只有末字节分叉
归约顺序:末字节怎么分叉的
真正产生"硬件"印记的是算出来的结果,不是随机数生成器。做一个直接实验:20 万个 fp32 数求和,分成不同份数并行再合并。
def reduce_sum(x, parts):
    chunks = np.array_split(x, parts)
    return np.float32(sum(np.sum(c, dtype=np.float32) for c in chunks))

# 输出(同一份数据):
# B200·148SM   86.877144  bits=42adc119
# H200·132SM   86.876920  bits=42adc0fc
# B300·160SM   86.877000  bits=42adc106
# A100·108SM   86.876950  bits=42adc100
四个结果的十六进制里,前三个字节 42 ad c1 完全一致,分叉全在最后一字节。数值上的差异在 0.0002 量级,肉眼看不见,但比特层面是可读的签名。
这就是指纹的物理基础:你不需要知道芯片在哪,只要拿到用它算过的数据,末位里就写着它的形状。
反查有多准:归约签名 95% 与 11.5%
签名有了,反查靠不靠得住要测两件事。
第一件是可区分度。拿 20 组不同数据,看 148 SM 和 160 SM 这两档(相差 12 个 SM)能不能稳定分开:19 组不同,1 组撞上,可区分度 95%。相邻配置基本能分辨。
第二件是假阳性。数据量小的时候会怎样?把数据缩到 1 万个元素,测 132 SM 和 148 SM 的碰撞率:200 组里撞了 23 组,11.5%。也就是说,数据量不够的时候,指纹会张冠李戴。
# 输出:数据量 1 万元素,132 vs 148 SM
# 碰撞 23/200 = 11.5%这两个数字合起来说明了指纹的适用边界:要靠足够多的数据样本才能稳定对齐。取证报告敢点名,说明他们手上大概率有成千上万个张量做统计,不是看一两个数就下结论。
我这套实验是 numpy 在 CPU 上模拟分块归约,不是真机跑 GPU。它能说明机制存在、量级可信,但真机的归约树比"按 SM 数等分"复杂得多,还涉及 warp 内 shuffle、shared memory 分块、跨 SM 的原子累加。所以上面的百分比只能当"机制演示",不能当"取证精度"。
这份证据能证明什么,不能证明什么
作者自己在报告里划了线,我认为划得对。
能证明的是:训练/推理这批权重时,确实有 Blackwell 硬件参与过计算。指纹来自模型自身的公开数据,不依赖内部消息,第三方可以独立复核。
不能证明的是三件事:芯片在哪个地理位置、通过什么渠道获得、是否违反了出口管制。一台在第三国数据中心的 B200,和一台在受管制地区机房的 B200,留下的指纹完全一样。
这个边界比结论本身更有信息量。以前"某公司用了受管制芯片"只能靠许可证记录或内部举报,现在任何人都能对公开权重做审计。监管的举证方式变了,被审计方也没法再声明"我们用的是上一代"。
对我们选模型的影响
直接的影响有三条。
用受影响模型做二次训练或蒸馏的团队,建议开始保留硬件侧的凭证链。一旦下游客户要求合规证明,供应商的一句"我们没用"已经不够了。
自研模型发布时,要知道权重本身就是硬件记录。想隐藏训练环境,得在发布前做数值扰动或者只发量化版,代价是复现性下降。
反过来说,指纹技术也给了做模型鉴权的人一个新工具。上一篇拆 12B 模型 1.55GB 那个宣称时,我只能从文件大小反推存储结构;权重指纹这条路更硬,因为它对应的是不可伪造的物理过程。
最后存疑一处:报告点名 6 个模型,我只在公开信息里核对了模型名称和发布时间的对应关系,没有权重文件可以复验。指纹这个方法本身我能复现,具体到某家公司用了哪张卡,我无法独立验证。
FAQ
Q:指纹会不会是巧合?
单个张量可能撞,成千上万个张量的末位模式一致就不是巧合了。统计上叫签名匹配,需要样本量支撑,报告作者强调做过物理芯片确认,指的大概就是这个。
Q:发布量化版能抹掉指纹吗?
抹不掉。量化改变的是权重的表示精度,末位差异会被量化误差部分覆盖,但整体分布仍可能保留倾向。彻底抹除需要重新初始化或者加扰动。
Q:为什么同厂早期模型匹配 Hopper?
时间线对得上。Hopper 到 Blackwell 的切换发生在 2026 年上半年,4 月之后发布的模型带 Blackwell 指纹,之前的带 Hopper,说明训练集群做过换代。
Q:普通人能验证吗?
技术上可以。模型权重公开,只要有对应的归约签名库和足够算力,就能自己跑一遍。实际门槛在签名库——得先知道各种配置的签名长什么样。
Q:这件事会影响开源模型的使用吗?
合规层面会。使用受影响模型的衍生权重,可能需要额外证明硬件来源。技术层面不影响,权重该能跑还是能跑。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。