
一句话总结:OpenAI 公布了 GPT-6 Cyber 的实战数据:30 小时、1724 个漏洞、948 个可用提权、121.34 万美元。前三个数能直接算出单位成本和转化率;但想推「几条流水线在跑」就卡住了——观测只给了一个约束 T ÷ N = 62.6,而未知数有两个。一条斜线上的每一点都符合数据,选不出唯一解。
上一篇把1279 美元一个提权这笔账算清楚了。
算完之后我盯着那组数字看了一会儿,想到另一个问题:30 小时产出 1724 个,那它是怎么跑的?
一个漏洞要经过定位、复现、分析、写利用、验证。62 秒走完这一套,单条流水线不可能。
那答案只能是并发。但几条?
一、先把能算的算出来:反推的三个数
这三个是直接除法,没有推断成分。
FOUND, LPE = 1724, 948
COST, HOURS = 1_213_400, 30

print(f"每个提权的成本: {COST/LPE:,.0f} 美元")       # 1,280
print(f"每个漏洞的成本: {COST/FOUND:,.0f} 美元")     # 704
print(f"转化率: {LPE/FOUND*100:.1f}%")              # 55.0%
print(f"每小时的账单: {COST/HOURS:,.0f} 美元")       # 40,447
跑出来:
| 数 | 值 |
|---|---|
| 每个提权成本 | 1,280 美元 |
| 每个漏洞成本 | 704 美元 |
| 转化率 | 55.0%(丢 776 个) |
| 每小时账单 | 40,447 美元 |
| 平均一个漏洞 | 62.6 秒 |
| 平均一个提权 | 113.9 秒 |
表格末行那个「每小时 4 万美元」,比「一个漏洞 1279 美元」更有画面感。 它意味着这台机器只要开着,一小时就是一辆车的钱。
这三个数我敢当成事实用,因为它们只是把已公布的数字做了除法。
二、第四个问题就卡住:几条流水线在跑
有了「62.6 秒一个漏洞」,很自然会想推:同时开了几条流水线?
设单条流水线处理一个漏洞要 T 秒,同时跑 N 条。那么:
T / N = 62.6这是一个方程,两个未知数。
试几组解:
| 单条耗时 T | 推导出的并发 N |
|---|---|
| 60 秒 | 1.0 条 |
| 300 秒 | 4.8 条 |
| 600 秒 | 9.6 条 |
| 1800 秒 | 28.7 条 |
| 3600 秒 | 57.5 条 |
每一组都能解释观测到的 62.6 秒。
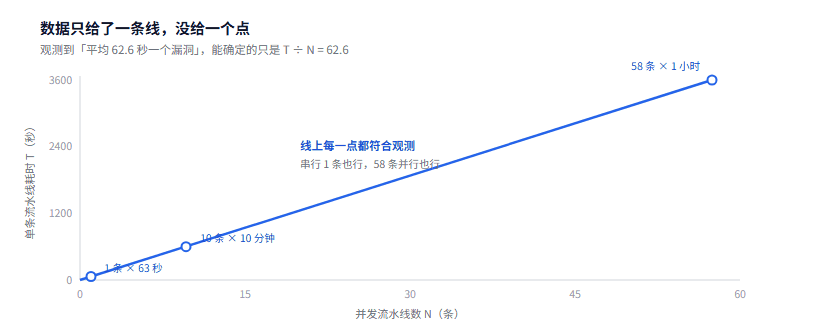
图 1:蓝线上每一个点都符合数据,数据没告诉我们选哪个
一条流水线 60 秒一个,和 58 条流水线各花 1 小时,产出的平均间隔完全一样。从结果反推过程,这类问题是欠定的(underdetermined)。
三、为什么卡住:并发和耗时是一对未知数
这不是「数据不够多」,是「数据的形状不对」。
如果公布的是「每个漏洞各花多少秒」的完整时间戳列表,那就能直接算出并发。但公布的是一个平均值——平均值把分布信息压掉了。
一个平均值 + 两个未知数 = 无穷多组解。
这在逆向里很常见。你能观测到的是「输出」,想知道的是「结构」,而输出到结构之间往往是一对多的映射。
我在这上面栽过。反解 10.87 倍那篇里,我从「加速比」反推「草稿成本」,用的是同样的思路——但那次能定下来,因为我用了三个约束(加速比、接受率、草稿长度)联立。
这次只有一个约束,所以定不下来。
四、要解开它,还需要什么数据
缺的不是「更多数字」,是另一种形状的数字。
第一种:峰值并发。 如果知道某一时刻同时在跑几条,就能反解 T。比如观测到峰值 10 条并发:
T = 10 × 62.6 = 626 秒 ≈ 10.4 分钟第二种:时间戳分布。 如果 1724 个漏洞的产出时间戳是均匀的,说明流水线稳定;如果成批出现(比如每 10 分钟出一批 10 个),说明是波次调度。成批的形态能直接暴露并发数。
第三种:单次调用的 token 数。 有了这个和总账单,能反推总调用次数,再结合时间反推并发。
这三种数据,公布的材料里一个都没有。
所以「它是几条流水线在跑」这个问题,答案是:不知道,而且从现有数据推不出来。
五、这套反推方法能用到别处吗
能。这也是我写这篇的原因——判断「什么能推、什么不能推」比推出来更有用。
三个判断标准:
第一,看约束够不够。 未知数有几个,独立约束就有几个,才能定下来。少一个就是欠定。
第二,看公布的是原始值还是聚合值。 平均值、中位数、总分——这些聚合值都会压掉分布信息。原始列表才是能反推的材料。
第三,看这个数是不是「设计出来的」。 有些数字是产品设计给定的(比如「支持 128K 上下文」),反推它没意义;有些是运行产生的(比如「用了 30 小时」),那个才含信息。
从模型 ID 反推发布计划那篇用的是前两个标准:rc-ada-* 这个命名是「设计出来的」,但它含的信息(rc = release candidate)能对上发布流程,所以能推。
六、坑清单
1. 别把「能算」当成「能推」。
除法是计算,不是推断。1279 美元是算出来的(确定),「10 条流水线」是推出来的(不确定)。这两类结论的可信度差一个量级,写的时候要分开说。
2. 一个平均值,通常压掉了最重要的信息。
这次压掉的是「并发度」。别的情况下可能压掉「长尾」——比如平均 62 秒,但可能大部分是 5 秒、少数是 3000 秒。这两种分布对应的系统结构完全不同。
3. 别用「合理」当约束。
「10 分钟一条流水线比较合理,所以应该是 10 条并发」——这是把先验当成了观测。合理只说明「可能」,不说明「是」。
4. 公布方的口径要看清。
「30 小时」是墙钟时间还是 GPU 小时?如果是后者,1724 个漏洞可能是在多卡上并行跑的,那并发数还要乘以卡数。这个口径报道里没写明,我按墙钟算的。
5. 承认推不出来,比硬写一个数好。
我一开始想写「大概是 10 条流水线在跑」,因为 10 分钟一个漏洞听起来合理。但那是猜的。把它写成推断,读者会当成结论。
七、结语
这篇的结论就一句话:三个数能算,第四个数推不出来。
听上去像白干了一场。但我觉得这个「推不出来」本身是有价值的——它划出了公开数据的边界。
以后再看到类似「某公司用 AI 干了 X 件事、花了 Y 小时」的新闻,我会先问:这里面哪几个数是能算的,哪几个是想当然的。
前者可以拿来做判断,后者只能拿来做谈资。
参考资料
- AI科技日报 2026 年 11 月 6 日 - 1724 / 948 / 121.34 万美元 / 30 小时的原始口径
- 腾讯研究院 AI 速递 20261106 - 同一事件的简版转述,用于交叉核对数字
- OpenAI - GPT-6 Cyber 系统卡片 - 安全评级与 Honeypot 测试的官方描述(发布时尚未提供完整卡片)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。