
一句话总结:DeepMind 的 agent 在密码学家监督下找到了 1024 位 RSA 的两个新弱点——padding 被控制一半时近乎失效、同长度密钥的预计算可以摊销;报道里的 1600 倍和 30 倍都是理论值,实测的只有"省 3.5 倍 CPU 时间"这一条。
11 月 6 日,DeepMind 科学副总裁 Pushmeet Kohli 公布了这个结果:AI agent 在人类监督下,和学术密码学家一起,找到了 1024 位 RSA 的两个此前未知的弱点。
团队里有 UC San Diego 的 Nadia Heninger 和 Inria 的 Emmanuel Thomé,都是密码学正经玩家。
标题里的数字很唬人。先把口径拆开,不然容易读歪。
先分清三个倍数的口径
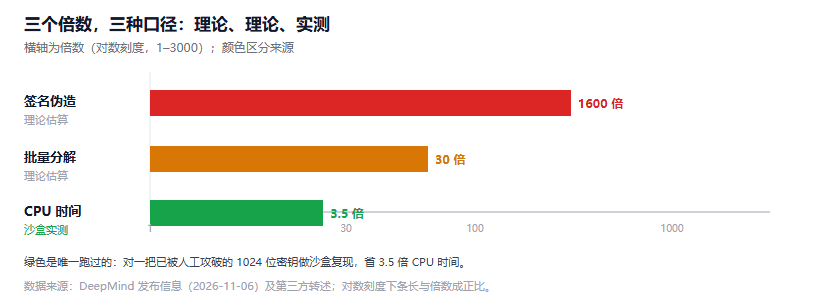
图 1:三个倍数分别来自理论估计与沙盒实测,口径不同不能相乘。数据来源:DeepMind 发布信息及第三方转述
报道里出现三个倍数:签名伪造快 1600 倍、批量分解便宜 30 倍、CPU 时间省 3.5 倍。
前两个是理论估计,agent 产出了一个算法,DeepMind 估算它比已发表的最优方法快多少,但没有端到端跑过完整攻击。
第三个是实测,团队在一个沙盒里复现了对一把 1024 位密钥的分解。这把密钥今年 9 月刚被一个学术团队人工攻破,方法发表在 IACR ePrint 上。在这个已知答案的题上,agent 用的 CPU 时间比直接分解省 3.5 倍。
三个数,三个口径。媒体把它们并列放在标题里,读者会以为"破解快了 1600 倍"是跑出来的。不是。
RSA 的弱点一:padding 在攻击者控制一半时失效
第一个弱点在 padding。
签名前会给消息包一层结构,让伪造变难。DeepMind 的 agent 发现:一旦攻击者能控制签名块里大约一半的内容,这层保护几乎不起作用。
这个条件听起来苛刻,但在真实协议里不算罕见,很多签名格式里,攻击者可控的字段(时间戳、会话 ID、可预测的随机数)占比并不低。
第二个结果更惊人:如果攻击者只控制一小段指纹,agent 产出的算法比已发表最优方法快约 1600 倍。
1600 倍是什么概念:把"几十年的计算"压到"几周"。当然,这是估算,不是跑出来的。
密码分析的弱点二:同长度密钥在互相帮忙
第二个弱点叫批量分解。
数论分解有个特性:一部分昂贵的预计算只跟密钥长度有关,不跟具体密钥有关。同一长度的密钥越多,预计算摊到每把头上的成本越低。
DeepMind 估算是便宜约 30 倍。我算了一下摊销的形状:
| 同长度密钥数量 | 每把的相对成本 |
|---|---|
| 1 把 | 30 倍(不划算) |
| 30 把 | 打平 |
| 300 把 | 独立分解的 1/10 |
| 3,000 把 | 独立分解的 1/100 |
30 把是盈亏平衡点。超过这个数,每多一把都是净赚。
这个弱点比第一个更值得警惕,因为它不依赖攻击者控制消息内容,只要你的系统和其他系统用了同长度、同年代的密钥,你就在替别人的攻击摊销成本。
实测的 1024 位结果:3.5 倍 CPU 时间
真正跑过的部分只有一处。
团队拿 9 月被人工攻破的那把 1024 位密钥做沙盒复现,agent 在已有学术成果的指引下,用了比直接分解少 3.5 倍的 CPU 时间。
这个数看着比 1600 小得多,但它是唯一可信的:有对照、有沙盒、题目有已知答案。
它说明的是 agent 的真实定位:不是自己从零破解,是在人类专家的框架里,把"直觉密集型的探索"这一段加速了。 密码分析里最贵的从来不是算力,是"下一步试哪里",agent 恰好在这个环节有产出。
2048 位 RSA 为什么没事
DeepMind 明确说了现代加密不受影响,也没点名任何还在用 1024 位的生产系统。
原因不复杂:分解难度随密钥长度超线性增长,1024 到 2048 不是翻倍,是从"学术团队能攻破"跳到"国家级算力都未必够"。
但这次结果改变的是另一件事:假设的保质期。
以前评估"1024 位还能撑多久",答案依赖人类数学家的灵感,按十年计。现在 agent 能在几周内把一个假设的攻击面摸一遍,这个保质期的估计就缩短了。
对还在用 1024 位 RSA 的老系统(老的证书、老的签名接口),这不算末日,是一个明确的迁移信号。
关于这次密码分析的五个问题
AI 自己破解了 RSA 吗? 没有。人类监督 + 学术密码学家参与 + 题目本身有学术解。agent 的贡献是加速探索,不是独立突破。
1600 倍能直接用吗? 不能。它是对一个算法的理论估算,完整攻击没有跑过。理论加速和工程可用之间隔着实现、内存和概率保证。
1024 位还在用吗? 少了,但没绝迹。老证书、离线签名设备、嵌入式系统里还有。可以查一下自己依赖的老接口。
batch factoring 需要什么条件? 大量同长度密钥 + 一次昂贵预计算。密钥长度五花八门的系统反而不受影响。
这个结果对普通人意味着什么? 意味不大。你的 HTTPS、银行 U 盾用的都是 2048 位以上。它对的是运维老系统的那批人。顺带一提,运维侧还有一类 "结果不确定" 的问题,batch 组成改变输出那篇讲的也是同一类麻烦:不是被攻击,是本来就不保证一致。
结语
这次发布最值得学的不是那两个弱点,是它对"倍数"的处理方式。
三个倍数,口径标得清清楚楚:两个理论、一个实测。DeepMind 完全可以把 1600 倍放在标题里不解释,但他们把沙盒里那个 3.5 倍也一并报了。
上一批写抽样误差时算过一个数:要分辨 1 个点的差距需要 13,589 题。倍数和差距一样,口径比数值重要,看到任何"快 N 倍",先问是在什么上、和什么比、跑没跑过。
参考资料
- AI Daily Newsstand: November 8, 2026(BYOBot)
- DeepMind agents found two cracks in retired encryption(BYOBot 转述)
- IACR ePrint 2026 年 9 月 1024 位分解结果
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。