
一句话总结:我对着四家 AI 服务各发了一次无鉴权请求,只读响应头和错误体。结果发现「OpenAI 兼容」在错误处理上根本不兼容:DeepSeek 返回纯文本,Moonshot 返回标准 JSON 但漏了一个内部灰度标记,智谱返回中文 JSON 且字段结构不同。顺带从响应头里看出了三家的 CDN 供应商。
写调用代码的时候,我习惯把错误处理写成这样:
try:
    resp = client.chat.completions.create(...)
except Exception as e:
    print(e)
能用,但不知道错在哪。上周想看看到底是什么错,就把几个服务的错误响应抓下来对比了一遍。
结果比预想的有意思。
一、方法:只发一次无鉴权请求,看响应头
做法很简单,对每个服务的 /v1/models 发一次不带 token 的请求:
curl -s -D - -o body.txt "https://api.deepseek.com/v1/models"-D - 把响应头打到标准输出,-o 把响应体存文件。然后看两样东西:响应头里的服务器标识,和错误体的结构。
每个端点只发一次,不做任何扫描。这个量级的请求和正常用户误操作没区别。
四个样本:DeepSeek、Moonshot、智谱、OpenRouter。
二、四家的错误体放在一起看
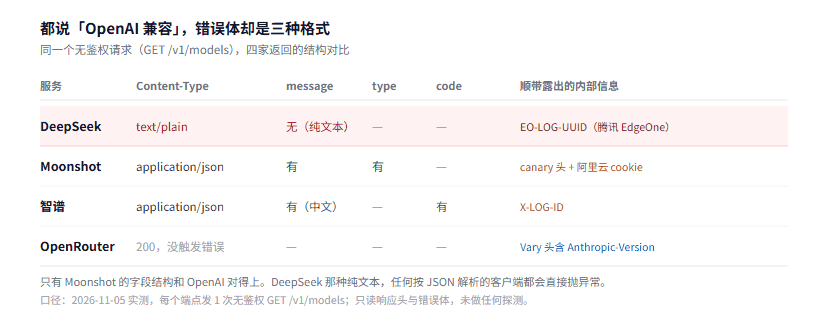
图 1:只有 Moonshot 的字段结构和 OpenAI 对得上
| 服务 | Content-Type | message | type | code |
|---|---|---|---|---|
| DeepSeek | text/plain | 无(纯文本) | — | — |
| Moonshot | application/json | 有 | 有 | — |
| 智谱 | application/json | 有(中文) | — | 有 |
| OpenRouter | 200,没触发错误 | — | — | — |
OpenAI 的错误体长这样:
{"error": {"message": "...", "type": "...", "param": null, "code": "..."}}四个字段。四家里没有一个完全按这个返回。
- Moonshot 有
message和type,缺param和code - 智谱有
message和code,缺type和param,而且code是字符串"1001"不是数字 - DeepSeek 干脆不是 JSON
三、DeepSeek 的错误体根本不是 JSON
它的完整响应体是这样:
Authentication Fails (governor)31 字节,纯文本,Content-Type: text/plain。
「governor」这个词值得看一眼。 它不该出现在面向用户的错误信息里——这是内部服务名,大概是负责鉴权和限流的网关组件,被直接写进日志文案然后原样返回了。
对调用方的实际影响是:任何按 OpenAI 约定写 response.json()["error"]["message"] 的代码,遇到 DeepSeek 的 401 会直接抛 JSONDecodeError。
这个异常和「鉴权失败」是两回事。你的日志会记录「JSON 解析错误」,而真实原因是「token 写错了」。排查方向完全跑偏。
我猜大部分 SDK 都会在这一步栽一次。有些 SDK 做了兼容(先判断 content-type 再解析),有些没做。
四、Moonshot 漏了一个内部标记
它的错误体是最规范的:
{"error": {"message": "Incorrect API key provided", "type": "incorrect_api_key_error"}}结构和 OpenAI 一致(少两个字段),type 的值「incorrect_api_key_error」也是 OpenAI 风格的命名。
但响应头里有个东西不该在:
x-internal-adhoc-canary: 984034我连发三次,值是 984034、3716743850、2611629965——每次都不一样。
x-internal-adhoc-canary 的翻译就是「临时金丝雀」,是灰度发布时用来标记「这个请求打到了哪个实验实例」的内部头。它出现在公网响应里,说明中间某一层没把它剥掉。
单看这个头没危害。但它透露了一件事:内部流量标记体系直接暴露在外。如果哪天这个头变成有语义的版本号或分片标识,等于把内部发布结构公开。
同一批响应头里还有:
Set-Cookie: aliyungf_tc=a0967d0f...
Msh-Request-Id: d4943694-...
Msh-Trace-Mode: on
aliyungf_tc 是阿里云 CDN 的 cookie。说明 Moonshot 前面挂的是阿里云。
五、响应头暴露的技术栈
把四家的头放在一起,能看出它们各自的技术选型:
| 服务 | 关键响应头 | 推断 |
|---|---|---|
| DeepSeek | Server: openresty、EO-LOG-UUID、EO-Cache-Status | OpenResty + 腾讯 EdgeOne |
| Moonshot | aliyungf_tc cookie、Msh-Trace-Mode | 阿里云 CDN + 自建追踪 |
| OpenRouter | Server: cloudflare、CF-RAY: ...-SEA | Cloudflare,节点在西雅图 |
| 智谱 | X-LOG-ID | 自有网关 |
四家用三家不同的云。 这个分布挺能说明问题:没有一家用「最优解」,都是按自己的合规、成本、历史包袱选的。
DeepSeek 那组特别干净地暴露了链路:openresty 是源站,EO-* 是腾讯 EdgeOne 的边缘节点在回源。看到 EO-Cache-Status: MISS 就知道这次请求穿透到了源站。
OpenRouter 那边更有意思。 它的 Vary 头写着:
Vary: Host, User-Agent, Originator, Anthropic-VersionAnthropic-Version 是 Anthropic API 的版本头。它出现在 Vary 里,说明 OpenRouter 会根据这个头返回不同内容——也就是它支持 Anthropic 的协议格式,不只是 OpenAI 的。
这个信息在它的文档里可能也有,但从响应头推出来更直接。顺带它还暴露了:
Access-Control-Expose-Headers: X-Generation-Id, x-openrouter-error-origin, x-openrouter-error-tool, ...x-openrouter-error-origin 和 x-openrouter-error-tool 这两个头名字说明:它内部区分「错误是上游 provider 造成的,还是自己造成的」,以及「是哪个工具调用出的错」。这是它做聚合层必须解决的问题,从头名就能反推出来。
这种「从暴露出来的痕迹反推内部结构」的做法,模型 ID 那篇用的是同一个路子:那次是从 rc-ada-* 这种命名反推发布阶段,这次是从响应头名反推系统分工。共同点是:对方没打算告诉你,但也没打算藏。
六、错误体不统一,调用方要写四套解析
回到实用层面。这件事的代价是什么?
如果你只调一家,代价是零。 写死就行。
如果你调多家(或者用 OpenRouter 这种聚合层),代价是每个服务一套错误处理。
举个具体的。你想做一个「token 失效就提醒用户重新配置」的功能:
def is_auth_error(resp):
    if resp.status_code != 401:
        return False
    try:
        data = resp.json()
        return "auth" in str(data).lower() or "key" in str(data).lower()
    except ValueError:
        # DeepSeek 这种情况:纯文本
return "Authentication" in resp.text这个函数丑,但必须这么写。任何「统一错误处理」的抽象,在遇到纯文本响应的那一刻都会破。
反过来,这也解释了为什么统一的推理端点要做好不容易——它不只是把路径转发一下,还要把六种引擎各自的错误格式归一化成一种。归一化过程中丢掉的信息,就是你在排查时最想要的那部分。
七、坑清单
1. 别假设错误体一定是 JSON。
先看 Content-Type,或者干脆用 try: resp.json() except 包一层。我见过不止一个 SDK 在这里崩。
2. 401 不等于「token 错了」。
也可能是「token 过期」「额度用尽」「这个 key 没有该模型的权限」。DeepSeek 那句 Authentication Fails 后面还带个 (governor),说明是网关层拦的,不是模型层。网关拦的错误和业务层的错误,处理方式不一样。
3. 响应头里的 trace id 要存。
DeepSeek 的 x-ds-trace-id、Moonshot 的 Msh-Request-Id、智谱的 X-LOG-ID——这些是提工单时对方唯一认的东西。日志里不带它,你说「我报错了」,对方没法查。
4. 别依赖响应头推断的「内部信息」做判断。
我上面推的 CDN 供应商、内部服务名,都是观察不是事实,可能明天就变。技术上可以参考,业务逻辑里绝对不能依赖。
5. Vary 头会改变缓存行为。
OpenRouter 的 Vary 里有 User-Agent 和 Anthropic-Version,意味着同一个 URL 换个头就是另一份缓存。你写爬虫或者缓存层的时候要按这个来,否则会拿到错的内容。
八、结语
「OpenAI 兼容」这四个字,实际含义是「路径和主要字段对得上」,不包括错误处理、不包括流式细节、不包括工具调用的边界情况。
这不是谁的错。兼容一个协议,本来就只需要兼容到「能跑通」这一层。 剩下的部分各家按自己的情况做,很正常。
但对调用方来说,这意味着:「换个 base_url 就能切换」这句话,只在你不用错误处理的时候成立。
我这次的收获是两个具体的:知道 DeepSeek 会返回纯文本,所以代码里加了 try/except;知道四家的 trace id 头名不一样,所以日志里统一记了三个字段。
这种东西文档里不写,得自己撞一次。
参考资料
- OpenAI API 参考 - 错误码 - 「标准」错误体的原始定义,可用来对照本文的偏离程度
- MDN - Vary 响应头 - 理解 OpenRouter 缓存行为的依据
- OpenRouter 文档 - 其聚合层与错误来源标记的官方说明
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。