
一句话总结:模思智能的 MOSS-Live 公布了两组数据,停顿抢话率 1.44%,低于 GPT Realtime 2.1 的 3.83% 和豆包 Seed Duplex 的 14.29%;无关语音误接话率 2%,其他系统在 68% 到 88% 之间。第二组差距更悬殊,也更能说明"全双工"这件事到底难在哪。
用语音助手的人应该都遇到过:话说到一半,停了一下想词,它抢着回答了。
或者说"这个方案我觉得……呃,再想想",它把"再想想"当成了新指令。
这类体验问题一直有,但很少有人给它量化。模思智能这次把两个指标摆出来了。
一、先看这三个数字:抢话率差 10 倍
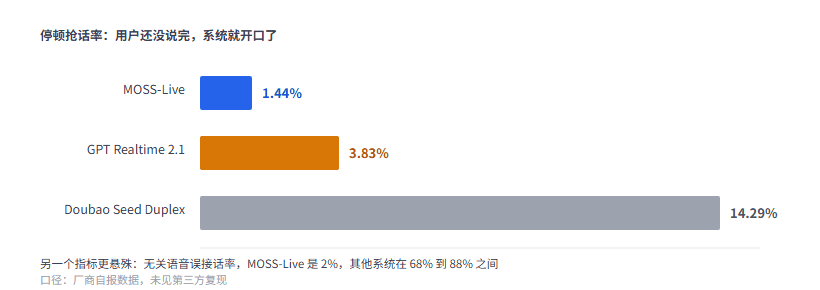
图 1:抢话率差 10 倍,这是用户最容易察觉的那一类问题
停顿抢话率:用户还在说话、只是中间停了一下,系统就认为说完了并开始回应。
- MOSS-Live:1.44%
- GPT Realtime 2.1:3.83%
- Doubao Seed Duplex:14.29%
14.29% 意味着每七次交互就有一次被打断。这个体验很难忍。
第二个指标更悬殊——无关语音误接话率,指的是旁边有人说话、电视在响、背景里有对话,系统把它当成指令接了过去。MOSS-Live 是 2%,其他系统在 68% 到 88% 之间。
我第一眼看到 68% 到 88% 觉得不太可能,太高了。但想想也合理:如果系统只靠"检测到人声"就启动,那旁边任何人说话都会触发。
二、全双工难在哪:判断"说完了没"
传统做法的流程是:录音 → 检测到人声 → 录音结束 → 检测到静音 → 认为说完了 → 送去识别 → 生成回复 → 播放。
问题全在"检测到静音"这一步。
静音多久算说完?设 300 毫秒,用户思考一秒就被切断;设 1.5 秒,每句话都要等 1.5 秒才有回应,交互变得很慢。
这个矛盾没有统一解,因为"停顿"和"说完"在音频波形上几乎一样。 人说话时的自然停顿,和自己说完的间隔,时长可以一样,语调可以一样。
真正区分它们需要语义——"我觉得这个方案"后面接的停顿,和"就这样吧"后面的停顿,含义完全不同。
所以全双工的难点不在语音识别,不在合成,在判断边界。延迟也是同一类问题:message threads 那篇讲的是文本侧怎么把重复传输砍掉,语音侧则要连"什么时候该出声"一起算。
三、第二组数字才说明全双工的水平
误接话率 2% 对 68%,这个差距比抢话率更能说明技术水平。
因为抢话率高可以靠"等更久"来降低,代价是响应变慢。误接话率高,只能靠"理解这不是对我说的话",没有别的办法。
公开信息里没有说明 MOSS-Live 的具体做法。我猜是用端到端模型直接做判断,而不是靠 VAD 阈值——但这是推测,没有依据,标存疑。
能确认的是它支持边说边听、处理打断、并调用工具。停顿抢话率 1.44% 意味着它在"等"和"抢"之间找到了一个更细的界限。
四、同一批发布的实时语音方案
这几天语音方向集中出了一批:
- AssemblyAI 的首个合成模型 AssemblyAI-TTS-1,面向实时通话
- ServiceNow 开源的 Apriel Voice 27B Preview,把语音理解、推理、工具调用放进同一骨干
- PiVo-1.4M 把整条语音栈压到 140 万个参数,本地 CPU 能跑
- Phonon 31M 量化后 43.7 MB,手机浏览器流式生成 24kHz
方向很清楚:语音正在从"一个功能"变成"一个基础层"。有人在往大做(27B),有人在往小做(140 万参数),两头的目标都不一样。
18M 那个 TTS讲的是往小做的思路:够用就行,重点是能塞进任何设备。
五、语音交互怎么选
按场景分三类。
客服、销售外呼这类。 误接话率是关键。背景噪音、旁人说话是常态,接错一次就有真实损失。这个场景值得为 2% 和 68% 的差距付钱。
个人助理、车载。 抢话率更影响体验。用户一句一句说,背景相对干净,被打断的挫败感比接错话强。
录音转写、会议记录。 这两个指标都不重要,因为它是单向的。看识别准确率就行。
六、常见问题
抢话率越低越好吗?
不是。它和响应速度是跷跷板。把阈值拉到 3 秒,抢话率能降到接近 0,但每句话都要等 3 秒,没法用。
这些数字可信吗?
都是厂商自报,我没有看到第三方复现。特别是 68% 到 88% 这个区间,覆盖哪些系统、怎么测的,公开信息没说清楚。
全双工和半双工的区别是什么?
半双工是一问一答,说完才能听。全双工是边说边听,可以被打断、可以在对方说话时插话。人对人的对话是全双工的。
支持中文吗?
MOSS-Live 是国内团队做的,中文应该没问题。其余几家的中文表现要以官方为准。
结语
语音交互这几年一直在比音质、比自然度。这两个指标现在都卷得差不多了,真正卡体验的是"什么时候该说话"。
这次的数据把这个模糊的体感变成了两个数字。1.44% 和 2% 意味着它大部分时候知道你在想事情、也分得清谁在说话。
至于实际用起来是不是这样,得自己试。参数好看和体感好之间,还隔着一层真实环境。
参考资料
- AGI HUNT 日报 2026-11-03 - 收录 MOSS-Live 与各家的抢话率、误接话率数据
- AssemblyAI - AssemblyAI-TTS-1 发布信息
- ServiceNow 开源 Apriel Voice - 语音大模型权重
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。