
一句话总结:OpenAI 开源了 gpt-oss-20b 和 gpt-oss-120b,是 2019 年 GPT-2 之后第一次放权重。20b 版本 16GB 内存就能跑,120b 版本需要单张 H100,性能与 o4-mini 相当。Apache 2.0 许可,支持配置推理投入、完整思维链和智能体能力。
OpenAI 开源这件事,隔了六年。
上一次是 2019 年的 GPT-2,当时还因为"太危险"分阶段放出。之后转闭源,一路到 GPT-6。
这次放出来两个:gpt-oss-20b 和 gpt-oss-120b。
一、gpt-oss 是什么:时隔六年的开源
先把基本事实列清楚。
| 项目 | gpt-oss-20b | gpt-oss-120b |
|---|---|---|
| 参数量 | 20B | 120B |
| 运行内存 | 16GB | 需单张 H100(80GB) |
| 许可 | Apache 2.0 | Apache 2.0 |
| 能力对标 | 小尺寸推理 | 与 o4-mini 相当 |
两个版本都支持三件事:配置推理投入(想多久)、输出完整思维链、调用工具。
第三条是关键。有工具调用能力,意味着它不只是一个聊天模型,能当 Agent 的底座用。
Apache 2.0 这个许可比 MIT 多一条专利授权条款——用的人不用担心专利被反诉。对企业部署来说,这个细节比"能不能商用"更实际。
二、两个版本的硬件门槛
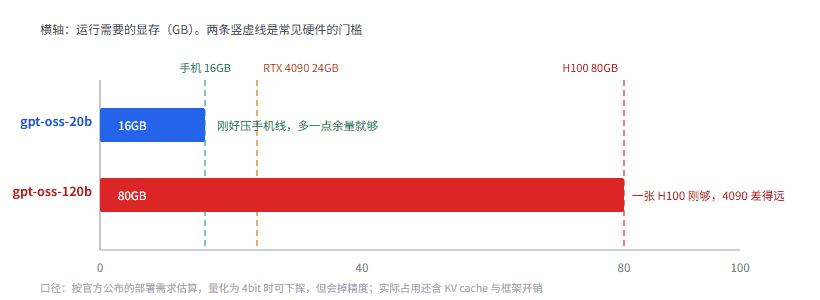
图 1:20b 刚好压在手机那条线上,120b 刚好压在 H100 那条线上
16GB 和 80GB,这两个数字卡得很有意思。
20b 的 16GB,刚好是高端手机的内存上限。 不是显存,是统一内存——苹果的 M 系列、部分安卓旗舰是这个量级。
120b 的 80GB,刚好是 H100 的容量。 多一点就要双卡,少一点就装不下。
两个"刚好",说明这两个规格是照着硬件边界设计的,不是随便定的。
三、20b 真的能跑在手机上吗
官方说"支持手机部署"。这句话要拆开看。
技术上成立。 16GB 统一内存的手机,把权重压到 4bit 大约 10GB,能塞进去。
体验上要打折。 手机的内存带宽比 GPU 低一个量级,跑 20B 模型的速度大概是个位数 token/秒。而且手机跑模型会发热、会掉电。
实际意义在离线场景。 飞行模式、无网络、隐私敏感的场景下能用,这本身就是价值。但指望它替代云端 API,不现实。
我的判断:16GB 这个数字更像是"演示可行性",不是"日常可用"。真要用,还是笔记本或者小主机更实际。
四、120b 值不值得上
120b 对标的 o4-mini,是闭源的。
开源版追平一个闭源商业模型,这件事的意义不在技术,在成本结构。
o4-mini 按 token 收费,用得越多付得越多。gpt-oss-120b 一张 H100 跑起来,之后是电费和折旧。调用量足够大的时候,后者便宜得多。
拐点在哪?粗算一下:一张 H100 按租用价每小时 2 到 3 美元算,一天 50 到 70 美元。如果 o4-mini 的用量折算下来每天超过这个数,自建就划算。
这个数对中小团队来说不低。所以 120b 更适合调用量大的场景,比如批量处理、内部工具、Agent 后端。
MiniMax 那篇算过另一种降本路径——把 428B 压到 93GB,让两张 H100 就能跑。两条路子思路一致:把硬件门槛降下来,自建才有意义。
五、和别的开源小模型比
这两个版本放出来的时机,正好赶上开源模型扎堆。
同一周里:智谱 GLM 5.2 开源(7440 亿总参数、400 亿激活),Qwen4 预告继续开源,MiniMax M3.1 Flash 被社区压到 93GB。
OpenAI 选这个时间点放 gpt-oss,不像是巧合。
它的位置也比较特别——不是最大的(GLM 5.2 的 7440 亿比它大得多),也不是最开放的(Apache 2.0 比 MIT 严一点)。它的卖点是"OpenAI 出品"这个标签,以及和自家产品线的一致性(思维链格式、工具调用协议)。
六、常见问题
gpt-oss 能商用吗?
Apache 2.0 允许商用,需要保留版权声明和许可文本。比自己写一套强。
20b 和 120b 差多少?
官方说 120b 对标 o4-mini,20b 没给明确对标对象。通常这个规模差距在复杂推理上很明显,简单任务差别不大。
真的能在手机上跑吗?
技术上可以,速度慢。当离线备用可以,当主力不行。
和 Llama 系列比怎么样?
没有直接对比数据。差别更多在工具链——Llama 那套更成熟,gpt-oss 刚出来。
权重在哪下?
HuggingFace 上应该有官方仓库。具体地址以 OpenAI 官方公告为准。
结语
OpenAI 开源这件事,我不觉得是"转向"。
更像是防守——开源模型的盘子已经很大了,如果一直不参与,未来企业部署的默认选项里就没有它。
对用的人来说,这是好事。多一个 Apache 2.0 的选择,谈判的筹码就多一点。
世界模型那篇讲的是 Agent 训练环境,gpt-oss 这类模型正好可以当它的底座——一个能跑在单卡上的、带工具调用能力的开源模型,够用了。
参考资料
- 每周 AI 新动态 - gpt-oss 两个版本的规格与许可
- Agentic AI News 2026-11-03 - 开源模型集中发布情况
- OpenAI 官方 - gpt-oss 发布公告与权重地址
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。