
一句话总结:我给自己 tools/ 里的 7 个脚本写了个健康度检查器,只看会被反复修改拖垮的指标——最长函数、分支数、注释比例、重复行。结果是 2 个低于 80 分,而这两个恰好是我改过最多次的。行数根本不是问题,那两个文件都不到 250 行。
publish_online.py 这个文件,我这两天改了三次。
第一次加 --id 参数,让发布过的文章能覆盖更新。第二次加图片硬校验,防止正文没图还照发。第三次加占位符残检,防止 {XXX} 写进线上。
每次都很小,每次都在同一个函数里加十几行。
今天早上我想看看它现在长什么样,于是写了个检查器扫了一遍。结果不太好看。
一、代码库体检:7 个脚本,两个已经过线
先看数据。
| 文件 | 行数 | 函数 | 平均长度 | 最长函数 | 最大分支 | 注释% | 重复% | 评分 |
|---|---|---|---|---|---|---|---|---|
| md2zblog.py | 217 | 6 | 26.2 | 95 | 29 | 2.7 | 0.7 | 48 |
| publish_online.py | 247 | 8 | 27.8 | 159 | 32 | 9.9 | 1.2 | 50 |
| fetch_image.py | 77 | 1 | 40.0 | 40 | 10 | 1.6 | 0.0 | 80 |
| fix_intro.py | 45 | 0 | 0.0 | 0 | 0 | 2.4 | 0.0 | 80 |
| fix_links_online.py | 160 | 8 | 16.2 | 34 | 8 | 1.4 | 1.0 | 80 |
| seo_check.py | 148 | 5 | 24.0 | 74 | 13 | 0.8 | 1.1 | 80 |
| svg2png.py | 128 | 4 | 18.2 | 33 | 9 | 2.9 | 1.4 | 80 |
低于 80 分的两个:
md2zblog.py:      最长函数 95 行、分支 29 个、注释只有 2.7%
publish_online.py: 最长函数 159 行、分支 32 个注意一件事:这两个文件的行数在所有文件里排前两名,但都不算长。 247 行放到任何项目里都是小文件。
问题不在总量,在分布。publish_online.py 里有个函数占 159 行,也就是说这个文件三分之二的内容挤在一个函数里。
二、代码库的三个状态:健康、劣化、僵化
我把它归纳成三个状态。
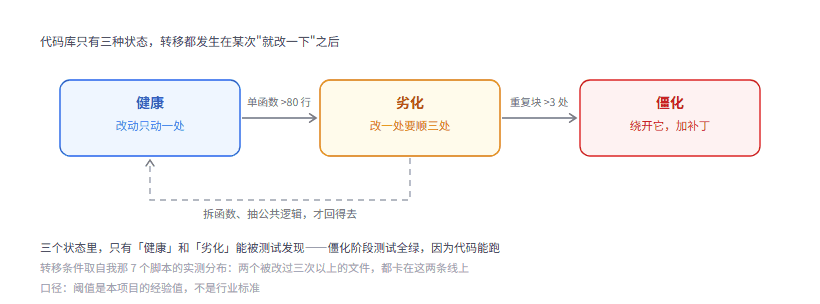
图 1:转移不会突然发生,都是"就改一下"累积出来的
健康。 改动只动一处。加一个参数,改一个函数就完事。
劣化。 改一处要顺三处。你加个校验,得同时改调用方、改错误处理、改日志。
僵化。 绕开它。知道那里有问题,但不敢动,所以在新代码里加个 if 挡一下,或者复制一份出来改。
最危险的是:僵化阶段测试全绿。 因为代码能跑,功能正常,CI 不会报警。它只是变得越来越没人敢碰。这和验收口径那篇说的是同一件事:「跑得起来」和「改得动」是两把尺子,前一把量不出后一把的问题。
publish_online.py 现在在从"健康"往"劣化"走的路上。还没到僵化——我今天还在里面加东西——但已经开始出现"改一个地方要检查三处"的感觉了。
三、函数级指标:哪几个真的会坏事
行数和注释率都不是关键。我看下来,这四个最能预测"这个文件要出事"。
最长函数。 比平均函数长度有用得多。平均 27 行听着很正常,但里面有一个 159 行的,维护成本全在那里。看平均会被掩盖。
单函数分支数。 32 个分支意味着 32 条可能的执行路径。这种函数改一行,你不知道会影响哪条路径。测试覆盖不了这么多组合。
重复行。 复制粘贴是劣化最快的方式。改一处忘了另一处,就是线上 bug。
注释率,但要反着看。 注释少不是罪,注释少且函数长才是——说明这段逻辑没人讲得清,包括写它的人。
四、检查器怎么写
核心就两个函数。用 Python 的 ast 模块,不需要装任何依赖。
import ast
from collections import Counter

def branch_count(node):
    """数一个函数里的分支,BoolOp 也算,因为 and/or 也是分叉"""
    return sum(1 for n in ast.walk(node)
               if isinstance(n, (ast.If, ast.For, ast.While, ast.Try, ast.BoolOp)))

def analyze(path):
    src = open(path, encoding="utf-8").read()
    lines = src.splitlines()
    tree = ast.parse(src)

    func_lens, branches = [], []
    for f in ast.walk(tree):
        if isinstance(f, (ast.FunctionDef, ast.AsyncFunctionDef)):
            span = (f.end_lineno or f.lineno) - f.lineno + 1
            func_lens.append(span)
            branches.append(branch_count(f))

    code_lines = [l for l in lines if l.strip() and not l.strip().startswith("#")]
    comment_lines = [l for l in lines if l.strip().startswith("#")]

    norm = [l.strip() for l in code_lines
            if len(l.strip()) > 12 and l.strip() not in ("else:", "try:", "pass")]
    dup = sum(c - 1 for c in Counter(norm).values() if c > 1)

    return {
        "max_func": max(func_lens) if func_lens else 0,
        "max_branch": max(branches) if branches else 0,
        "comment": len(comment_lines) / max(len(code_lines), 1),
        "dup": dup / max(len(norm), 1),
    }
打分就简单粗暴一点,别搞复杂:
def score(r):
    s = 100
    if r["max_func"] > 80:
        s -= min(25, (r["max_func"] - 80) // 2)
    if r["max_branch"] > 15:
        s -= min(25, (r["max_branch"] - 15) * 2)
    if r["comment"] < 0.03:
        s -= 20
    if r["dup"] > 0.05:
        s -= min(20, int(r["dup"] * 100))
    return max(s, 0)
publish_online.py 的分数:最长函数超 80 行 79 行,扣 25(封顶);分支超 15 个 17 个,扣 25(封顶);注释 9.9% 不扣;重复 1.2% 不扣。100 - 50 = 50。
扣光了两项封顶,所以 50 分。这个分数不代表"这文件很烂",代表"两项都到上限了,再改下去没缓冲"。
五、检查器跑出来的结果说明什么
有一个反常识的发现。
那 5 个 80 分的文件,不是因为写得好,是因为没怎么改过。fix_intro.py 只有 45 行,一次写完就没动,它当然健康。svg2png.py 128 行,最近两个月没碰过。
真正被反复修改的两个文件,都掉了下去。
这说明健康度检查的时机很关键:在"我要再改一次"之前跑,而不是等项目结束跑。 项目结束时看什么都是定的,跑不跑没区别。
我给自己的规矩是:同一个文件第三次要动的时候,先跑一遍检查。如果最长函数已经过 80 行,那这次不是"加个功能",是"先拆再改"。
六、坑清单
1. end_lineno 在某些 Python 版本上可能为空。 我用 f.end_lineno or f.lineno 兜了一下,不兜会抛 AttributeError。
2. 注释率用 # 数行,多行 docstring 不算。 所以文档写得好的文件反而分数低。要算准得遍历 AST 里的 Expr(Constant) 节点,我为了简单没做。
3. 重复行阈值 12 个字符是我拍的。 太短会把 return result 这种算成重复,太长会漏掉真正的复制粘贴。你按自己代码风格调。
4. 分数不要横向比不同项目。 我的 80 分标准和别人的 80 分不是一回事,阈值是从自己的历史数据里试出来的。只跟自己比,看趋势。
5. 别拿它当考核指标。 一旦变成 KPI,写法就会变成"把长函数拆成三个中等函数",但耦合一点没减少。指标能骗,维护成本骗不了。
七、边界
这套东西只看结构,不看逻辑。
一个 30 行、分支 5 个的函数,可能做的事情完全没人懂;一个 120 行的长函数,可能就是一个很直白的顺序流程,拆开反而更难读。
我扫的这 7 个文件都是工具脚本,逻辑简单、生命周期长,所以结构指标很有参考价值。换成业务代码,同样的阈值会误判一片。
另外,这 7 个文件的样本量太小,说是"规律"不成立。它只是一个提醒:我被改得最多的两个文件,正好是分数最差的两个。 这个相关性在我这里出现了,在别处不一定。
结语
代码烂掉不是因为某次大改,是因为二十次小改。
每次都很合理:加个校验、加个参数、加个兜底。加的时候都想着"就这一次,下次再重构"。然后就没有下次了。
检查器的用处不是打分,是让你在动手之前看一眼:这个文件,还接得住这次修改吗。
接不住的时候,先拆,别硬加。过度封装那篇讲的是另一个极端——该简单的事被拆得太碎。这两件事的方向相反,但错误是同一个:动手前没算成本。
参考资料
- Python ast 模块文档 - 函数节点与行号属性
- SlopCodeBench 相关讨论 - 多轮修改后代码库质量的评测口径
- CodeScene:代码健康度指标 - 商业工具采用的同类指标
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。