
一句话总结:Anthropic 在 Messages API 里开放了 message threads 测试,做法是把会话状态留在服务端,客户端首个请求带完整对话,之后每次只发新增消息加一个响应 ID。我按每轮 500 token 模拟了 20 轮,累计传输从 99,000 降到 4,000,降幅 96%。官方给的数据是 50 万到 100 万 token 的请求首 token 延迟降约 35%。但 token 账单不会减少,省的是传输和预填充。
写长跑型 Agent 的人大概都踩过这个坑:任务跑了三十轮,每轮都要把前面三十轮的对话原封不动再发一遍。
模型那边看到的是一份完整的对话,但网络这边传的是一吨重复数据。第 30 轮的时候,请求体里 99% 的内容服务器早就见过。
Anthropic 上周放出来的 message threads 就是冲着这件事。
一、message threads 解决的是什么:重复传输
先说清现状。
现在调大模型 API,是无状态的。每次请求都要把整段对话塞进 messages 数组发过去,服务器处理完就忘。第 n 轮的请求体里,前 n-1 轮的内容一个字不少。
这带来两个成本:
网络传输。 一段 20 轮的对话,上下文长度 9,700 token,第 20 轮就要发 9,700 token 出去。前面 19 轮的 9,500 token 全是重复的。
预填充。 服务器收到之后要把这些 token 重新编码一遍,才能开始生成。这一段耗时就叫 TTFT(首 token 时间)。
Agent 场景把这个问题放大了。一个跑 50 步的任务,每步都带上历史,总传输量是串行累加的。脚本模式那篇算过类似的事:换一种调用方式,20 步的 token 消耗能差 27 倍。
二、threads 的做法:会话只发一次
机制不复杂。
第一个请求:携带完整会话内容,同时开启一个 thread。服务器把这次会话的状态保存到内存里,返回一个响应 ID。
后续请求:只发新增的那条消息,加上之前的响应 ID。服务器凭 ID 找到对应状态,接着往下算。
状态的生命周期:保存在内存中,加密,不落盘,末次请求之后 5 分钟过期。
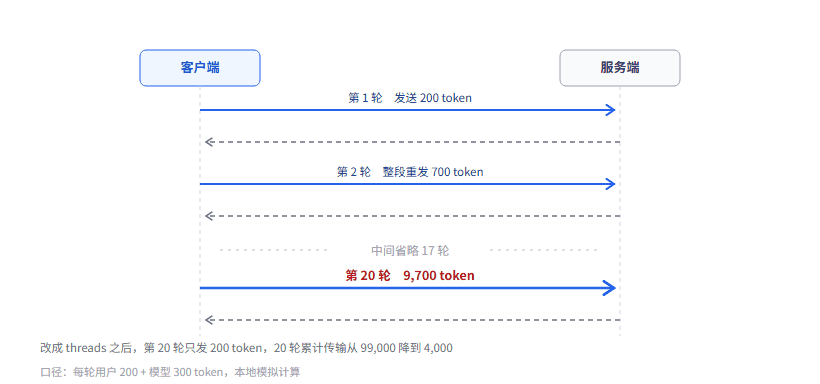
图 1:同一个 20 轮对话,旧方式每轮重发全部历史,threads 只发新增那一条
官方说这能力对多数 Claude Code 用户已经默认开启。受影响最大的场景是长跑编码 Agent、每一步都带截图的 computer use、以及文档和图片密集的工作流——这三类的共同点是上下文涨得特别快。
三、我按 20 轮算了一遍会话传输量
光看机制没感觉,我写了个脚本把两种方式的传输量算出来。
口径:每轮用户发 200 token,模型回 300 token,跑 20 轮。
USER_TURN, BOT_TURN, ROUNDS = 200, 300, 20

def old_way():
    history = send = prefill = 0
    for _ in range(ROUNDS):
        req = history + USER_TURN
        send += req
        prefill += req          # 全量重新编码
        history += USER_TURN + BOT_TURN
    return send, prefill

def threads_way():
    history = send = prefill = 0
    for i in range(ROUNDS):
        if i == 0:
            req = history + USER_TURN
            send += req
            prefill += req      # 首轮仍要全量
        else:
            send += USER_TURN   # 只发新增
            prefill += USER_TURN  # 服务端复用已编码状态
        history += USER_TURN + BOT_TURN
    return send, prefill
跑出来的结果:
指标              旧方式      threads      降幅
累计传输          99,000        4,000     96.0%
累计预填充         99,000        4,000     96.0%
第 20 轮传输        9,700          200     97.9%
第 20 轮那一行最能说明问题:旧方式要发 9,700 token,threads 只发 200。差了 48 倍。
这个数字是我按固定轮长模拟出来的,真实对话的轮长不均,比例会有出入,但量级不会变。
四、省的不是 token,是预填充时间
这里有个特别容易搞错的地方,我得说清楚。
账单不会变。
模型在生成第 20 轮回复时,仍然要"看到"前 19 轮的全部内容——上下文窗口没变,计费的输入 token 数也没变。threads 改变的是这些内容怎么到位,不是到位多少。
这就是为什么官方强调的是 TTFT(首 token 延迟)降 35%,不是成本降 35%。真正决定成本的是上下文长度,27B 那篇算过的内存账讲的是同一件事:上下文越长,贵的那部分越往后压。
35% 这个数字对应的上下文区间是 50 万到 100 万 token。上下文越长,重复预填充的浪费越大,这个降幅越明显。短对话(几千 token)几乎感觉不到差别。
所以:
- 省的是等待时间
- 省的是带宽
- 不省 token,不省钱
如果你的场景是"每次只问一句、几十 token",threads 对你没用。
五、threads 接口大概长什么样
官方还没放完整文档细节,我按公开描述把调用形状写出来。这段是示意,不是可直接跑的 SDK 代码。
import requests

class ThreadSession:
    def __init__(self, api_key, base):
        self.h = {"x-api-key": api_key, "content-type": "application/json"}
        self.base = base
        self.thread_id = None      # 首轮之后才有
        self.last_response = None

    def send(self, user_text):
        if self.thread_id is None:
            # 首轮:带完整会话,开启 thread
            body = {
                "messages": [{"role": "user", "content": user_text}],
                "thread": {"enabled": True},
            }
        else:
            # 后续:只发新增消息 + 上一轮响应 ID
            body = {
                "messages": [{"role": "user", "content": user_text}],
                "thread": {
                    "id": self.thread_id,
                    "after": self.last_response,
                },
            }
        r = requests.post(f"{self.base}/messages", json=body, headers=self.h, timeout=120)
        r.raise_for_status()
        data = r.json()
        self.thread_id = data.get("thread_id", self.thread_id)
        self.last_response = data["id"]
        return data["content"]
关键在于两件事:首轮要显式开启 thread;后续每次都要把上一轮的响应 ID 带回。
少了 after 那个字段,服务器找不到状态,就只能当新会话处理——这时候你既付了 threads 的麻烦,又没拿到省下的传输。
六、四个坑
按踩中概率排。
1. 5 分钟过期。 状态保存在内存里,末次请求后 5 分钟释放。Agent 里如果有"思考很久再发下一条"的环节,很容易过期。过期之后会退化成重新建立会话,你多付一次全量。给长间隔的步骤设个心跳,或者干脆别用 threads。
2. 状态在内存里,不落盘。 这意味着服务端一重启或做负载均衡迁移,会话就没了。生产环境必须处理"ID 失效"这个分支,不能假设 ID 一直有效。
3. 不能并发。 同一个 thread 是两个请求之间的状态,如果同时发两条消息进去,谁先谁后不定。多 Agent 并行时必须每个 Agent 一条独立 thread。
4. token 账单不变。 这条不算坑,但最容易误判。看到传输量降 96% 就以为成本降了 96%,预算会算错。
七、边界
官方公布的是 TTFT 中位数降约 35%(50 万到 100 万 token 区间),我用的是本地模拟算的传输量,两者不是同一个指标,不能互相印证。
真实的延迟收益还跟网络状况、服务端负载有关。我这里没有 API 使用权,没法做端到端实测。这台机器上跑出来的只有传输量,不是延迟。
另外这套机制本质上把"会话"变成了一种服务端资源。以后如果多家厂商都这么做,会话的可迁移性会是个新问题——你换一家供应商,历史会话带不走。
结语
这个功能的定位很清楚:给长跑型 Agent 降延迟。
如果你的任务动辄几十轮、上下文几十万 token,它值。如果你的调用都是独立的短请求,它对你没有意义。
判断标准就一条:看你的请求体里有多少内容是上一轮已经发过的。 占比高,就有收益;占比低,就别折腾。
参考资料
- Anthropic message threads 官方说明 - 机制、TTFT 数据与可用范围
- AI 技术日报 2026-11-03 - 收录 threads 的功能描述
- Anthropic API 文档 - Messages API 通用参考
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。