
一句话总结:从 2022 年的 DiffuSeq 到 2026 年的 Clover-35B,扩散语言模型走了五年才第一次在 35B 这档和自回归打平;这五年里它分化出三条路线(从头预训练、自回归权重转换、只卖 API),也始终被三道技术坎卡着,理解这三道坎比记住模型名字有用得多。
Clover 发布那天很多人第一次听说「扩散语言模型」这个词。其实这条路已经走了五年,而且中间死过、绕过、也换过技术路线。
把谱系理清楚有两个好处。一是看到 Clover、LLaDA、Dream、Mercury 这些名字时知道它们各自在解决什么问题;二是判断这次到底是真突破还是又一轮宣传。
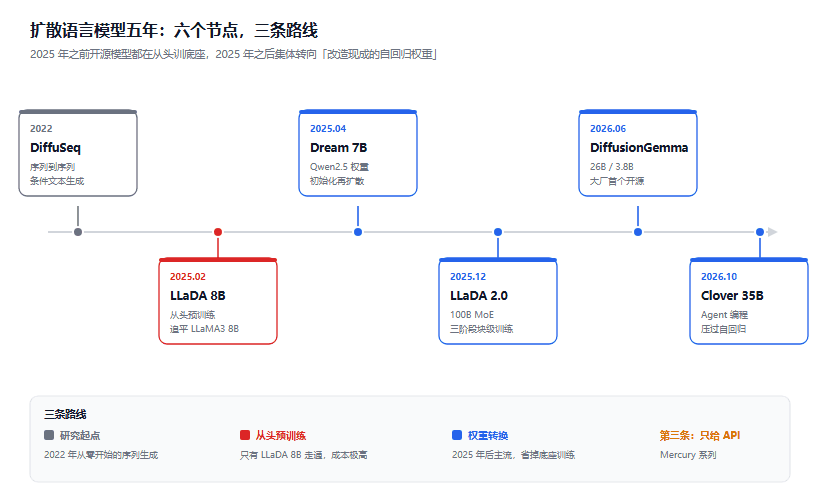
图 1:六个关键节点与三条路线,2025 年后主流从「从头预训练」转向「改造自回归权重」
时间线:从 DiffuSeq 到 Clover
2022 年,DiffuSeq。 香港大学 NLP 实验室的团队开始琢磨一件事:扩散模型在图像上那么成功,能不能用到文本上。难点是文本是离散的,而扩散擅长的是连续信号。DiffuSeq 解决的是「给定一段文字,按条件生成另一段」,也就是序列到序列。
2025 年 2 月,LLaDA 8B。 这条线上第一个「从零预训练」的成果,8B 稠密模型。它证明扩散语言模型的能力能追平同尺寸自回归:底座和 LLaMA3 8B Base 打平,Instruct 版在反转诗补全上甚至赢了 GPT-4o(45.6% 对 34.3%)。这个成绩当时很轰动,但没人注意它用的是「从头训练」这条最贵的路。
2025 年 2 月,Mercury Coder。 美国 Inception Labs 的商业产品,第一个商业化规模的扩散语言模型。它选了另一条路:只给 API,不给权重。
2025 年 4 月,Dream 7B。 团队核心成员参与的模型,关键创新是不从零训,而是拿 Qwen2.5-7B 的权重初始化再做扩散训练。这一步改变了整条路线的成本结构。Dream 7B 在 Countdown 数字规划和数独的部分测试里甚至超过了 671B 的 DeepSeek V3。
2025 年下半年,字节入场。 Seed Diffusion Preview 主攻代码生成和编辑,在 H20 上的代码测试里跑到 2146 tok/s。同年 9 月出了 LLaDA-MoE-7B-A1B,开始走 MoE 稀疏化。
2025 年 12 月,LLaDA 2.0。 蚂蚁集团接手 LLaDA 线,做到 16B(mini)和 100B(flash)两个 MoE 版本,把「自回归权重转换 + 三阶段块级训练」做成了标准流程。
2026 年 2 月,Mercury 2。 Inception 的第二代,Blackwell 上 1009 tok/s,128K 上下文,推理强度可调。同年 9 月的 Mercury 2.5 把上下文推到 260K,速度 1107 tok/s,定价 $0.20/$0.75 每百万 Token。
2026 年 6 月,DiffusionGemma。 谷歌把 Gemini Diffusion 的研究成果做成开源权重:26B 总参、3.8B 激活,Apache 2.0,一次精炼 256 token 的画布,量化后约 18GB 显存,5090 上 700+ tok/s。这是第一个大厂开源的扩散语言模型。
2026 年 10 月 28 日,Clover-35B-A3B。 35B 总参、3B 激活,Apache 2.0,SWE-bench Verified 73.6。它是 Dream 7B 那条「权重转换」路线推到 35B 的结果,架构细节我单独写过一篇。
三条路线:为什么 2025 年后集体转向
把上面这些模型按技术路径重排,会看到一条很清楚的分岔:
| 路线 | 代表 | 成本 | 局限 |
|---|---|---|---|
| 从头预训练 | LLaDA 8B | 极高,要自己训底座 | 只有大厂或有钱的团队玩得起 |
| 自回归权重转换 | Dream 7B、LLaDA 2.0、DiffusionGemma、Clover | 低,省掉底座训练 | 天花板受底座限制,且增益归因说不清 |
| 只给 API | Mercury 系列 | 厂商承担 | 用户拿不到权重,改不了、审不了 |
2025 年底是个转折点。在那之前开源模型基本走第一条路,之后全部转向第二条。原因很朴素:底座不用自己训了。
但第二条路有个副作用,Clover 这次把它暴露得很彻底:如果一个模型是在 Qwen3.6 上改的,它比 Qwen3.6 强,到底强在「扩散解码」还是强在「又训了一轮」?
这个问题不是抬杠。它决定了其他团队该不该跟进:如果增益来自扩散机制,所有人都会受益;如果只是「多训了一轮」,那说明不了范式优劣。想验证的话,自己压测一遍比读发布稿快。
官方没拆开。 这是我认为读这类论文和发布稿时最该盯的一处。
三道坎:五年里一直卡着的地方
模型名字换了五六代,技术难题其实还是那三个。
第一道坎:KV cache 用不了
自回归模型有个巨大的工程红利:KV cache。生成第 N 个 token 时,前面所有 token 的 Key 和 Value 都缓存着,不用重算。整套推理栈(vLLM 的 PagedAttention、continuous batching、前缀缓存)全部围绕这个设计。
扩散模型用双向注意力,整个画布同时更新,朴素 KV cache 直接失效。LLaDA 论文的「局限」一节明确写了没应用 KV cache 这类系统优化。
解法是 Block Diffusion(Arriola 等,2025):块间自回归,块内扩散。已生成块的 KV 缓存下来传给下一块,只有正在去噪的那一块不吃缓存。Clover 的递归状态压缩、DiffusionGemma 的多画布采样,本质都是这个思路的变体。
这道坎解释了为什么扩散模型喊了五年速度优势,落地却慢:光改模型不够,整套推理基础设施要重写。
第二道坎:固定画布和变长输出
自回归生成是天然变长的:吐到 EOS 就停。
扩散要先铺一个固定长度的画布(Clover 是 32 token 一块,DiffusionGemma 是 256 token 一个画布),再往里填。早期 LLaDA 的做法很笨:整段回答的长度要用户当超参数传进去。
三种解法各有代价:MDLM 把已生成序列的尾部当固定前缀复用;Block Diffusion 缓存已生成块的 KV;DiffusionGemma 用多画布采样,一块定稿后过一遍编码器塞进 KV cache,再生成下一块。
Clover 的解法是「低置信度也要填一个」:一块里所有位置都不达阈值,就强制填置信度最高的那个,保证永远有进展。用确定性换掉死循环风险。
第三道坎:质量与速度的取舍
扩散的速度优势不是免费的。去噪步数少则快,但内容没调整好;步数多则质量上来,算力开销也跟着涨。
这道坎最直接的证据是 DiffusionGemma:谷歌自己在每个公布的基准上,它都落后于同尺寸的 Gemma 4。谷歌对它的定位也很明确,面向实验和低延迟交互工具,不是生产环境的主力模型。
Clover 的做法是靠架构和训练把这条曲线往右上角推。SWE-bench 73.6 说明方向对,但 HLE 只有 12.8 分(两个 Qwen 都在 21 上下)说明还没推到位。
已经跑通的落地场景
抛开跑分,这几年真正验证过价值的场景就那么几个:
上下文压缩。 Inception 披露过一组数据:编程工具 Augment Code 接入 Mercury 系列后,上下文压缩耗时从约 150 秒缩短到 27 秒。这是扩散模型最对口的任务:输出被输入严格约束,没有创作自由度,并行去噪收益最大。
代码填空与编辑。 双向注意力天生适合「往中间插内容」,自回归要重写后半部分。
多步 Agent。 每步省几百毫秒,30 步的任务就从两分钟变二十秒。Clover 的价值主要在这儿。
结构化抽取。 表单、表格、JSON,输出形状是固定的,正好是扩散擅长「填满一个结构」的场景。
反过来,一次性长报告和深度推理链这两个场景收益最小。前者不在乎多几秒延迟,后者最强的一定还是自回归。
我的判断:不会替代,会分流
团队创始人龚珊三自己在采访里说过,未来可能出现融合趋势,自回归和扩散在训练或推理中结合使用。这个判断比「三年内全面替代」靠谱得多。
理由在基础设施上。自回归那套 KV cache 加 PagedAttention 的工程体系,是十年积累出来的,扩散要重建一遍。重建的成本只有在「收益明显大于成本」的场景才划得来,而这类场景恰好是结构化、低延迟、多轮调用那一批。
所以更可能的格局是:主力模型还是自回归,扩散在 Agent 的特定环节、端侧、实时交互里占住位置。 这不算失败,找到自己的位置就够活了。
一个信号可以关注:DiffuSpace 和端侧平台 Acrab 的合作、与 SigmaZ 联合把吞吐往 2000 tok/s 推。如果端侧这条路走通,扩散模型的位置会比在云端更稳——因为端侧最缺的就是延迟预算。
常见问题
扩散语言模型和图像扩散是一回事吗?
思路同源,实现不同。图像是连续像素,可以直接加高斯噪声;文本是离散 token,要么加掩码(masked diffusion,主流做法),要么在嵌入空间加噪。Clover、LLaDA、DiffusionGemma 都是掩码路线。
为什么 DiffuSeq 到 Clover 要五年?
前三年在解决「能不能做」,2025 年解决「能不能追平」,2025 年底找到「权重转换」这条降本路径,2026 年才走到「规模化还不掉速」。每一段都卡了至少一年。
开源的和 API 的差距有多大?
质量上 API 侧(Mercury 3)目前仍领先,因为闭源模型可以用更多数据、更激进的蒸馏。开源侧胜在能改、能审、能离线跑。选哪个看你是否需要碰权重。
现在学这个方向值不值?
如果做推理优化,值。这套「块间自回归 + 块内扩散」的结构对 cache 管理、调度策略的理解要求比自回归高,是稀缺技能。如果只是做应用层,先按黑盒用就行。
Clover 之后下一个节点会在哪?
两个方向在跑:多模态(团队明确说了 Clover 会出多模态版本)和端侧(和 Acrab 的软硬件协同)。规模继续往上推的收益可能不如把长程稳定性做好。
结语
五年、三代模型、三条路线,扩散语言模型终于走到了「能下载、能服务、能在特定任务上打平自回归」这一步。但它离取代自回归还很远,卡的不是算法,是整个推理基础设施。
我的建议是把它当成一个新的工程选项而不是新的信仰:你手上如果有那种「高频调用、输出结构化、对延迟敏感」的环节,值得花一天用 Clover 或 DiffusionGemma 试一遍。 试完再判断值不值,比看跑分可靠。
参考资料
- 扩散语言模型技术演进梳理 - 完整时间线与技术对比
- Clover 官方发布博客 - 双向 GDN 与块扩散实现
- 科创板日报专访 - DiffuSpace 融资、Dream 7B 起点与团队路线判断
- Mercury 3 与开源扩散模型对比 - 参数、速度与本地部署条件
- LLaDA 论文与 Block Diffusion 相关工作 - KV cache 失效问题与解法
- 第一道坎:KV cache 用不了
- 第二道坎:固定画布和变长输出
- 第三道坎:质量与速度的取舍
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。