
一句话总结:11 月 2 日乌镇世界互联网大会开幕,主题直接定成「开源开放 共建共享」,全国首个开源主题体验馆在开幕前一天开馆,牵头单位是国家网信办和新华社。腾讯把 Hy4 正式版开源插在峰会期间,跟阿里 Qwen4 同代对撞。一边是全球许可证在收紧,一边是国内把开源捧到 C 位,这两件事同时发生,说明开源在中国已经不只是技术选择。
一、开源的规格变了:网信办和新华社牵头
11 月 1 日,乌镇世界互联网科技馆里开了个馆,叫开源主题生态体验馆。
牵头的是国家网信办和新华社,共建方包括浙江发改、科技等多个部门。一个技术主题能拿到这个级别的牵头单位,本身就说明了态度。
第二天峰会开幕,主题八个字:开源开放,共建共享。往年的热词是元宇宙、数字经济、大模型,今年轮到开源。而且不是放在某个分论坛的边角,是直接推上主位。
我认为这个变化的关键不在「重视开源」,在于开源的性质变了:从「我们参与别人的项目」,变成「我们把自己的底座开放出去」。
二、国产开源的三条路线,目标完全不同
这届峰会上开源的东西不少,但按动机能分成三类。
第一类,大厂对撞。 腾讯把新一代大语言模型 Hy4 的正式版开源,时间点就卡在峰会期间。阿里 Qwen4 是同一代的对手。两家在同一时间把自己的旗舰放出来,这在过去很少见。
这不太像是「我们热爱开源」,更像是抢生态位:谁的模型先被开发者用起来,谁的后面几年就更省力。
第二类,补空白。 之江实验室的 021 科学基础模型,用 MoE 加 OneTokenizer 的架构训了 2360 亿参数,已经上线开放。官方说法是填补国内 AI 科学基础模型的空白。
科学基础模型这个方向,商业公司不太愿意碰,因为短期变不了现。这类东西只能靠国家队。
第三类,做底座。 魔搭 ModelScope 已经是国内最大的模型开源社区。OceanBase 开源五年,核心代码超过 500 万行,部署超过 20 万套。蚂蚁的百灵基础模型和灵波 LingBot 具身模型也放出来了,其中 LingBot 开源九个月下载破 220 万。
这一类不直接跟谁竞争,它提供的是别人往上盖楼的地基。
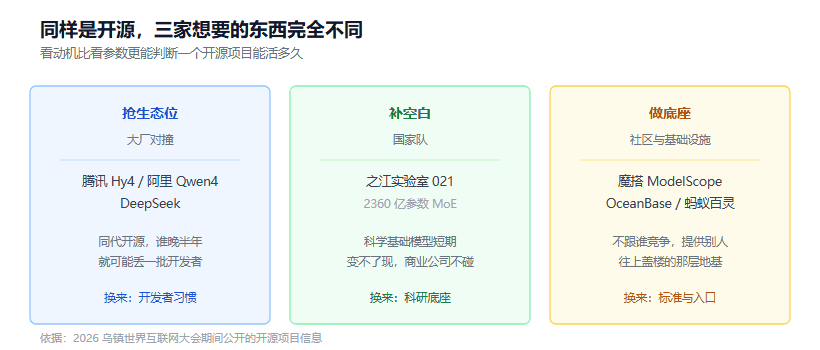
图 1:同样叫开源,三家的动机和收益完全不同
三条路线加起来,才是「开源三剑客」这个说法的完整意思:之江 021、DeepSeek、千问代表的是模型层,但撑住这个场子的还包括社区和数据库这些看不见的部分。
三、Hy4 和 Qwen4 同代对撞,比参数有意思
腾讯 Hy4 和阿里 Qwen4 同代开源,我觉得这是今年最值得盯的一个信号。
原因在于,开源模型的竞争已经从「追赶闭源」变成「互相追赶」。
前两年国内厂商开源,参照系是 GPT 和 Claude,目标是把差距缩小。现在头部几家的能力已经很接近,互相之间成了主要对手。同代对撞意味着:谁晚半年,就可能丢掉一批开发者。
这个竞争对使用者是好事。模型会更快迭代,价格会被压下来,工具链也会更完善。
但也有代价。开发者要花更多时间做选型和迁移,上一代刚调好,下一代又来了。站里过度封装那篇说的就是这个痛:接口换得比你的封装更新快。
四、一边捧开源,一边收紧许可
这里有个矛盾值得摊开讲。
国内在把开源推上 C 位的同时,全球范围的许可证正在收紧。
智谱 8 月放 GLM 5.3 权重时,把 MIT 换成了自有许可;Mistral Large 4 允许下载微调,但对外提供模型服务要单独谈商业授权;Kimi 的许可一直没给到 MIT 那一档。我在开源许可证那篇里算过这条线。
两件事看似打架,其实各有各的逻辑。
西方厂商收紧许可,是在守商业价值。 模型的训练成本是实打实的,放 MIT 意味着谁都能拿去开 API 转售。
中国厂商高调开源,是在抢标准。 模型能力追平之后,决定胜负的是有多少人用你的东西。开源是最快的铺开方式。
所以这两件事不矛盾,是两种处境下的两种理性选择。判断标准也不同:前者看能不能赚钱,后者看能不能占位。
五、开源权重对开发者意味着什么
说点实际的。
第一,权重拿得到,不等于跑得动。 2360 亿参数的 MoE,普通人部署不了。开源在这里的意义是「可审计、可微调」,不是「可本地跑」。真正能本地跑的还是 7B 到 30B 那档。
第二,许可条款要一条条读。 国内的「开源」有大半是自有许可,商用条件各不相同。别看到「开源」两个字就当 MIT 用。
第三,工具链比模型更重要。 魔搭这类社区的价值不在模型数量,在于配套的推理框架、量化版本、部署文档。模型换了能三天迁完,靠的是这些东西。
六、坑与边界
其一,「首个开源主题体验馆」这类表述来自官方通稿,我没法独立核实。 但从牵头单位看,规格是真的。
其二,Hy4 和 Qwen4 的实际能力对比,我没有实测数据。 这篇只讨论两个模型同代开源的策略含义,不评价谁更强。要选型请自己跑分。
其三,之江 021 的 2360 亿参数是总参数,激活参数官方没说。MoE 的实际推理成本看激活参数,不看总量。
结语
乌镇这次把开源放 C 位,我认为不是一次会议主题的选择,是产业阶段变了。
前几年大家比的是「谁先做出来」,现在比的是「谁的东西被别人用」。后者的胜负不在实验室里,在开发者的选择里。
对做技术的人来说,这个变化是好事:选择变多了,成本变低了。但要留个心眼:多读许可,少看宣传。
给个能马上做的动作:去魔搭上搜一下你正在用的那个模型的量化版本,看有没有官方维护的。有,说明这个模型的社区是活的;没有,说明它只是发了个权重。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。