
一句话总结:独立机构 METR 评估后认为 Anthropic 自 2025 年 10 月以来的能力进步速度是先前的 1.9 倍(95% 置信区间 1.5–2.8),但 Anthropic 删减了部分关键证据,公开材料不足以独立重建计算过程。
11 月 5 日,METR 发布了一份对 Anthropic 的评估。
结论先说:Anthropic 内部能力的进步速度,大约是 2024 到 2025 年那一波的 1.9 倍。
这个数字不是 Anthropic 自己报的,是独立机构算的。听起来比厂商自吹可信。
但这份评估里有一个细节,比 1.9 这个数更值得注意。
这份评估测的是什么
先明确对象:不是"模型变强了多少",是"能力进步的速度变了多少"。
METR 用了三类材料:Anthropic 内部的模型指标、员工访谈、研发流程数据。评估的窗口是 2025 年 10 月之后。
它想回答的问题是:AI 辅助研发有没有让"造出下一代模型"这件事变快。如果答案是肯定的,就意味着迭代周期在缩短——这对预测未来一两年的模型节奏影响很大。
1.9 倍的置信区间:1.5 到 2.8
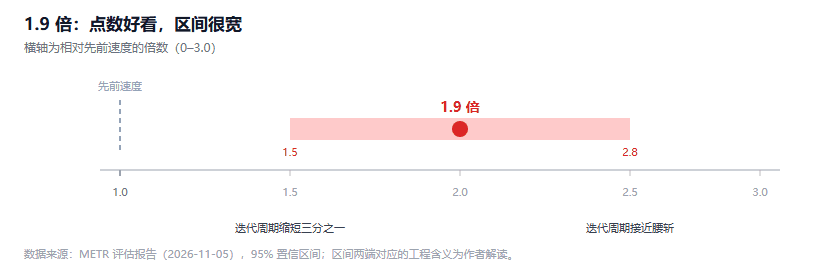
图 1:横轴为相对先前速度的倍数。1.0 是"和先前一样快"的参照线,95% 置信区间为 1.5–2.8。数据来源:METR 评估报告(2026-11-05)
95% 置信区间是 1.5 到 2.8。
这个区间宽得值得停下来想一想。1.5 倍和 2.8 倍是完全不同的两个结论:
- 如果是 1.5,说明 AI 辅助研发有一点用,但迭代周期只缩短了三分之一
- 如果是 2.8,说明迭代周期接近腰斩,下一代模型会明显提前
区间宽意味着数据不够,或者数据噪声大。METR 敢把区间标出来,比给一个漂亮点数更诚实。
「约 80%」是主观归因
报告里还有一句更容易被摘出来传播的话:AI 辅助研发可能解释了当前加速的大部分,约 80%。
METR 自己给这句话的定性是:带有显著不确定性的主观归因。
翻译一下:80% 不是算出来的,是受访者估计的。员工被问"你觉得 AI 帮了多少",答了一个数,METR 把它记下来了。
主观归因不是没用,它提供方向。但它不能当证据用——人对自己效率的估计,偏差是出了名的大。PLE 那个工程基准用的也是专家出题加专家评审的组合,同样的坑:评审的人自带立场。
被删掉的证据意味着什么
这是整份评估里最扎眼的一条:Anthropic 对部分关键证据进行了删减,公开材料不足以独立重建全部计算过程。
换句话说,METR 拿到的材料是被剪过的。1.9 这个数,外人无法从头算一遍。
这带来一个结构性的尴尬:评估方是独立的,数据是被评方给的,而且给的是删节版。
这类评估有个专有难题——被评的模型和能力本身就是被评方的商业机密,全公开等于泄密。但删太多,评估就退化成"我对你说什么你信什么"。
METR 的处理是把删减本身写进报告。这份诚实值得肯定,但它也划出了这类评估的天花板:你最多只能信到数据允许的程度。
被评方拿着红笔的评估还有多可信
把这份评估放到一个谱系上看:
一端是厂商自报。模型卡上那些 SOTA 字样,全是自己的 benchmark 自己跑。
另一端是全公开可复现。论文附带代码和数据,谁都能从头跑。
METR 这份在中间偏可信的一侧:评估方独立、方法论公开、但底层材料被评方掌管。
对读者来说,实际的操作是:把 1.9 倍当作"方向可信、数值存疑"的信号。方向是"Anthropic 在加速",这个有多方旁证;数值是 1.5 还是 2.8,现在下不了结论。
关于 METR 评估的五个问题
METR 是谁? 一家专门评估 AI 能力与风险的独立机构,之前以测评模型自主完成任务的水平出名。
1.9 倍是快了还是慢了? 是加速:能力进步的速度变成先前的 1.9 倍。不是"能力是 1.9 倍"。
为什么窗口从 2025 年 10 月算起? 报告没细说,大概率对齐了 Claude 某个内部版本的上线时间。
删掉了多少? 报告只说"部分关键证据"。删了什么、为什么删,公开材料没有。
这能预测下一代模型的时间吗? 不能直接推。区间太宽,而且加速是否持续本身是外推。
结语
这份评估的看点不是 1.9,是它的读法。
一个独立机构,用被评方删节过的材料,给出一个区间宽到 1.5–2.8 的结论,并且把"证据不足"明明白白写出来。这在当下的 AI 报道里算稀有物种。
上周写 Realtime-Bench 时提过一句:看到任何能力数字,先问是哪种时钟。这篇补一句:还要问是谁数的、按什么口径数的、材料给全了没有。
数字本身会过期,这三个问题不会。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。