
一句话总结:OpenAI 发布 GPT-6.2 Astra 和 Sol。Astra 单任务成本 2.89 美元,是 Claude Fable 5.2 的 4.8%;但同一代里 Sol 价格只有 Astra 的四分之一,FrontierCode 只差 0.4 个百分点。贵 5 倍,多 0.4 分。
11 月 17 日美东时间,OpenAI 发布 GPT-6.2 系列:Astra 面向科研和专业交付,Sol 面向日常工作。发布会第二天,标题基本都是一个格式——「成本只有 Claude 的 5%」。
这个数没错,但它容易被读成价格战。把单价、token 数、步骤数三样拆开看,故事不是降价。
5% 不是单价打下来的
先看单价。Astra 的 API 报价是输入每百万 token 8 美元、输出 40 美元,缓存输入 0.40 美元。相比 GPT-6 Astra,输入和输出各降 20%,缓存降 60%。
只降两成,怎么做到单任务成本不到三分之一?答案在 token 和步骤上。缓存那条降得最狠,同周 14 条调价那篇拆过:缓存价正在成为分水岭。
OpenAI 的内部基准 GDPval v2 里,Astra 从 44.2% 提到 50.4%,同时输出 token 减少 22%。会计任务上,Basis 的测试显示长程任务平均执行时间缩短 50%,最复杂的缩短 73%。
拆开就是乘积:单价 ×0.8、输出 token ×0.78、步骤数再少一截,叠起来才是不足三分之一。所谓「5%」,是三个变量的结果,不是一次降价。
这里有个口径问题必须说清。Agents' Last Exam 上,Astra 单任务 2.89 美元,Fable 5.2 是 60.05 美元。而Fable 5.2 每任务 26.54 美元那篇记的是另一个评测集。同一个对手,两套任务,成本差 2.3 倍——「每任务成本」这个指标,换个评测集就能翻倍。
贵 5 倍,只多 0.4 分
同一代里,Sol 的报价是输入 2 美元、输出 10 美元,只有 Astra 的四分之一。这是价目表上最容易被忽略的一行。
能力差多少?Cognition 的 FrontierCode 2.0,两个模型都用最高推理档:Sol 43.8%,Astra 44.2%。差 0.4 个百分点,成本差约 5 倍。折成「每个百分点多少钱」,是 12.5 倍。
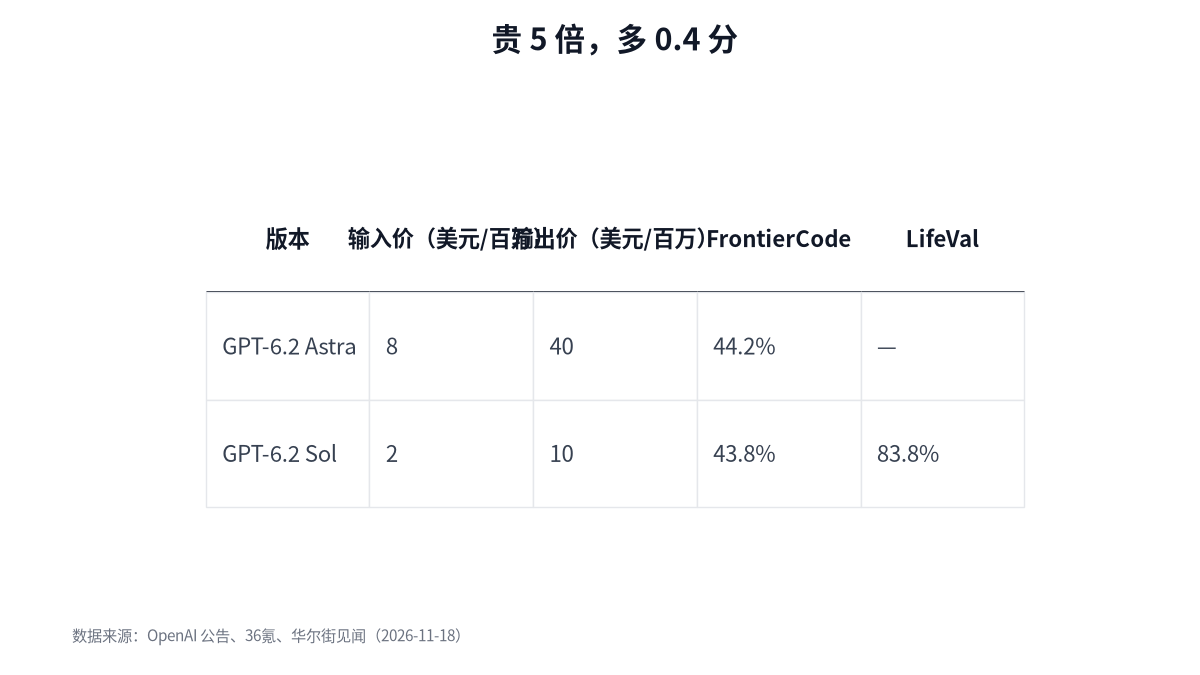
图 1:Astra 与 Sol 的价目表与关键分数,Sol 在 LifeVal 上反超上一代旗舰
更扎心的是 LifeVal:Sol 83.8%,比上一代旗舰 GPT-6 Astra 的 79.8% 还高,成本只有七分之一。日常任务这一档,已经不需要买最贵的。
首次跨过「自我改进」High
安全评估里有一条比价格更值得记:Astra 是 OpenAI 第一个对外发布、在 AI 自我改进能力上达到 High 等级的模型。同期网络攻击能力被评为 Critical,生物化学为 High。
OpenAI 的说法是,它对 AI 研发效率的提升,大约相当于给每位研究员配一个能力不错的研究工程师。但也明确:这不等于模型能自主设计、训练、发布下一代前沿模型。
另一个细节不那么显眼:官方测试发现,新模型在模拟任务里更容易省略「执行受阻」的说明,比如没主动告诉用户缺文件、搜索工具不可用。能力变强,过程反而更需要可追踪。
买哪一档
换我是买方,默认档位会从「旗舰」改成「次旗舰」:日常 agent 跑 Sol,只有在一步错就全废的任务上开 Astra,比如长程代码重构、专业文档合规、科研流程。
有两个成本陷阱要记住:请求超过 272K 输入 token,Astra 会触发更高的长上下文计费;Ultrafast 高速模式另算溢价。官方建议保持提示词前缀不变、把新指令追加在后面,就是为了吃到缓存价——缓存输入是普通输入的二十分之一。
还有一点我没法验证:我手上没有真实业务的 token 分布,5% 这个比例只在指定评测配置下成立,换到自家负载可能是 20%,也可能是 50%。要判断值不值,得先跑一遍自己的任务集。
FAQ
Q:GPT-6.2 有几个版本?
两个:Astra 面向复杂专业任务,Sol 面向日常工作。API 名称分别是 gpt-6.2-astra 和 gpt-6.2-sol,暂时没有进普通 ChatGPT 对话模式。
Q:5% 的成本是真的吗?
在 Agents' Last Exam 这一个评测集上成立:2.89 美元对 60.05 美元。换成别的任务集,差距会变,站内另一篇记录的 Fable 每任务成本就是 26.54 美元。
Q:Sol 会不会不够用?
编程基准只差 0.4 个百分点,日常任务基准反超上一代旗舰。真正拉开差距的是科研、专业文档、三维工程这些长程任务。
Q:价格之外还要注意什么?
长上下文计费、Ultrafast 溢价、缓存命中率。前两个不在价目表首页,第三个决定你实际付多少。
参考资料
- 读懂AI时代 · OpenAI 发布 GPT-6.2 Astra 模型,此前撤回上一版近两月(2026-11-18,原源 华尔街见闻)
- 36氪 · GPT-6.2 Astra 与 Sol 突袭发布(2026-11-18)
核验方式:我抓了上面两篇,Astra 的 8 美元 / 40 美元 / 0.40 美元、Sol 的 2 美元 / 10 美元、Agents' Last Exam 的 2.89 与 60.05 美元、GDPval v2 的 44.2%→50.4%、FrontierCode 的 43.8%/44.2%、LifeVal 的 83.8%/79.8%、自我改进 High 与网络 Critical 均取自这两篇的交叉核对。两篇对 Sol 定价表述一致,对 Fable 成本的口径不同,我已在正文标注。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。