
一句话总结:阿里 Qwen 团队与清华、南洋理工的一篇论文发现,大模型在末尾约 5% 的层里会发生「改口」:更新幅度突然涨到中间层的 2 到 3 倍,输出方向与前一层的相似度从 0.91–0.97 骤降到 0.69。研究者把这段变化叫「对齐税」——模型为了显得得体,在末尾放弃了自己原本更准的答案。
前阵子调一个分类任务,同一个模型、同一个 prompt,只改了输出格式的描述,准确率掉了 6 个点。
我以为是 prompt 写得不好,反复调了两天。后来才想明白,掉的那 6 个点不在 prompt 上,在模型「想说」和「敢说」之间。
这两天翻到一篇论文,把这个感觉讲清楚了。是阿里 Qwen 团队和清华、南洋理工合作的,2026 年 6 月挂在 arXiv 上,编号 2606.21906。我当时没注意,最近才看到二手转述。
先把口径说清楚:我没读全文,下面所有数字都来自那篇转述,不是论文原文。
一、对齐税的现场:相似度从 0.97 掉到 0.69
论文测的是相邻两层输出方向的余弦相似度。这个指标衡量的是「这一层有没有把方向掰弯」:接近 1 说明只是微调,掉下来说明拐了弯。
结果分三段,非常整齐:
- 前 15% 的层:输出粗糙、噪音大,相似度波动剧烈
- 中间 15% 到 95%:相似度稳定在 0.91 到 0.97,模型沿着一条语义轨迹稳稳往前走
- 末尾 5%:更新向量的幅度突然涨到中间阶段平均水平的 2 到 3 倍,输出与前一层的相似度掉到 0.69
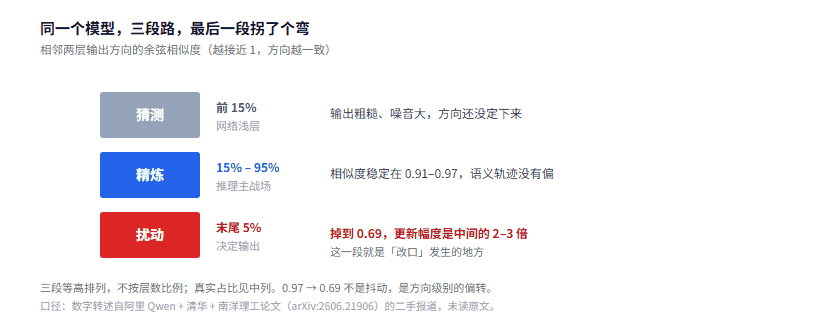
图 1:中间那 80% 的层在稳稳推进,末尾 5% 突然拐了个弯
0.97 到 0.69,不是小抖动。这是「方向被改了」。
论文给这三个阶段起了名字:猜测、精炼、扰动。猜测阶段给方向,精炼阶段做推理,扰动阶段……改口。
二、三个阶段:猜测、精炼、扰动
拆开看,这三段各自在干什么。
猜测(前 15%)。 模型刚接触问题,内部表示还很模糊。就像一个刚听完题目的人,脑子里有个大概方向,但说不清。这阶段输出噪音大是正常的,不应该在这里取答案。
精炼(15% 到 95%)。 这是真正干活的部分。注意力机制一层层整合上下文,每层都在朝更精确的方向推进。相邻层相似度维持在 0.9 以上,说明没有走弯路。
扰动(末尾 5%)。 这里出现了反常:更新幅度突然放大,方向明显偏转。
我一开始以为「幅度变大」可能是输出层投影造成的,毕竟末尾几层要投影到词表空间,数值本来就会放大。但论文测的是方向(余弦相似度),不是数值大小。方向偏了,就不是投影的问题。
三、对齐税从哪来:把答案往「得体」推
论文的解释是:模型经过 RLHF 之后,学会了一件事——在说出答案之前先检查「这么说合适吗」。
合适的标准包括礼貌、安全、通用、不冒犯。这些标准是在人类反馈里学到的,训练时确实提升了体验。但它们和「准确」不是一回事,有时还冲突。
举个具体的例子。你问模型一个技术问题,它在中间层算出的答案是「这个方案在并发超过 500 时会崩」。到了末尾几层,这句话可能变成「这个方案在多数场景下表现良好,但在高并发下需要注意」。
信息没丢,但力度弱了。 前者是个明确判断,后者是一句谁都不会出错的话。
这就是「对齐税」:为了得体,付出的准确性代价。
腾讯混元 Hy4 那组数字可以侧面印证这类问题的存在。它在金融场景的幻觉率从预览版 12.95% 降到 7.2%,猜测错误率从 23.1% 降到 5.6%。这些都是「说得不准」的量化。厂商在优化它,说明它确实存在。
四、取中间层的答案:这个发现怎么用
论文提出的方法是:不要取末层的输出,取「改口之前」那个时刻的。
具体做法有两类思路。
第一类,探测式。 在推理时监控相邻层的相似度,找到相似度开始骤降的那一层,取它前一层的隐状态。这个方法不需要重新训练,但要在推理框架里开一个口子,能读到中间层。
第二类,训练式。 训练时就把中间层的输出也接一个分类头,让「中间答案」本身成为一个可用输出。代价是要改训练流程,好处是推理时不用探。
我的判断是这两条路都还没到能直接用的程度。 原因是工程上有个硬约束:主流推理框架(vLLM、SGLang、TensorRT-LLM)都是按「跑到末层然后采样」设计的,没有「中途取一份」的接口。要么改框架,要么像 投机解码那篇那样在外面加一层,都有成本。
不过有个更简单的用法:如果你在做评测,这个发现提醒你换一种问法。
同一个问题,问「这个方案有什么问题」和问「这个方案适合什么场景」,模型走的路径不同。前者的答案更接近中间层的判断,后者更容易被末尾的「得体」压平。想拿到真实判断,就别给它留客套的空间。
五、中间层的三个边界
这条思路不是万能的,有三个边界得说清。
一,中间层的答案不一定更准。 论文说的是「被改掉的答案原本更准」,这是针对特定任务(有明确对错)测的。开放式生成里,「更准」很难定义,中间层可能只是更粗糙。
二,5% 这个比例跟模型深度有关。 论文测的是特定规模的模型。40 层模型的 5% 是 2 层,80 层的是 4 层。层数越多,末尾那段的绝对层数越多,比例是否还是 5% 不清楚。
三,这可能只是「输出层投影」的另一种解释。 我保留这个怀疑:末尾几层要把隐状态映射到词表,这个映射本身就需要大幅调整方向。论文用余弦相似度排除了数值放大的干扰,但没排除「投影必然拐弯」这个可能。如果拐弯是投影的必然结果,那「改口」的说法就过强了。
这一条我没法验证,手头没有能跑中间层提取的环境。标存疑。这种「拿一个可测指标去检验一个听起来很顺的说法」的做法,和反解 10.87 倍那篇是同一个路子,那篇拆的是加速比,这篇拆的是「改口」。
六、对齐税常见问题
这篇论文是什么时候发的?
2026 年 6 月的预印本,arXiv 编号 2606.21906。不是这两天的新闻,我在 11 月这波发布潮里才注意到它,属于被漏掉的那类研究。
对齐税能消除吗?
很难完全消除。对齐本身有价值,模型不能什么都不管就直接输出。能做的是减少「为了得体而牺牲准确」的部分,比如训练时区分「安全问题」和「表达偏好」。
普通用户能感知到吗?
能,但不好归因。你问模型一个专业问题,它给了一段四平八稳、谁都不冒犯的话,那时候你感觉到的「这答案没什么用」,可能就是这个。
这对 prompt 写法有什么启示?
两件事。一是别问「你觉得 X 怎么样」,问「X 在什么条件下会失败」。二是如果要一个明确判断,就在 prompt 里明确说「给结论,不要加限定词」。后者能部分绕过末尾那段的软化。
开源模型也有这个问题吗?
按论文的机制推断应该有,因为 RLHF 是通用做法。但不同厂商的对齐强度不同,税负也不同。混元那组幻觉率数据说明国内厂商也在处理这个问题。
七、结语
这篇论文给了一个我以前只能凭感觉描述的东西一个名字:模型不是不知道,是不肯说。
0.97 到 0.69 这个跳变,是整个推理过程里唯一一次方向级别的偏转。它发生在末尾 5% 的层,也就是计算量最小、但决定输出内容的那一段。
我不知道这条路能不能走通。取中间层的答案,听起来像是在让模型「说漏嘴」,工程上要改的东西不少。但它至少指出了一个方向:我们一直在优化「让模型更会说」,也许该花点力气在「让模型敢说」上。
参考资料
- 搜狐 - 阿里巴巴与清华大学联手破解 AI 的「大脑偏差」 - 本文数字均转述自此文,含论文编号 arXiv:2606.21906
- 腾讯网 - 腾讯混元 Hy4 发布 - 幻觉率与猜测错误率的官方口径
- AIToolsRecap - Tencent Shipped Hunyuan Hy4 at 770B - 第三方整理的金融盲测与弱项数据
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。