
一句话总结:Gemini 4 Hydrogen 定价输入 1.5 美元、输出 7.5 美元每百万,混合价 3 美元,比上一代 Flash 快 2.5 倍、Terminal-Bench 从 18.2% 跳到 57%;但它拿到的 51 分和 GPT-6.1 Terra 一样,后者只卖 2 美元。
11 月 13 日 Google 把 Gemini 4 的第三款模型放出来了。Carbon 主打长程推理,Argon 是中间档,Hydrogen 的定位是"高频执行"——说白了就是便宜、快、够用。官方的说法是"把前沿智能带给所有人"。
价格表比宣传语实在:输入 1.5 美元、输出 7.5 美元每百万,在整个 100 万 token 上下文里不分段涨价。这篇把 Hydrogen 放进已有的价格矩阵里算一遍,看它到底站哪个位置。
Gemini 4 Hydrogen 的三个数
第一个数是 51。Artificial Analysis 智能指数,默认 high 思考档 51 分,xhigh 档能到 54 分。对照同门:Carbon 60 分、Argon 50 分。也就是说 Hydrogen 在自家产品线里比 Argon 高 1 分,比 Carbon 低 9 分。
第二个数是 3 美元,混合价(3 份输入配 1 份输出)。同口径下 Carbon 是 4 美元、Sol 是 4 美元、Opus 5.5 是 8 美元、Fable 5.2 是 16 美元。
第三个数是 100 万。上下文全程平价,不分段。这一点比前两个数更有实际意义:长文档、代码库级问答这类活,中间段加价是最疼的,Google 这次没设阶梯。
三个数放一起:51 分、3 美元、1M 上下文。这是个"够用且便宜"的组合,不是能力上限的争夺。
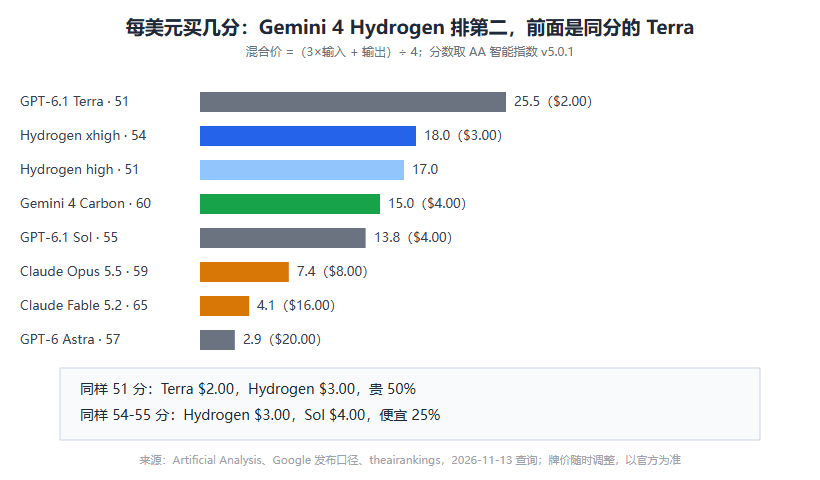
图 1:按混合价折算的每美元买分,Hydrogen 18 分排第二,第一是同分的 Terra
同分不同价:Terra 也是 51 分,价格便宜 50%
这张图里最扎眼的一行不是 Hydrogen。GPT-6.1 Terra 也是 51 分,混合价 2 美元,比 Hydrogen 便宜三分之一;按每美元买分算,Terra 25.5 分,Hydrogen 17 分,差 50%。
同分不同价在市场里很常见,原因是分数只是一个切面。Hydrogen 多出来的钱买的是别的东西:1M 上下文的平价、比 3.8 Flash 快 2.5 倍的速度、Terminal-Bench 上 57% 对 18.2% 的跃升。这些不体现在综合分里,但在具体任务上差得很远。
我的判断是:综合分相同的时候,看单项和长上下文。要跑长文档、代码库、多轮 agent,Hydrogen 那 1 美元溢价买得值;只做短问答和分类,Terra 更划算。按综合分挑模型是省事的做法,也是最容易踩坑的做法。
Terminal-Bench 从 18.2% 到 57%
这个跃升值得单独看。Terminal-Bench 4.1 考的是在终端里完成真实操作任务,18.2% 到 57% 是 38.8 个百分点的绝对提升,相对提升 3.1 倍。
这个幅度说明 Hydrogen 不是简单的 Flash 换皮。终端的活要连续执行命令、读输出、纠错,考验的是多步执行的稳定性。上一代模型在这类任务上掉链子,经常是第二步就跑偏。57% 依然意味着四成任务失败,但相对 18.2% 已经是另一个物种。
配套的还有速度:比 3.8 Flash 快 2.5 倍。速度和成功率在 agent 场景里是乘法关系——同样跑一小时,2.5 倍速度意味着能试 2.5 倍的方案,成功率低一点也能靠重试补回来。
100 万上下文平价:喂满一次 1.5 美元
把整个代码仓库喂进去做问答,输入侧就是 100 万 token。Hydrogen 收 1.5 美元,Carbon 收 2 美元,Fable 收 8 美元。同一次操作的成本差 5.3 倍。
这个差额在小规模试用时看不出来,规模化以后是决定性的。一个 50 人团队每天各跑 10 次全仓库问答,一天 500 次、每次 1.5 美元是 750 美元;用 Fable 是 4000 美元。一个月下来差 10 万美元。
输出侧的账不同。Hydrogen 的输出价是输入的 5 倍,这是行业统一的结构。任务输出占比高的时候(比如生成代码),实际单价会向 7.5 美元靠,混合价 3 美元的估算就不准了。这一点在上一篇算 Fable 的任务成本时也提过:混合价是横向比较的工具,不是账单预测。
上下文分级:Orchestrator 两个模型混着用
Google 同一天上线了 Antigravity 的 Orchestrator,可以在一个会话里动态切 Carbon 和 Hydrogen。官方给的数据是:Terminal-Bench 4.0 上成功率接近纯 Carbon,但配额消耗平均降低 24%、速度快 19%。
这组数字的价值在于它验证了一件事:强模型做决策、弱模型做执行的拆分,确实能在几乎不掉成功率的前提下省钱。agent 账单那篇算过同样的结构:钱集中在少数决策轮,执行轮用便宜模型,账单能砍掉一大半。24% 的配额降幅不算激进,但方向对——架构决策那几步用 Carbon,跑命令、验结果那几十步用 Hydrogen。
自己做类似调度也不难,关键是划清边界:哪些步骤需要判断力,哪些只是执行。划错了要么白省钱,要么白掉质量。
什么活该给 Hydrogen
三类任务匹配度高。终端操作与工具调用,Terminal-Bench 的数字直接对应;代码库级问答与 issue 定位,1M 平价上下文是刚需;批量数据处理,图数据库和 SQL 场景官方说比 3.8 Flash 快 2 到 2.8 倍、省 12% 到 23% 的 token。
两类别用。需要长程推理链条的(多步数学证明、复杂架构设计),Carbon 和 Fable 那一档;输出极长的(整文件生成),输出价 7.5 美元会把成本拉回去,不如找输出价更低的模型。
最后交代一句口径:51 分和 54 分是 AA 在 high 和 xhigh 两个思考档下测的,档位不同不能混着比;每美元买分用的混合价假设输入输出 3:1,你的真实比例不同,排序可能变。价格这东西变动频繁,看的时候对一下官网。
FAQ
Q:Hydrogen 和 Carbon 差在哪?
定位不同。Carbon 主打长程推理,60 分;Hydrogen 主打高频执行,51 到 54 分,便宜且快 2.5 倍。官方建议用 Orchestrator 把两者混着调。
Q:51 分够用吗?
看任务。终端操作、代码库问答、批量处理这些场景,Hydrogen 的单项表现远超综合分暗示的水平。需要长程推理的活不够,得换档。
Q:1M 上下文真的不涨价吗?
官方说法是整个 100 万 token 上下文保持平价,不设阶梯。这在长文档场景里是实打实的差别,中间段加价的模型会让长任务成本翻倍。
Q:和 GPT-6.1 Terra 怎么选?
同分、Terra 便宜 33%。选 Terra 的理由是纯成本;选 Hydrogen 的理由是长上下文、终端能力和速度。两个都要就上 Orchestrator 那类混合调度。
Q:配额消耗降低 24% 是什么意思?
指订阅制下每次任务的额度消耗。成功率接近纯用 Carbon,但配额少花四分之一,速度快 19%,等于同样的订阅额度能干更多活。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。