
一句话总结:Fable 5.2 在 Artificial Analysis 智能指数上以 65 分登顶,但每完成一个任务平均要花 26.54 美元;比它低 10 分的 GPT-6.1 Sol 只要 1.27 美元,分数差 18%,钱差 20 倍。
11 月 10 日 Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2,官方口径是速度提升 30%、成本下降 20%。第二天 Artificial Analysis 的 Intelligence Index v5.0.1 更新,Fable 5.2 以 65 分排到第一,Gemini 4 Carbon 60 分、GPT-6 Astra 57 分跟在后面。发布消息铺得到处都是,价格这件事反而没人细算。
这篇把九个能查到牌价的模型放在一起算一遍:买一分智能要花多少钱、钱花在哪个环节、哪几个价格结构值得警惕。所有数字都标了查询日期,价格这种东西过两周就可能变,看的时候留意口径。
Fable 5.2 和 Sol:分数差 18%,成本差 20 倍
先看两个最扎眼的数。Fable 5.2 在 max effort 下每完成一个 Index 任务平均 26.54 美元;GPT-6.1 Sol 55 分,每任务 1.27 美元。65 比 55,分数差 18%;26.54 比 1.27,钱差 20 倍。
这两个数不能直接说"谁更值",因为 Index 里的任务难度有梯度,头部那几道题可能只有 65 分档的模型能解出来。但对绝大多数日常任务,55 分和 65 分的模型给出的答案,用户大概率分辨不出差别。
我的判断是:这 10 分的溢价买的是"能做最难的那些任务",不是"每个任务都好 10 倍"。如果你一周只有一两次需要顶级推理的场景,专门为那几次调 Fable,其余走便宜模型,账面能省 90% 以上。很多团队的用法反着来,日常全走旗舰,遇到疑难反而没额度了。
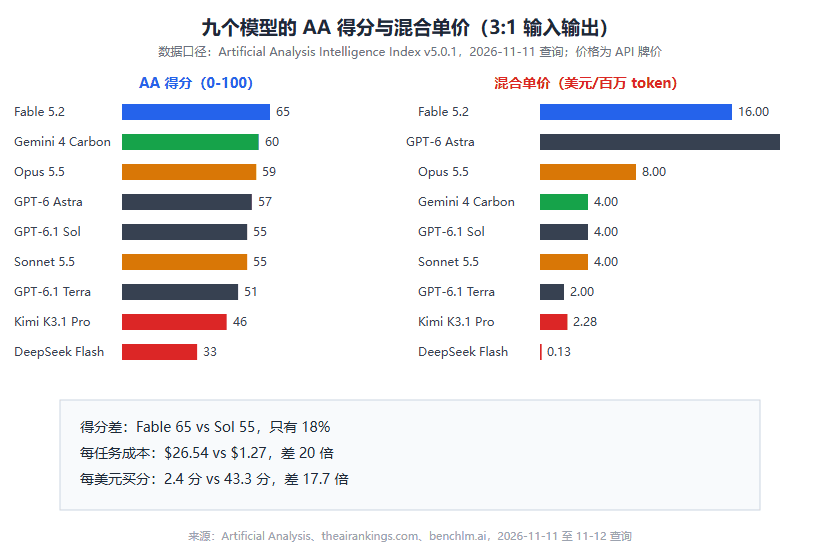
图 1:九个模型的 AA 得分(左)与混合单价(右),Fable 的得分只比 Sol 高 18%,单价高 4 倍、每任务成本高 20 倍
每美元买几分:九个模型的价格表
能查到"每任务成本"的是四个模型,把分数除以成本,得到每美元能买到几分:
| 模型 | AA 得分 | 输入价 $/1M | 输出价 $/1M | 每任务成本 | 每美元买分 |
|---|---|---|---|---|---|
| Claude Fable 5.2 | 65 | 8.00 | 40.00 | 26.54 | 2.4 分 |
| Claude Opus 5.5 | 59 | 4.00 | 20.00 | 10.04 | 5.9 分 |
| GPT-6 Astra | 57 | 10.00 | 50.00 | 6.25 | 9.1 分 |
| GPT-6.1 Sol | 55 | 2.00 | 10.00 | 1.27 | 43.3 分 |
每美元买分这一列,最高和最低差 17.7 倍。同样的预算,选错一档模型,能干的事少一个数量级。
剩下几个模型查不到权威的每任务口径,只有牌价。按 3:1 的输入输出比例算混合价:Gemini 4 Carbon 和 Sonnet 5.5 都是 4 美元、GPT-6.1 Terra 2 美元、Kimi K3.1 Pro 2.28 美元、DeepSeek V4.1 Flash 0.13 美元。混合价是个粗口径,没算缓存折扣,只用来横向比个大概。
还有一个容易被忽略的细节:这四家的输出价都定成输入价的 5 倍。Fable 8/40、Astra 10/50、Sol 2/10、Opus 4/20,全部如此。这不是巧合,下一节单说。
Astra 反例:分数更高,任务成本更低
四行表里藏着一个反直觉的组合。Opus 5.5 得 59 分,每任务 10.04 美元;GPT-6 Astra 得 57 分,每任务只要 6.25 美元。分数低 2 分,钱省 38%。
原因在用法。Astra 的牌价是四家里最贵的(10/50),但它在 Index 任务上花的 thinking token 更少、轮次更短,任务级总账反而低。牌价贵不等于账单贵,effort 设定和任务长度都在中间搅局。
顺带说一个测量口径的坑。Anthropic 自己的表里,FrontierCode 2.0 那一行 Fable 标的是 Xhigh effort、Carbon 标的是 Medium effort,两个分数不在同一档设定上。Anthropic 的表和 Artificial Analysis 的独立复测也对不上:AA 自测的 AutomationBench,Carbon 77.8%、Fable 76.4%,和厂商口径的排名不同。厂商数字当上限看,第三方复测当下限看,中间才是真实水平。这个坑我只有这两个样本,不敢推广到所有榜,但至少看榜时别把两列混着比。
Carbon 限时价 2 美元:窗口到 11 月 30 日
Gemini 4 Carbon 的标准牌价是 4/20,和 Opus 5.5 完全一样;但 Google 给了限时价,输入 2 美元、输出 10 美元,11 月 30 日截止。窗口期内它是闭源阵营里分数最高的"每美元买分"选手:60 分配 4 美元混合价。
访问路径也变了。发布时只对通过 Fairwind Program 的安全防御人员开放,11 月 10 日起所有付费 API 开发者都能调,Google AI Ultra 订阅用户在 App 里也能用。也就是说 11 月这半个月,60 分档的模型实际卖 55 分档的价格。
这里有个不确定的点:限时价结束后 Google 是回到 4/20 还是直接定新价,官方没说。按以往惯例大概率回标准价,但这是我猜的,不是官方口径。窗口期内有批量任务需求的,值得把 Carbon 排进调度。
输出 token 定价五倍:账单怎么形成
四家全部输出 5 倍于输入,这个比例值得单独说。定价逻辑不难理解:生成一个 token 要逐个算前向,输入部分一次并行算完,输出侧的计算密度高几倍,且推理集群的显存带宽被自回归解码吃满。
对账单的实际影响取决于你的任务形态。翻译、长文档摘要这类输入多输出少的活,输出溢价对你影响不大;代码生成、写长文的活,输出占比高,账单会被 5 倍价迅速放大。这正是把输出价设成五倍想要的效果:先按住 token 数,再在输出侧把账单放大。上一篇拆英伟达营收结构时提过,定价结构比总量更能说明一家公司把谁当付费主力,模型定价是同一个道理。
所以比价别只看混合价。你的任务输出占比如果超过 30%,该用输出价当第一排序键;输入巨长的检索类任务,才轮到输入价说话。同一家的两个模型,混合价排序和你的真实账单排序可能完全相反。
开源阵营在另一条轴上:46 分和 0.24 美元
闭源榜打得热闹时,开源那边是另一番景象。月之暗面 11 月 4 日开源了 Kimi K3.1 Pro 权重,AA 得 46 分,API 牌价 0.24/8.41 美元;DeepSeek V4.1 Flash 33 分,输入 0.01 美元,闲时甚至到过 0.15 美元每百万的量级。
46 分对 65 分,看着差得远,但开源模型的卖点是另一件事:权重在自己手里。K3.1 Pro 的权重有 1.56TB,自托管是笔独立的账,这篇不展开,后续单独算。只想说明一点:当 46 分的模型可以免费部署、33 分的模型输入价只有旗舰的千分之几时,"闭源 65 分"的定价就不再是唯一锚点。
这套打法在算力报价那篇里出现过:卖方报一个最好看的单价,采购方要自己把总账算完。科创板日报 11 月 12 日引述 Menlo Ventures 的报告:美国企业开源模型支出里 89% 流向中国模型,其中 Kimi 占 61%。闭源三强在榜单上拉开差距的同时,钱正在流向榜单的另一头。这两件事同时发生,本身比任何单一排名都更有信息量。
怎么选:三档就够
说了这么多数字,给个可操作的结论。按我自己的用法,日常任务用 Sol 或 Carbon 限时价这一档,55 到 60 分,每任务一两美元;疑难任务单次调 Fable 或 Astra,前者分高、后者每任务反而便宜;量大且不敏感的批处理走开源 API 或自托管,DeepSeek Flash 一百万 token 一毛钱的输入价,闭源阵营没有对手。
选型的错误很少出在"选了差的模型",更多是"所有流量都走同一档"。三档分层之后,同样的预算能覆盖的调用量差出十几倍。榜单每周都在变,这周是 Fable 65 分,下个月未必;但"分数差 18%、价格差 20 倍"这个结构,从 Opus 时代到现在一直没变过。
FAQ
Q:Fable 5.2 和 Mythos 5.2 是什么关系?
同一底层模型,Mythos 是削减了安全护栏的版本,只对通过审核的组织开放。普通用户能接触到的只有 Fable。两者能力口径一致,选择完全取决于合规要求。
Q:65 分的模型比 55 分的强在哪?
主要在最难的那一小撮任务上。Intelligence Index 的任务有难度梯度,55 分档的模型在中等难度上已经够用,65 分档拉开差距的是前沿推理、长程 agent 这类尾部任务。日常问答和常规编码,两者差异很难感知。
Q:每任务成本 26.54 美元是怎么算的?
这是 Artificial Analysis 跑完一个 Index 任务的平均花费,包含全部输入、输出和 thinking token,按 max effort 档测量。它反映"跑一遍测试套件的真实账单",不等于你单个请求的价格。
Q:混合价 16 美元是什么意思?
按 3 份输入配 1 份输出的比例,对输入价和输出价加权平均的结果。它是横向比较用的粗指标,不对应任何真实任务的账单。输出占比高的任务,实际单价会向输出价靠。
Q:限时价 11 月 30 日之后还能用 Carbon 吗?
能用,但价格大概率回到 4/20 的标准档。届时它的性价比要重算:60 分对 8 美元混合价,大致落在 Opus 5.5 的位置。是否还值得选,取决于它到时在 coding 榜上和 Opus 的相对位置。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。