
一句话总结:英伟达和 UT-Austin 拉了 50 个实时任务、12 个前沿模型做测试,最强的 GPT-6-Astra 按真实推理耗时推进时只有 44%,连过三次的概率掉到 36%;而加大推理强度对一部分模型是加分,对另一部分是减分。
上周有人在群里问,为什么他那个"实时报价提醒"的 agent 明明模型很强,却总是慢半拍。
我让他把日志贴出来。问题不在模型答得对不对,在于它答的时候价格已经变了。这类任务有个共同点:环境不等你。而目前几乎所有 benchmark 都假设环境是静止的——你思考多久,世界都不动。
Realtime-Bench 就是冲着这个假设来的。
Realtime-Bench 测的不是「反应快」
基准一共 50 个任务,覆盖 8 类场景,考三件事:实时感知(世界变了没有)、时间自适应推理(该想多久)、行动时机(什么时候动手)。
这三件事和"低延迟"不是一回事。低延迟是基建指标,这三件事是决策指标。一个 200 毫秒返回但踩错时机的模型,比一个 2 秒返回但踩对的模型更糟。
评测方式也按这个思路设计:不看单次成功,看 Pass^3——同一任务重复三次全部成功的概率。理由很直白,实时任务失败一次就没了。抢票失败不能重来,报价错过就是错过。
这个指标比 Pass^1 残酷得多。44% 的单次成功率,三次全过就只剩 36%,掉了 8 个百分点,相对跌幅 18%。
实时交互的三种时钟协议:同一道题,三种世界
这是整篇论文里最值得抄的设计。环境推进的方式分三种:
| 协议 | 环境怎么走 | 考的是 |
|---|---|---|
| Paused Clock | 模型思考时环境冻结 | 纯决策质量 |
| Token Clock | 按生成的 token 数推进模拟时间 | 时间感知,排除服务速度 |
| Wall Clock | 按真实推理耗时推进 | 真实部署下的表现 |
同一道题、同一个模型,换一种时钟,最优策略就变了。Paused Clock 下想得越多越好,Wall Clock 下想多了直接出局。
这也是为什么很多"我们在 X 基准上超过人类"的结论一到线上就失效——那些基准跑的是 Paused Clock。
Realtime-Bench 的 12 个模型:44% 和 36% 差在哪
被测的 12 个模型分三类:
- 标准异步模型 7 个:GPT-6 Astra、GPT-5.6 Sol、Claude Fable 5.1、Claude Opus 5、Gemini 3.8 Flash、DeepSeek V4.1 Flash、Kimi-K3
- 实时流式模型 3 个:GPT-Realtime-2、Gemini 3.1 Flash live、Gemini 3.8 Live
- 决策模型 2 个:OpenAI Decisions、Jev 1.13
Wall Clock 下,最好的 GPT-6 Astra 拿到 44%,是高推理强度下的数字。同一档强度,Pass^3 只有 36%。
大多数模型的单次延迟超过 1 秒。注意这句话的分量:50 个任务里有一批的决策窗口就在 1 秒量级,延迟过 1 秒意味着部分任务在模型开口前就已经结束。
实时交互里加大推理强度,一半模型变好一半变差
这是我觉得最该被引用的一组数。
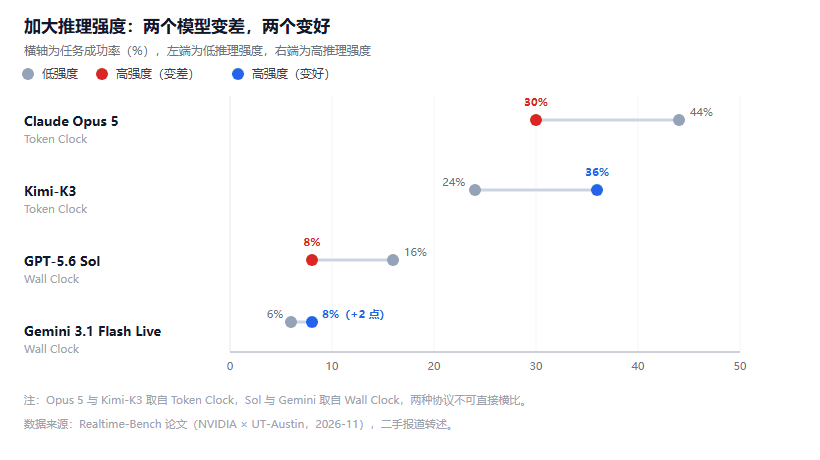
图 1:同模型在低/高推理强度下的成功率,左端为低强度。红点表示变差,蓝点表示变好。数据来源:Realtime-Bench 论文,Wall Clock 与 Token Clock 分别标注
| 模型 | 时钟 | 低强度 | 高强度 | 变化 |
|---|---|---|---|---|
| Claude Opus 5 | Token Clock | 44% | 30% | −14 |
| Kimi-K3 | Token Clock | 24% | 36% | +12 |
| GPT-5.6 Sol | Wall Clock | 16% | 8% | −8 |
| Gemini 3.1 Flash Live | Wall Clock | 6% | 8% | +2 |
两个降、两个升。方向不一致,说明"加推理强度"不是一个通用旋钮,它的效果取决于模型怎么用多出来的那段时间。
有的模型把多出来的 token 花在反复确认上,环境在它确认的时候往前走,它就更晚出手。有的模型把多出来的 token 花在提前规划上,反而更早锁定动作。
这解释了一个现象:同一套 prompt 策略,换模型就崩。你调的是"想多久",但真正决定结果的是"想的过程中世界动了多少"。
Pass^3 视角:延迟压进 1 秒,Jev 只拿到 8%
Jev 1.13 是专为实时设计的决策模型,只输出决策不输出自由文本,延迟做到了 1 秒以内。
它的 Pass^3 是 8%。
这个数字很难看,但它把问题切开了:延迟不是瓶颈。你把时间压到极限,成功率不会跟着上去,因为失败的原因变成了决策质量不够——它够快,但没想明白。
论文还做了一个梯度实验:Token Clock 下把每秒模拟时间对应的生成 token 数从 32 提到 64、128,再到完全去掉生成过程的时间开销。相当于同样长度的思考,消耗的环境时间越来越少。
结果是成功率不会持续上升。即使推理不再消耗环境时间,仍有不少任务做不完。降低延迟有用,但解决不了全部问题。
这条结论对做产品的意义很直接:别把预算全压在"更快"上。留给"想对"的那部分,压不掉。
降延迟在推理侧有大量工程手段,但那条路的边际收益也在变薄 —— 压缩注意力那篇算过,压缩比从 128 提到 1024,多省下的 KV 只有 0.6 个百分点。速度的天花板比想象中来得早。
我在本地写了个最小模拟器复现这个现象,把 2000 个任务的截止时间按确定性随机源铺开,再把单 token 延迟设成 10/20/40 毫秒。同一套逻辑下,最优思考预算随延迟成反比缩小,从 256 token 掉到 128 token;换成 Paused Clock,最优策略直接反转成"能想多久想多久",Pass^3 从 6.4% 涨到 76.4%。完整代码和跑出来的三张表在这篇里。
降低延迟解决不了的部分
论文列了三条观察,我认为第三条最容易被忽略。
第一条,推理强度和成功率不是线性正相关。前面四行数据已经证了。
第二条,思考深度和行动时机要做权衡。这是设计问题,不是参数问题——你得让模型知道"现在还剩多少时间",而不只是"我还能想多久"。
第三条,单纯降延迟不能解决所有实时交互问题。Jev 的 8% 就是证据。
换个说法:实时能力是三个量的乘积——感知准、想得对、出手及时。任何一个接近零,乘出来都是零。现在的模型普遍是第三项拖后腿,但前两项也没到可以放任的水平。
关于 Realtime-Bench 的五个问题
50 个任务够吗? 不够严谨。8 类场景、50 个任务,单类平均 6 个,结论的统计强度有限。它更像一个方向性基准,不是排行榜。
三种时钟哪个最重要? Wall Clock 最接近线上。但做归因分析时 Paused Clock 有用——它把"想得对不对"和"来不来得及"分开了。
Pass^3 是不是太严? 对实时任务不算严。一次性任务失败就是失败,不能靠重试摊平。
这个基准适用于 chatbot 吗? 不适用。对话有轮次缓冲,用户会等你。它针对的是环境自主推进的任务:交易、抢购、监控告警、机器人控制。
为什么没有国内模型的高分? 被测的国内模型只有 DeepSeek V4.1 Flash 和 Kimi-K3,且没有单独公布成绩。Kimi-K3 在 Token Clock 下的 24%→36% 是目前能看到的最好信号。
结语
这份基准的真正贡献不是那个 44%,是那三种时钟。
它把"模型很强但用不上"这件事量化了:同一个模型,换一种环境推进方式,最优策略相反,成功率差一个数量级。以后看到任何"实时能力"的宣传,先问一句——你测的是哪种时钟。
如果对方答不上来,那 44% 和 36% 之间那 8 个点,大概率也不在他的视野里。
参考资料
- NVIDIA、UT-Austin 发布 Realtime-Bench(AIBase)
- Realtime-Bench:三种时钟协议与 12 模型成绩(国资潇湘)
- Large Models Hit a Wall in Real-Time Interaction(哲见 AI)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。