
一句话总结:上海 AI 实验室(SII)和心绪 AI 把递归自我改进(RSI)从后训练搬到了预训练,agent 不是改模型,是改"造模型的流程"——6 条数据管道、130 多个基础设施版本。产出的 801-30B-A3B 只用 6B token 做 SFT、没做 RL,四个 agentic 基准平均分超过了全后训练的同尺寸模型。
这个方向和之前几篇不一样。
Hy4 训 Jev 是后训练阶段的自我改进,百度那套推理优化是在既有模型上做工程优化。这次的 agent 动的是预训练本身——数据管道、训练基础设施、评测口径。
差别在"可重复性"。后训练可以从同一个基座反复试,试错了重来;预训练一次 run 花几十万 GPU 小时,论文里写的是"无法重复"。所以这里的 agent 每个决策的价值都极高。
RSI 改的是预训练流程,不是模型
论文的核心命题可以直接说:预训练阶段有大量"人能判断、但没时间逐条判断"的活儿,这些活儿可以交给 agent。
具体是哪几类活,论文列了三组循环:
| 循环 | agent 做什么 | 产出 |
|---|---|---|
| debug 循环 | 查基础设施故障、查数据异常 | 修复的配置与数据过滤规则 |
| headroom 循环 | 用小规模 SFT 探模型的"上升空间" | 下一步该往哪加数据/算力 |
| 经验转指标 循环 | 把专家的判断变成可自动计算的指标 | 数据分类器阈值、抓取覆盖率的定义 |
第三类最有意思。专家的判断本来是"这批数据质量不行",这句话没法自动执行。要让 agent 用上,得先把它翻译成"重复率 > 0.3 且长度 < 200 的样本丢弃"这种可计算的规则。
这个翻译过程本身就是瓶颈——翻译错了,后面所有自动化都在放大错误。
预训练 RSI 的产出:801-30B-A3B 与 6B token SFT
产出的模型是 30B 总参、3B 激活的 MoE,稀疏度 10:1。
对比一下同代开源 MoE 的稀疏度:
| 模型 | 总参 | 激活 | 稀疏度 |
|---|---|---|---|
| 801-30B-A3B | 30B | 3B | 10 : 1 |
| 混元 Hy4 | 770B | 49B | 16 : 1 |
| LongCat-2.5 | 1.6T | 48B | 33 : 1 |
10:1 属于偏保守的一档。稀疏度低意味着每 token 读的权重多、算力贵,但专家利用率高、训练更稳。
3B 激活按 4bit 算,每 token 读 1.5GB 权重。H200 的 4.8TB/s 带宽下,理论上限约 3200 token/s(单卡、零开销、不算 KV)。这个量级说明它是能单机跑的模型,不是给集群用的。
真正要留意的是"6B token SFT、没有 RL"这句话。
现在的主流做法是预训练完再做大规模 SFT + RLHF,SFT 动辄几百 B token。6B token 的 SFT 是轻量级的,而且跳过了 RL。论文的说法是:在这个设置下,模型的四个 agentic 基准平均分超过了做过完整后训练的同尺寸模型(包括 Qwen3.6-35B-A3B)。
如果这个对比成立,含义是:基座的质量比后训练的规模更重要。 一个数据管道做得好的基座,轻量 SFT 就能打;基座不行,后训练堆再多也补不回来。
这个结论我谨慎接受。原因是 agentic 基准本身就偏好"会用工具"的模型,而基座训练里如果已经包含了大量 agent 轨迹,那这项优势是预期内的,不算意外。
三类循环:debug、headroom、经验转指标
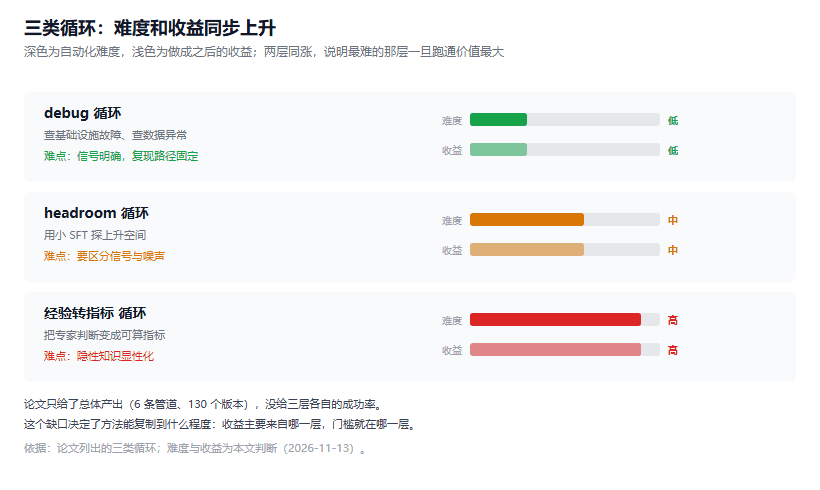
图 1:三层的难度与收益不是同向的,最难的那层收益最大、风险也最大
把三类循环拆开看,会发现它们的"可自动化程度"完全不同。
debug 循环最容易自动化。 报错信息明确、复现路径固定、修复方案有限。这类活人类工程师也是照着手册干,交给 agent 没有本质障碍。
headroom 循环中等难度。 用小规模 SFT 探"这个基座还能不能被拉起来",需要判断"这次的提升是信号还是噪声"。这个判断依赖统计素养,agent 容易过拟合到偶然波动上。100 题基准的误差有 ±9.8 个点,如果 headroom 探测的样本量比这还小,结论就不可靠。
经验转指标最难。 这是把隐性知识显性化,本质是知识工程。做好了收益最大(一旦变成指标就能无限复用),做砸了危害也最大(错误的指标会系统性地筛掉好数据)。
论文没给这三类的成功率,只给了总体产出。这个缺口我觉得是理解这套方法的关键——如果 90% 的收益来自第一类,那这套方法的门槛比想象中低;如果来自第三类,那它很难复制。
共享上下文:负面结果为什么要存
论文里有个工程细节值得单独说:共享上下文基础设施,用来保存负面结果。
多个团队、130 多个版本并行推进的时候,最大的浪费是"重复踩同一个坑"。A 团队试过的方案不行,B 团队不知道,又试一遍。
存正面结果很自然(有效的配置、好用的提示词),存负面结果反人性——没人愿意记录自己失败的过程。但负面结果的复用价值往往更高:它排除了一整片搜索空间。
这个设计思路和软件工程里的"事故复盘库"是一回事。区别在于 agent 可以自动读写这个库,人不行——人写复盘要花时间,agent 写完就进上下文了。
130 个版本的账:RSI 的调用量怎么估
论文给了"130+ 基础设施版本"这个数字,没给 agent 调用次数。可以估一下。
假设每次修一个版本,单轮修复成功率 p,那 130 个版本的总调用轮数期望是 130/p:
| 单轮成功率 | 一次修好 | 需 3 轮以上 | 总轮数期望 |
|---|---|---|---|
| 90% | 117 个 | 1.3 个 | 144 轮 |
| 70% | 91 个 | 11.7 个 | 186 轮 |
| 50% | 65 个 | 32.5 个 | 260 轮 |
| 30% | 39 个 | 63.7 个 | 433 轮 |
p=70% 时,130 个版本要 186 次调用,其中 12 个需要修 3 轮以上。这部分"难修的"会消耗不成比例的时间和上下文。
这个估算的意义在于:RSI 的成本不是线性的,尾部很长。 大部分版本一次就好,少数几个会反复失败,而恰恰是这几个决定了整个流程能不能按时收敛。
论文提到的 debug 循环如果设计得好,p 应该能到 70% 以上。低于 50% 的话,130 个版本要 260 轮以上,人工审核的负担会很重。
四种 RSI 的落地顺序
把这四条放在一起看,能看出 RSI 的落地顺序:
| 案例 | 阶段 | 改什么 | 可重复性 |
|---|---|---|---|
| Naive-N0.5-Flash | 推理引擎 | 内核实现 | 高(可反复测) |
| Hy4 → Jev | 后训练 | 训练配方 | 中(可重训) |
| 百度 ERNIE Evolve | 推理优化 | 服务配置 | 高(可灰度) |
| 801-30B-A3B | 预训练 | 数据管道与基础设施 | 极低(一次 run) |
顺序很合理:从可重复性高的环节往低的环节推。可重复性高,试错成本低,agent 的价值主要在"省人力";可重复性低,试错成本极高,agent 的价值在"少犯错"。
预训练是终点,因为这里一旦错了,几十万 GPU 小时就没了。能在这里用 agent,说明前面几个阶段的可靠性已经被验证过。
我的判断是:这套方法的复制门槛不在 agent 能力,在"指标化"能力。 能把多少专家判断变成可计算指标,决定了 agent 能接多少活。这个转化工作没有捷径,得一个个来。
参考资料
- 801-30B-A3B:在预训练中引入递归自我改进:SII GAIR 团队、心绪 AI,2026-11
- DAIR.AI 对该工作的解读:DAIR.AI Academy,2026-11-12
- 论文项目页与开源模型:Hugging Face
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。