
一句话总结:1.55GB 除以 776M 个 16 维格基向量,正好每维 1 bit、每向量 2 字节,磁盘层的账能精确对上;但常驻显存 3.34GB 反推是 2.14 bit/参数,与官方宣称的 2.03 bpp 差 5%,这部分存疑。
刷到一条新闻:开罗一个叫 ZAQERIS AI 的独立团队发布了 ZQN-12B,124 亿参数的模型磁盘只占 1.55GB,加载后常驻显存 3.34GB,权重用 Barnes-Wall 格 Λ16 做量化,Apache 2.0 开源。评论区两极分化,一半人喊颠覆,一半人喊骗局。
喊什么都不如把账算一遍。新闻给了足够的数字:总参数 12,483,763,200,776M 个打包格基向量,16 维一格,磁盘 1.55GB,常驻 3.34GB,宣称每参数 2.03 bit。这些数字互相之间能不能对上,一除便知。
先算 12B 的磁盘账:1.55GB 除以 776M
第一层账最简单。776M 个基向量分装 2 个 Safetensors 分片,合计 1.55GB,平均每个向量 2.00 字节。向量是 16 维的,2 字节除以 16 维,正好每维 1 bit,一位不多一位不少。
再验参数密度。12.48G 参数除以 776M 个向量,每向量编码 16.09 个参数,和 16 维的格结构对得上——每个 16 维基向量负责还原 16 个权重。折算下来磁盘每参数 0.99 bit。
这个精度级别的吻合说明一件事:磁盘层的存储结构是真实自洽的,1.55GB 不是营销数字,是 776M × 2 字节的精确结果。单看这一层,宣称成立。
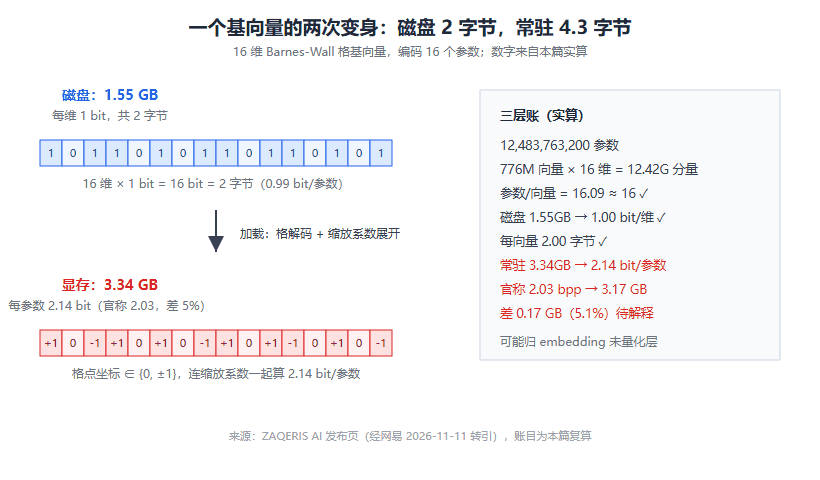
图 1:左上是磁盘态的 16 个 1-bit 格,加载展开成右下的格点坐标;右侧是三层账的实算结果
常驻的 5% 对不上:2.14 还是 2.03
第二层账开始有裂缝。常驻显存 3.34GB,除以 12.48G 参数,每参数 2.14 bit。官方口径是 2.03 bpp,按 2.03 算常驻应该是 3.17GB。差 0.17GB,5.1%。
这 5% 有几种可能的解释。最合理的是 embedding 和输出头没参与格量化,12B 模型的词表层通常占几亿参数,若按 fp16 存放恰好补上这个缺口;也可能是常驻值里含运行时缓冲。发布页没给分项,我倾向第一种,但没有证据,只能标注存疑。
从 0.99 bit 到 2.14 bit,中间那次展开才是格量化的核心动作。磁盘上的 1 bit 坐标不是完整信息,格结构本身携带约束:Λ16 的合法格点要满足范数条件,坐标不是自由取值的。加载时用格解码把 1 bit 的紧凑码还原成 {0, ±1} 域上的坐标,再配每组的缩放系数,才得到参与矩阵乘的权重。压缩率的大头来自结构先验替我们存了一半的信息。这套展开逻辑和显存里的 KV cache正好相反:KV 是常驻全量、按需淘汰,权重是磁盘压缩、加载展开,两侧省的都是同一样东西,访存量。
格量化 Λ16 是什么:4320 个邻居
Barnes-Wall 格 Λ16 是编码理论里的老朋友,16 维实格,kissing number 4320,最小范数 4。这两个数决定了它作为量化码本的资格:4320 个等距邻居意味着在一个半径内能塞下这么多离散点,比朴素的逐维均匀量化密得多。
用格做向量量化的思路不新,通信领域的格量化码本用了几十年,Llama 系的 QARQ 量化器也用过格结构。ZAQERIS 的做法特殊在存储侧:不是把码本索引存下来,而是把格基向量本身按 1 bit 坐标打包。这一步能成立的前提是所有用到的格点坐标都能落在 1 bit 能表达的域里,从账面上看他们做到了,但坐标域只有两个值这一点,意味着真正携带幅值信息的是组缩放系数,那部分的存储开销账面上没有单列。
这是我验证不了的部分:缩放系数的数量和精度,发布页没写,1.55GB 里有没有它们的位置也算不出来。存疑,而且这个疑点不小。
2bpp 量化的能力天花板:和 Q2、Q4 比
把 2.14 bit/参数放到量化谱系里看位置。Q2 量化是每参数 2.5 bit 上下,Q4 是 4.5 bit。2.14 bit 比 Q2 还低一档,这个位宽下 12B 模型的困惑度会显著上升,通常伴随事实性召回变差和长文连贯性下降。
团队声称评测任务表现与量化前相当。这个说法我不能直接采信,2bpp 的格量化要保住能力,需要的是格式本身的高结构密度补偿,Λ16 的 4320 邻居确实提供了比普通 Q2 码本更细的粒度,理论上比同位宽的均匀量化好。理论归理论,没有公开评测集的完整分数和复现脚本之前,这只能算未验证的宣称。
我的判断是:数学上这条路走得通,工程上值不值要看第三方的实测。要是真有团队拿它跑一遍 MMLU 和 HumanEval 对照原始权重,这个争议一天就能了结。
宣传之外存疑的地方
把存疑清单列全,按影响排序。第一,缩放系数的去向不明,这是最大的一块,1.55GB 里如果没给缩放系数留位置,解码时幅值信息从哪来就成问题。第二,常驻 5% 的缺口没有分项解释。第三,2.03 bpp 的评测报告没有附脚本和分数明细。第四,"零显存泄漏"的动态子流形说法,描述的是张量熵路由的运行时行为,没有任何外部可观测的验证手段。
反过来说,已验证的部分也值得记下:磁盘层 1.00 bit/维的精确吻合不是巧合能解释的,存储格式是真实存在且设计过的。这个团队要么真做出了真东西,要么做了一个自洽的数字游戏,两者的分界线就在第三方复现。
消息源方面也要交代:ZAQERIS AI 是个此前没听说过的团队,我没有去翻它在 HuggingFace 和 GitHub 上的全部历史,这一层没有验证。对这类背景不明的发布,账算通了只值得记录,不值得部署。等权重和评测脚本被社区过一遍再说,K3.1 Pro 那种 1.56TB 的部署账再夸张,至少参数口径和文件大小是能互验的,这个 1.55GB 还差一层验证。
FAQ
Q:1.55GB 装 12B 参数在数学上可能吗?
纯信息论下限没有违反:1.55GB 折合每参数约 1 bit,若格结构能提供足够的先验约束,1 bit 存储加结构解码在理论上成立。问题不在数学,在工程验证缺失。
Q:Barnes-Wall 格是什么?
16 维的实格点集合,编码理论中的经典构造,kissing number 为 4320,即单位球内能均匀摆放 4320 个等距邻居。这种高密度离散结构适合做向量量化码本。
Q:为什么磁盘 1 bit、显存却要 2.14 bit?
磁盘存的是压缩态:利用格结构的约束只存每维 1 bit 的紧凑码。加载时解码成完整格点坐标并附上缩放系数,才能参与矩阵运算,展开后位宽自然更高。
Q:这个模型现在能直接下载用吗?
宣称权重以 Apache 2.0 开源在 HuggingFace。能下载和值得用是两回事,截至发稿没有独立第三方的评测复现,生产环境建议观望。
Q:和普通 Q2 量化比强在哪?
理论优势在码本密度:Λ16 的 4320 个邻居比 Q2 的 4 状态码本粒度细得多,同位宽下失真更小。但实际效果取决于工程实现,没有实测分数前只能算纸面优势。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。