
一句话总结:SSE 是现在大模型流式输出最常用的协议,抓包看到text/event-stream就是它。它比 WebSocket 简单得多——纯 HTTP、单向推送、没有掩码、没有帧头。我起了个 socket 服务抓真实字节:一条data: {"t":"hi"}消息正好 18 字节,字段名加空格 6 字节,载荷 10 字节,两个换行 2 字节。
抓流式接口的包,经常会看到一堆这样的东西:
event: delta
id: 42
data: {"t":"hi"}

data: {"t":"end"}

: keep-alive
第一次看到会以为是什么自定义协议。其实不是,这是 W3C 的 SSE(Server-Sent Events)规范,2011 年就有了,比 WebSocket 还早。
它简单到有点过分——整个协议就一个规则:用换行分隔字段,用空行分隔事件。
一、先看响应头:认出这是 SSE
逆向任何协议,第一步都是认出口。
SSE 的响应头有两个特征:
HTTP/1.1 200 OK
Content-Type: text/event-stream; charset=utf-8
text/event-stream 这个 MIME 类型就是它的身份证。看到它,基本可以确定后面是 SSE。
另外要注意 Cache-Control: no-cache——流不能缓存,否则第二次请求会拿到旧的完整内容,看起来像"一次性全吐出来"。
还有一个细节:如果是 HTTP/1.1,响应会带 Transfer-Encoding: chunked;如果是 HTTP/2,没有这个头(HTTP/2 本身支持流)。内容完全一样,别因为少了 chunked 就以为换了协议。
二、一条 SSE 消息 18 个字节
我起了个本地 socket 服务,发了一组真实数据,然后把字节逐个打出来。
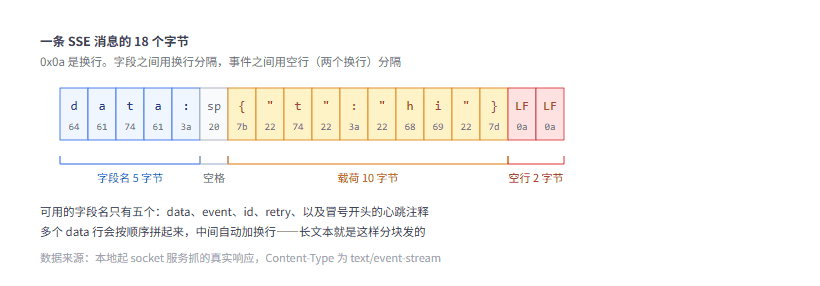
图 1:字段名 5 字节,空格 1 字节,载荷 10 字节,两个换行 2 字节
实测的一条消息:
b'data: {"t":"hi"}\n\n'展开成字节:
d  a  t  a  :  sp {  "  t  "  :  "  h  i  "  }  LF LF
64 61 74 61 3a 20 7b 22 74 22 3a 22 68 69 22 7d 0a 0a
18 个字节,没有长度前缀,没有校验和,没有掩码。
这一点和 WebSocket 帧完全不同——WS 帧有 6 字节起的头部、要解掩码、要处理分片。SSE 就是纯文本,用一个 \n\n 划边界。
代价是文本传输比二进制低效,但胜在人眼可读、抓包直接能看明白。
三、SSE 的五个字段名
规范里只有五个字段:
| 字段 | 含义 | 备注 |
|---|---|---|
data | 消息内容 | 可以出现多行,按顺序拼接 |
event | 事件类型 | 不给就是 message |
id | 事件 ID | 重连时用于续传 |
retry | 重连间隔(毫秒) | 控制客户端重试节奏 |
: xxx | 注释 | 冒号开头,常用来发心跳 |
三条容易踩的规则:
冒号后面的空格是可选且要被吃掉的。 data: hello 和 data:hello 的载荷都是 hello,不是 " hello"。解析时如果不去掉前导空格,JSON 解析就会失败。
多个 data 行要拼起来,中间加换行。 这是长文本分块的机制:
data: {"t":"第一段
data: 第二段"}
拼出来是 {"t":"第一段\n第二段"}。
冒号开头的行是注释,不是数据。 服务端靠这个发心跳保活——:\n\n 每 30 秒发一次,防止中间代理把连接判成空闲断掉。解析时应该跳过,别当空消息处理。
四、解析器怎么写
我给的文件级解析器,三十行不到:
def parse_sse(text):
    events = []
    for block in text.split("\n\n"):        # 空行切事件
        if not block.strip():
            continue
        evt = {"event": "message", "data": "", "id": None}
        for line in block.split("\n"):
            if line.startswith(":"):         # 注释行
                evt["comment"] = line[1:].strip()
                continue
            if ":" not in line:
                continue
            field, _, value = line.partition(":")
            if value.startswith(" "):        # 吃掉可选空格
                value = value[1:]
            if field == "data":
                evt["data"] += value + "\n"  # 多行拼接
            elif field in ("event", "id", "retry"):
                evt[field] = value
        evt["data"] = evt["data"].rstrip("\n")
        events.append(evt)
    return events
拿刚才那三个事件跑一遍:
{'event': 'delta', 'data': '{"t":"hi"}', 'id': '42'}
{'event': 'message', 'data': '{"t":"end"}', 'id': None}
{'event': 'message', 'data': '', 'id': None, 'comment': 'keep-alive'}第三个是心跳,data 是空的,靠 comment 字段能认出来。
注意这是离线解析整个响应体。 真要做流式处理,得用增量解析——按 \n\n 累积缓冲区,收到完整块才解析,不然半个 JSON 会解析失败。
五、断线重连看 Last-Event-ID
SSE 有个自动重连机制,浏览器原生支持。
连接断了之后,客户端会自动重连,并且在请求头里带上:
Last-Event-ID: 42服务端看到这个头,就知道该从哪个事件之后继续推。
这个设计的实用价值在长任务场景:一个 10 分钟的生成任务,中间网络抖了一下,重连之后不用从头再来。
不过要说明:这要求服务端自己实现"按 ID 续传"。 协议只规定了客户端怎么带这个头,服务端怎么用是自由的。很多实现根本不理这个头,直接重头开始。
六、坑清单
按踩坑概率排。
1. 换行可能是 \r\n。 规范只认 \n,但有些服务端或代理会把行尾改写成 \r\n。这时候 split("\n\n") 切不开,因为实际是 \r\n\r\n。稳妥做法是先统一换行。
2. 空格处理错一位,JSON 就崩。 data: {"t":"hi"} 里冒号后有一个空格,去掉它之后才是正确的 JSON。少去一个字符,解析就报错。
3. 心跳包被当成空消息。 如果只判断 data 不为空才处理,心跳会被静默丢掉——这没问题。但如果判断 block 非空就处理,心跳会产生空事件,下游可能崩。
4. 增量解析要有缓冲区。 网络分片不会按事件边界来。你可能收到半行 data: {"t":,下一片才是 "hi"}。必须缓存到出现 \n\n 再解析。
5. 别用 read() 等全部读完。 SSE 的本质是流,用 requests.get().text 会一直阻塞到连接关闭。要用 stream=True 逐块读。
七、边界
这篇讲的都是明文 HTTP 下的 SSE。如果流量走了 TLS,抓包看到的是密文,得先解决证书或做中间人解密,那是另一层的事。
另外我只测了文本事件。规范里还支持 retry 控制重连间隔,我这次没在真实服务上验证它的行为。
还想说一句:SSE 之所以在大模型场景流行,不是因为先进,而是因为够简单。一个 HTTP 连接、一个纯文本格式,任何语言十行代码就能解析。相比 WebSocket 要处理握手、掩码、分片、ping/pong,SSE 的协议开销几乎为零。
message threads那篇讲的是另一个方向的优化——把重复传输砍掉。两者叠加起来,就是现在流式对话的完整链路:少发、边发、边解析。
参考资料
- MDN:Server-sent events - 事件流格式与字段说明
- WHATWG HTML 规范:Server-sent events - 解析算法的权威定义
- RFC 6455 - WebSocket 协议,可对照理解两者的差异
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。