
一句话总结:一个 123 星的 Chrome 扩展,选了最笨也最稳的路:用 chrome.debugger 挂上调试协议去读响应体和 Set-Cookie。作者在 README 里断言这是 MV3 下唯一能完整读到响应体的方案。这句话值得拆开看看为什么。
起因是我在想一个很实际的问题:Manifest V3 之后,浏览器扩展还能不能像以前那样抓接口。 搜到这个项目,叫「接口抓取工具」,纯前端,数据全存本地 IndexedDB,不依赖后端。核到 123 星、40 fork、1 个待处理 issue,2026 年 6 月 7 日创建,AGPL-3.0,JavaScript,仓库 464KB。
它的定位很清楚:抓当前浏览器里所有页面的请求,把请求头、请求体、响应体、Set-Cookie 全留下来,再给你筛选和导出。
MV3 砍掉的是什么
老版本扩展有一个阻塞式的网络接口,可以在请求发出前读它、改它、拦它。V3 把这个能力收了,主推声明式规则:你事先写好一批规则,浏览器按规则处理,扩展自己不参与每一次请求。
观测能力还留着一部分,能看到 URL、方法、状态码这些元数据。但响应体读不到。 这一刀切得挺准。对广告拦截这类场景,声明式规则完全够用,还更省资源;对抓包这类场景,等于把最核心的东西拿走了,因为接口调试要看的恰恰是响应体。
三条路,只有一条走得通
要在 MV3 里拿到响应体,理论上有三个方向。 第一条是声明式规则。它只能改请求头、拦请求、重定向,拿不到响应内容,方向不对。
第二条是内容脚本注入页面,改写页面里的 fetch 和 XMLHttpRequest。光猫凭据那篇里的思路有点类似:不跟平台的限制硬碰,改从旁边接。这条路的问题是覆盖面窄,它只能看到页面自己发的请求,扩展背景页、Service Worker、其他标签页都漏掉,而且页面一旦用原生方法缓存了引用,改写就失效。
第三条是调试协议。扩展用调试接口挂上标签页,之后就能用和 DevTools 同一套的协议读网络事件,包括响应体。 这个项目走的是第三条,README 里也直接这么写:基于 chrome.debugger 实现,是 MV3 下唯一能完整读取响应体与原始 Set-Cookie 的方案。
「唯一」这个说法我倾向于理解为「唯一不需要改页面代码的通用方案」。第二条路在某些场景下也能拿到响应体,只是覆盖面差太多。
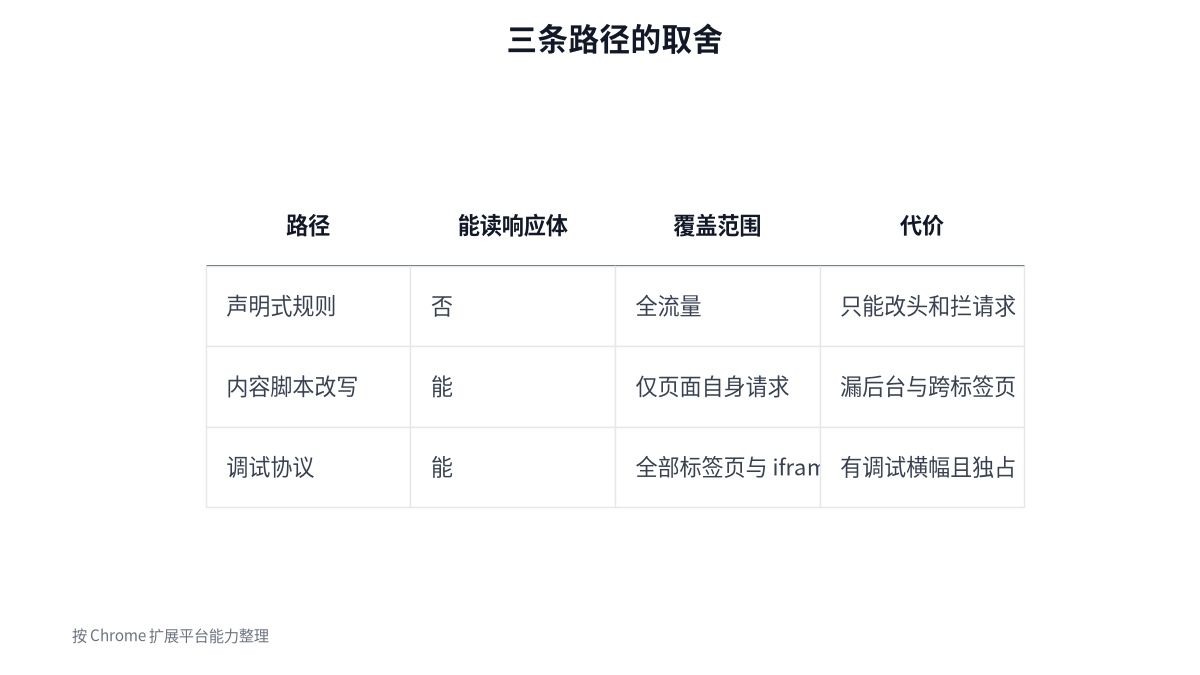
图 1:三条路里只有调试协议能不改页面代码、又能拿到响应体
走调试协议的代价,作者没藏
用调试接口不是没有成本。挂上之后浏览器顶部会显示一条提示,告诉你这个标签页正在被调试。这条提示关不掉,是浏览器故意的。 第二个限制是独占。同一个标签页同一时间只能有一个调试器,DevTools 开着的时候扩展挂不上去,反之亦然。写过这类工具的人应该都踩过。
第三个是时序。响应体要在它还有效的时候取走,页面一导航、请求记录一清,再想回头读就没了。所以这类工具必须边抓边存,不能等抓完再批量处理。 从它的功能表能看出作者怎么应对:实时列表、最新记录置顶、边监听边写库。这不是界面偏好,是被时序逼出来的架构。
功能表里几个真解决痛点的细节
先给个参照。站里写去 AI 味那篇时,我也是拿一份现成的规则表逐条对,看哪条真解决问题、哪条只是听起来有道理。抓包工具一样。
我按重要性排一下它的功能,前三项是别的抓包工具常漏的: 重定向链逐跳记录。30x 的每一跳单独成一条,保留中间响应的状态码、响应头和 Set-Cookie。多数工具只给你最终那一下,中间发生了什么看不见,而登录态丢失、Cookie 被覆盖这类问题恰恰藏在中间。
WebSocket 抓取。记录握手阶段的请求头和响应头,再记录消息帧,每条连接最多 500 帧。这个上限是合理的取舍,不设上限内存会炸。 覆盖 iframe 和新标签页。自动附加已打开的标签页,新开的也跟上,页面里嵌的 iframe 一并算。很多同类工具只盯当前标签页,嵌在里面的请求全漏。
另外几项偏易用:静态资源默认过滤(图片、字体、样式、媒体、JS 都丢掉,只留接口请求,可以一键改成全抓)、按类型加关键字筛选、右键「复制为 fetch」、导出 JSON 或带 BOM 的 CSV、把 Cookie 注入新标签页打开目标站点。
「复制为 fetch」这项看着小,实际最省事。抓到一个接口想复现,不用手抄 header,直接拿一段能跑的代码。
123 星、40 fork,和一个不算小的协议选择
fork 比 32.5%,在这个星标量级算很高。这类工具的用户里,想改一改自己用的人比例本来就大。 它的许可证是 AGPL-3.0,不是 MIT。这个选择说明作者想过被拿去商用的问题:AGPL 要求把修改版作为网络服务提供时也公开源码。想内网部署一套改过的版本,这条得先看清楚。
仓库 464KB,只有一个待处理 issue,说明维护状态还行。创建到现在五个多月,星标涨得不算快,符合「垂直工具」的传播曲线。 我没法确认的是:它在你机器上的实际性能。抓包这类东西吃内存,500 帧的 WebSocket 上限、大体积 POST body 的存储策略,这些在不同页面上表现差别很大,而我没有实测数据。
用之前该想清楚的一件事
抓包工具本身中性,边界在使用场景。抓自己的会话、调自己的接口,没问题;抓别人的登录态、拿别人的 Cookie 去注入,性质就变了。 顺带一个技术上的提醒:这类扩展能读到明文 Cookie 和响应体,所以它自己也成了一个高价值目标。装之前至少看一眼它的权限清单和数据流向,这个项目把数据存在本地 IndexedDB、不设后端,这一点是加分项。
MV3 的限制还会继续收紧,走调试协议这条路能撑多久,取决于浏览器愿不愿意一直开放这个接口。真要长期做接口分析,代理式抓包仍然是更稳的底座,扩展是在「不想装证书」的场景下的折中。
FAQ
Q:需要装证书吗?
不需要。它读的是浏览器已经解密后的网络事件,不碰 TLS 层。
Q:为什么开着 DevTools 就抓不到?
调试器是独占的,一个标签页同时只能挂一个。关掉 DevTools 再开扩展即可。
Q:数据会上传吗?
README 写明全部存本地 IndexedDB,没有后端服务。
参考资料
- GitHub · zhinianboke/packet-capture-tool(AGPL-3.0,含功能表与实现说明)
- GitHub API · 仓库元信息(星标、fork、创建时间,查询于 2026-11-21)
- Chrome 扩展文档 · chrome.debugger(调试接口的能力与限制)
口径与核验:123 星、40 fork、1 issue、创建 2026-06-07、AGPL-3.0、464KB 来自 GitHub 接口;「基于 chrome.debugger」「MV3 下唯一能完整读响应体」、功能清单里的重定向逐跳、500 帧上限、覆盖 iframe、导出带 BOM 的 CSV 均引自项目 README。MV3 移除阻塞式网络接口、调试器独占、页面顶部提示这三条属于浏览器平台行为,我按文档与经验写,没有附截图实测。性能部分我没跑过,文中已标为不确定。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。