
一句话总结:上海交大的 AutoDNA 平台自主协调 20 多类仪器、完成 11000 多步 DNA 存储实验,全程无人值守,成果上了 Nature。它的价值不在"AI 会做实验",在于把自然语言需求翻译成可执行流程这件事跑通了。
看到 11000 步这个数字,我第一反应是"自动化跑批而已"。看完流程描述才意识到不是——跑批是已知流程重复执行,这里是从一句自然语言需求开始,让模型自己拆步骤、选仪器、判断中间结果。
差别在出错的时候。跑批脚本遇到异常就停,等人来看;这套东西遇到异常要自己决定下一步。
自动化实验室的 11000 步是什么量级
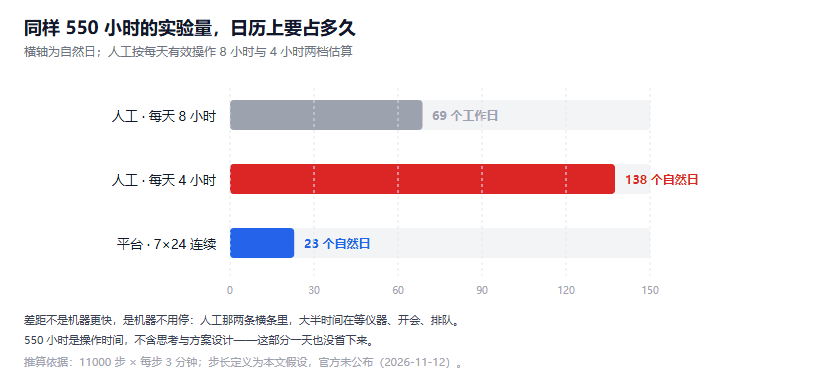
图 1:按每步 3 分钟估算 550 小时;人工班次按 8 小时和 4 小时两档,平台按 7×24
按人工操作估:一步实验包含移液、温控、检测、记录,熟练实验员平均 3 分钟。11000 步就是 550 小时。
换成工作日,一天 8 小时是 69 天,差不多三个半月。一个人不休息、不出错、不重复,要干这么久。
平台是 7×24 跑的,550 小时连续作业约 23 天。反推每步 3 分钟,正好对上——说明它没在等人工,节奏是仪器本身的节奏。
| 指标 | 数值 | 口径 |
|---|---|---|
| 实验步数 | 11000 多步 | 官方 |
| 仪器类别 | 20 多类 | 官方 |
| 人工等效工时 | 约 550 小时 | 按每步 3 分钟估算 |
| 连续作业时长 | 约 23 天 | 按 7×24 推算 |
| 领域 | DNA 存储 | 官方 |
"步数"这个单位有个陷阱:一步的粒度可粗可细。把"配一次缓冲液"算一步,和把"完成一轮合成—纯化—检测"算一步,数字能差十倍。官方没给单步定义,所以 11000 这个数只能横向比同类平台,不能直接换算成人月。
为什么是 DNA 存储这个场景
AutoDNA 做的是 DNA 存储相关实验。选这个方向不是随机,是因为这个领域的实验有两个特征,正好卡在自动化能解决的区间里。
特征一,密度差得离谱。 DNA 存储的理论密度是每克 215 PB(这是 2012 年哈佛那篇论文给的量级,实测远低于此)。换算一下:
- 1 PB 数据 → 4.65 毫克
- 10 PB → 46.5 毫克,两粒米重
- 100 PB → 465 毫克
- 一粒米(20 毫克)理论上装 4.3 PB
一个中型机房上百 PB 的冷数据,理论上几克粉末能装下。当然这是极限值,实际系统里编码方式、纠错冗余、读取设备的限制会把密度打掉几个数量级。但方向是明确的:冷数据的长期归档,DNA 是唯一还有几个数量级空间的方向。
特征二,步骤多且重复。 合成一段 DNA 要走合成、扩增、纯化、测序、校验,每一段可能几十步,步骤之间不能省。这种"步骤量大、每步动作固定、出错代价高"的活,恰恰是自动化收益最大的形态。
反过来说,如果实验是"一天做三个样品、每个样品流程都不一样",上这套平台不划算——适配成本摊不开。
所以这套方案的适用范围很清楚:高通量、流程固定、可标准化的实验。 在这之外,它帮不上忙。
自动化实验室怎么调度 20 多类仪器
这里的工程难点不是"调用仪器 API",是给每台仪器建立一套模型能理解的语义。
一台液相色谱仪的参数有流速、梯度、柱温、检测波长、进样量,每个参数有物理约束(流速不能超过柱压上限)。如果直接把这些参数暴露给模型,模型很容易给出一个"语法正确、物理上做不了"的指令。
AutoDNA 的做法是中间加一层:模型输出的是实验意图("纯化这段产物"),由这一层翻译成具体参数,并在下发前做约束检查。
这个结构和我们做软件时给 agent 加工具层是一回事——工具接口设计得对不对,直接决定 agent 能不能用。区别在于软件工具出错能回滚,实验做坏了样品就没了。
约束检查这一层的通用做法,内核融合那篇从另一个角度讲过:把固定开销和有效计算分开算,才知道优化该往哪使。仪器调度的固定开销就是每步的约束检查,它是省不掉的。
模型—实验—仪器协同设计,难点在哪
论文标题里的"协同设计"是三个东西互相约束:模型要知道仪器能做什么,仪器接口要暴露模型需要的信息,实验流程要能在中途被改。
难点集中在第三点:中间结果怎么反馈给模型。
实验不像写代码,没有即时输出的日志。一轮合成要几小时,检测要另外排队。模型在等待期间做什么?是阻塞等,还是先规划后面的步骤、等结果回来再调整?
如果是后者,就要求模型维护一个"待定状态"——哪些步骤的结果还没回来、哪些后续决策依赖它。这是个典型的异步规划问题,比同步执行难一个量级。
我没看到论文里怎么处理这段,只能说我关心的正是这一块。因为真正决定无人值守能不能成立的,不是会不会规划,是等结果的时候会不会做错决定。
无人值守的边界:哪些环节还不能放手
"全程无人值守"这句话要加限定。
第一,异常样品的判断。 仪器能报"数值超范围",但"这管样品颜色不对、可能是污染"这种判断,现在的视觉和传感还接不住。所以流程里必然保留了人工巡检点,只是频率低。
第二,方法学的创新。 11000 步是在既定方法下的执行。要不要换一种合成路线、要不要试一个没验证过的条件,这类决策还是人的事。
第三,安全。 DNA 合成的生物安全审查是法规要求,不是技术问题。这条线不能交给模型判断。
所以准确的表述是:在方法确定、样品标准、安全可控的前提下,执行环节可以无人值守。 前提之外的部分,一步都没省。
无人值守之后,做实验的人做什么
对实验室,最直接的变化是一个人的产出上限被抬高了。以前一个博士生带两台仪器,现在一个人管一套平台,产出取决于设计实验的能力,不取决于手速。
这会把竞争点从"谁更能熬"转到"谁设计的实验更有信息量"。听起来是好事,但对习惯了靠工时堆产出的团队是压力。
对做工程的人,这套东西的可复用部分是约束检查层。不管底下是仪器还是数据库,模型给出的指令都要先过一遍"物理上/业务上做不做得了"的校验,再执行。这层做不好,agent 越自主越危险。
还有一层我拿不准:这类平台的边际成本。 20 多类仪器的接口适配是一次性投入,但每接一个新仪器都要重做一遍。如果一台仪器的适配要两周,那这套方案的复制速度就受限于仪器数量,不是模型能力。这个数字论文里没提,我也没有渠道验证。
参考资料
- AutoDNA:AI 原生自主生物分子实验平台:Nature,2026-11
- 上海交大团队成果登上 Nature:上海交通大学官网
- AI 原生科学实验室完成万步实验:36 氪报道
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。