
一句话总结:商汤的 SenseNova 6.8 Flash 用了循环层架构,32 层里首尾各 4 层正常执行,中间 24 层共享同一份权重连续跑两遍,单次前向完成 56 次层计算,等效参数约 14.6B。官方称它能达到 27B 参数级开源模型的水平。这条路把能力的来源从"堆参数"换成"算得更久",省的是显存,花的是时间。
商汤这次发的东西,参数只标 9B,官方却说它能打 27B。这两个数放在一起,第一反应是营销话术。
翻完结构说明,我发现它是真的。只是"打"的方式和常规模型不一样——它不是知道得更多,是想得更久。
一、SenseNova 6.8 Flash 的层结构:32 层里只有 8 层是新的
SenseNova-Loop-9B-Preview 在 10 月 30 日开放权重,11 月 2 日正式版 SenseNova 6.8 Flash 上线,进入商用产品线。
解码器一共 32 层。但它们的执行方式不一样。
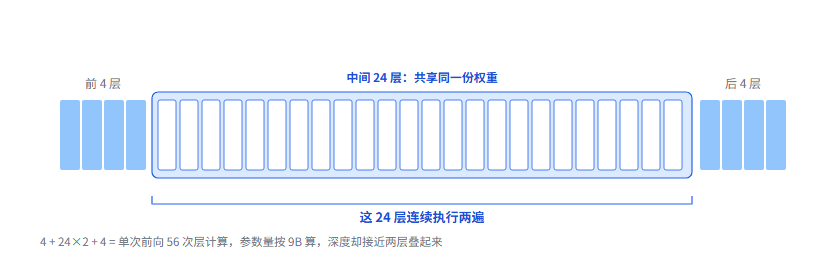
图 1:中间 24 层只有一份权重,连续跑两遍,单次前向累计 56 次层计算
前 4 层正常执行一遍,后 4 层也正常执行一遍,中间 24 层跑两遍——同一份权重,输入是上一遍的输出。
算一下总的层计算次数:4 + 24×2 + 4 = 56 次。参数量按 9B 算,但前向的深度接近 56 层网络。
官方的换算口径是"推理等效参数约 14.6B"。这个数字不是把参数量乘了两遍,而是按计算深度折算出来的——我更愿意把它理解成"这个模型干活时的复杂度,相当于多大参数的普通模型"。
训练上下文最长 262,144 token。
二、循环层为什么能顶参数
要理解这件事,得先把"参数"和"深度"分开看。
参数量决定模型能装多少知识。深度决定它能对同一份信息反复处理多少轮。这两件事在传统架构里是绑死的——层数越多,参数越多,显存占用越大。
循环层把这个绑定拆开了。
中间 24 层只有一份权重,显存里只放一份。但执行时走两遍,第二遍拿第一遍的输出继续算。这相当于让同一组神经元对同一个问题想两次。
打个比方:一个 32 人的团队,每人只管一件事,遇到复杂问题也只能各管一摊。另一个 9 人的团队,同一个人被要求对同一个问题从两个角度各想一遍——人少,但思考的轮次多。
第二种做法在什么任务上占优?多步推理。 因为多步推理的瓶颈不是"知道多少事实",是"能不能沿着一条链推下去"。循环层天然适合这件事。
在什么任务上吃亏?知识密集型。 你问它一个冷门事实,它脑子里没有就是没有,多想十遍也想不出来。
这解释了官方给出的评测分布:GPQA Diamond 涨了 4.42 分,TeamBench 涨了 13.34 分。前者是研究生级科学问答(偏推理),后者是多步骤智能体任务(强推理)。
三、消融实验:Loop 到底贡献了多少
| 项目 | 数值 |
|---|---|
| 总参数 | 约 9B |
| 解码器层数 | 32(首尾各 4 层 + 中间 24 层循环) |
| 单次前向层计算 | 56 次 |
| 推理等效参数 | 约 14.6B |
| 训练上下文 | 262,144 token |
| 消融增益 | GPQA Diamond +4.42,TeamBench +13.34 |
表格里的消融数字值得单独说。所谓消融,就是把某个设计去掉再测一遍,看分数掉多少——这是判断一项技术到底有没有用的最直接办法。
+13.34 分在智能体任务上不算小。同类工作里,改个后训练方法通常只能拿到个位数提升。
不过这两组数字是官方自报,没有第三方复现。我把它标为"待验证"。
四、代价藏在 KV cache 和循环里
任何省显存的设计,代价通常出现在别的地方。这个方案的代价有两处。
第一,单 token 延迟变高。 普通 32 层模型算一个 token 是 32 次层计算,它是 56 次。多出来的 75% 计算量,直接反映在首 token 时间和出字速度上。省了显存,慢了推理。
第二,KV cache 不省。 这一点很多人会误解——以为循环层共享权重,缓存也能共享。实际上两遍循环各自产生各自的 Key 和 Value,都要存。27B 那篇算过的内存账在这里同样成立:262K 上下文下,KV cache 可能比权重本身还占地方。
换句话说:这个架构省的是权重显存,不是上下文显存。这笔账和投机解码那篇算的是同一类问题:在前面省下来的东西,总要在后面还回去。
如果你的场景是短输入、长输出(比如写代码),它很划算——权重要常驻,上下文短,KV 压力小。
如果你的场景是长文档分析,262K 全填满,那循环层省下来的那点权重显存,会被 KV cache 吃掉。
五、SenseNova Loop 这套架构适合谁
三类人值得看。
显存卡在 12 到 16GB 的人。 9B 的权重按 FP16 算约 18GB,量化到 8bit 约 9GB,塞进单卡没问题。等效 14.6B 的能力,比硬塞一个 27B 模型现实得多。
做多步 Agent 的人。 官方把 TeamBench 的提升摆在最前面,说明它自己也知道这块是主打。装模型、调工具、走多步流程这类任务,深度比知识更关键。
做端侧或边缘部署的人。 9B 参数量在手机、车机、工控机上还有想象空间,27B 没有。
反过来,如果你的任务是知识问答、事实检索、长文档摘要,循环层的收益会明显缩小。
六、常见问题
SenseNova 6.8 Flash 和 Loop-9B 是同一个模型吗?
Loop-9B-Preview 是 10 月 30 日开放权重的预览版,6.8 Flash 是 11 月 2 日上线的商用正式版,后者把前者的循环架构带进了产品线。
9B 参数怎么做到 27B 的效果?
不是参数量变大了,是计算深度变深了。单次前向 56 次层计算,等效参数按计算量折算约 14.6B。官方说达到 27B 级水平,这个对比口径是评测分数,不是参数量。
循环两遍会不会导致输出重复、卡壳?
从官方公布的评测看没有明显退化,但这类问题通常要在长输出场景下才暴露,我手上没有实测数据。
能商用吗?
Loop-9B-Preview 开放了权重,具体许可条款要以官方发布为准。商用产品是 6.8 Flash,走 API。
和 MoE 比哪个划算?
思路相反。MoE 是参数量大、每次只激活一小部分;循环层是参数量小、每层多跑几遍。前者省计算,后者省显存。
结语
这条路的本质是拿时间换空间。
过去两年大家比参数量,是因为显存和算力都在涨。现在单卡显存卡在 80GB 上不动了,参数量的天花板先到,工程师只能往别的方向找空间。循环层是其中一个答案。
我认为它会成为一种常见设计,不会取代稠密模型。原因很简单:它的优势和劣势都太明确了——推理强、知识弱、省显存、慢。
知道自己要什么的人,能从中拿到好处。
参考资料
- 腾讯研究院 AI 速递 2026-11-03 - 收录 SenseNova 6.8 Flash 与 Loop-9B 发布信息
- AI 圈要闻 2026-11-03 - 含循环架构层数与消融数据
- 商汤日日新 - 官方产品信息
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。