
一句话总结:产业链消息称 DeepSeek V5 计划基于华为昇腾 950 做预训练,节奏指向明年落地。此前昇腾只承担推理任务。这两件事的差别不在"用哪块卡",而在"验证模型能不能跑"和"验证模型能不能造"是两个量级的工程。真正的准备早就开始了:9 月 30 日 DeepSeek 把面向昇腾的整套基础设施组件开源了出来。
昨天晚上十点多看到那条消息:DeepSeek 下一代大模型 V5,计划用华为昇腾 950 做预训练。
我第一反应是这消息不该这么平静。
因为重点不在"DeepSeek 又用国产卡了"——这件事从 2025 年春节就开始了。重点在"预训练"这三个字。
一、消息本身:V5 要用昇腾做预训练
先把事实摆清楚,也得说清来源。
这条消息来自财联社《科创板日报》和财闻的报道,引述的是"多名产业链人士",DeepSeek 和华为都没有官方确认。
报道里的关键信息有几条:
- V5 计划采用昇腾 950 作为核心训练算力,项目节奏指向明年
- 双方核心研发对接团队常驻杭州
- 在 V4 阶段已经完成大量底层算子适配与定制开发
- 规划在乌兰察布建大型智算中心,明年建成投运
- 华为没有参与 DeepSeek 股权投资,合作只停留在产品、算力、技术适配层面
那条"华为没投"值得单独说。市场上有 DeepSeek 融资和 IPO 的传闻,这条"华为没投"的澄清,说明双方的关系是商业合作,不是资本绑定。这个区别很重要——它意味着 DeepSeek 选昇腾是算力供给现实的决定,不是站队。
二、推理和预训练差的是什么
很多人把这两件事当成同一个"用国产卡"的概念。差得远。
推理侧的考核指标是吞吐、时延、单位 token 成本。 系统要做的是稳定地把服务交付出去。一张卡出问题,摘掉就行,请求转到别的卡上。
预训练是模型生产的上游。 它要求上千张卡连续几周甚至几个月不间断跑同一个任务,中间不能停。任何一张卡故障、任何一次通信抖动,都可能让整个训练中断,回滚到上一个检查点重来。
所以两者的技术门槛完全不同:
| 维度 | 推理 | 预训练 |
|---|---|---|
| 核心指标 | 吞吐、时延 | 集群稳定性、并行效率 |
| 故障影响 | 摘掉重试 | 中断回滚 |
| 瓶颈 | 单卡算力、显存带宽 | 卡间互联、节点间通信 |
| 软件依赖 | 推理框架、算子库 | 编译工具链、通信库、并行策略 |
| 验证的问题 | 模型能不能跑 | 模型能不能造 |
表格末行是整个事情的核心。推理验证的是"模型能不能跑",预训练检验的是"模型能不能造"。
这就是为什么"昇腾做推理"和"昇腾做训练"之间的差距,比很多报道描述的大得多。
三、这两年他们做了什么
这条合作线不是突然开始的。
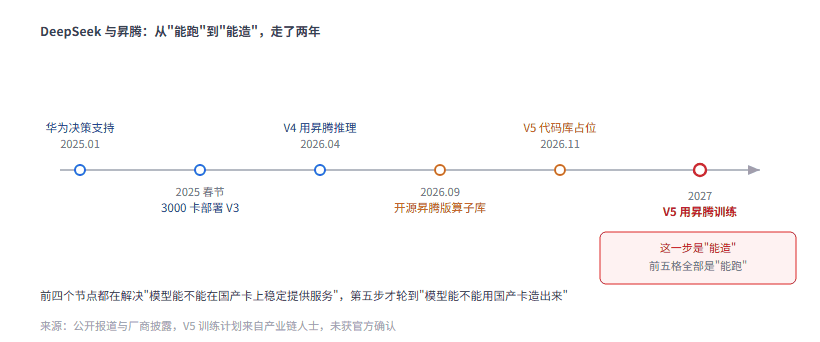
图 1:六个节点里,前四个都在解决"能不能跑",第五步才轮到"能不能造"
按公开信息梳理:
2025 年 1 月 28 日,华为高层决策让华为云快速支持 DeepSeek。除夕到大年初二,双方完成 3000 多张昇腾芯片的部署和验证,把 V3/R1 部署到华为云贵安数据中心。这一阶段的关键词是"部署"。
2026 年 4 月,V4 发布后,华为称通过"芯模技术协同",昇腾超节点全系列产品已可全面支持 V4 系列。同期 DeepSeek 在官方 API 页面提到,受限于高端算力,V4-Pro 的服务吞吐仍有限。
2026 年 9 月 30 日,这一条最关键。DeepSeek 开源了面向昇腾算力平台的基础设施组件,包括:
- TileLang:高级语言编译工具
- DeepGEMM、FlashMLA、TileKernel、DeepSelect:高性能计算库
- DeepEP:分布式通信库
这四类东西和此前面向英伟达平台开源的组件一一对应。
这说明什么。 不是"适配一下就能跑",是把整套软件栈在昇腾上重写了一遍。编译工具、算子库、通信库——这三样是训练能不能跑起来的地基。
我看这条的时候才意识到,V5 用昇腾训练不是明年的决定,是去年就开始做的事。9 月 30 日那个开源动作,更像是把准备工作公开了。
四、V5 的时间线上有个说不通的地方
这里有个矛盾我必须指出来。
10 月 28 日前后,DeepSeek 官方代码库里出现了 deepseek-v5、deepseek-v5-open、deepseek-v5-next 三个占位。代码结构显示是双轨下发:v5-open 走无版本门槛路线,v5-next 要求客户端升级。业界普遍推测 11 月中旬 V5 Pro 和 V5 Flash 会同步上线。
但同一时间,昇腾训练的消息说的是"明年落地"。
如果 V5 这个月就发布,它用什么算力训练的?
我能想到三种解释,但都无法证实:
一是命名错位。 11 月发的是 V5 系列的产品更新,可能基于现有架构改进,完整版(用昇腾从头预训练的)才是明年的那个 V5。
二是版本分叉。 v5-open 和 v5-next 本身就是两条不同的产品线,一条现在发,一条明年发。
三是报道口径有偏差。 "V5 用昇腾训练"可能指的是 V5 之后的下一代,只是被简化成了 V5。
这一条我标存疑。如果你看到有人把"11 月发 V5"和"V5 明年用昇腾训练"并列写而不解释,那多半是没注意到这个矛盾。
五、昇腾 950 是什么规格
公开信息不多,能确认的是:950 系列分 950PR 和 950DT 两款,均基于第三代达芬奇架构,面向大模型的训练与推理场景。
具体算力、显存、互联带宽这些参数,官方没给完整数据披露。我不做推测。
能确定的是软件栈侧的准备:华为提供了联合定义的昇腾超节点 SuperPoD Flex 和 UBL128 组网方案,开放 Ascend C 编程接口与底层指令体系支持 TileLang 工作。
超节点这个概念,美团 LongCat 那篇讲过——国产单卡显存有限,靠把多卡组成一个大节点来绕开通信瓶颈。这条路和英伟达的 NVLink 是一个思路,但实现方式不同。
六、对开发者意味着什么
三个可观察的点。
接口大概率不变。 DeepSeek 的开源组件本来就是照着英伟达那套的接口重写的(DeepGEMM 对应 cuBLAS,DeepEP 对应 NCCL 那一层)。对上层开发者来说,调 API 的方式不会变。
价格有下探空间。 V4 时期官方说过,受限于高端算力,V4-Pro 的吞吐有限,等昇腾 950 超节点批量上市后价格会大幅下调。如果 V5 真能在昇腾上训练,成本结构会变。
国产卡的可选性会变。 如果 V5 真用昇腾完成预训练,那"国产卡只能做推理"这个判断就被推翻了。这对所有要用国产算力的团队都是个参考。
这件事的另一面在显存账上。循环层那篇算过的显存翻转点说明的是同一类问题:能跑起来,和跑得划算,中间隔着一段。
不过要提醒:训练成功不等于训练高效。 能训练出来,和单位算力成本比英伟达低,是两件事。目前没有任何关于效率的公开数据。
七、常见问题
这条消息确定吗?
不确定。来源是产业链人士,两家公司都没有官方确认。写这篇的时候我只能按"有这件事的可能性"来处理。
昇腾 950 量产了吗?
公开信息里没有明确的量产时间。DeepSeek 的乌兰察布智算中心预计明年建成,时间上是对得上的。
V5 什么时候发布?
代码库占位指向 11 月中旬,但没有官方时间表。而且如上所说,发布时间和训练算力之间有个解释不通的地方。
用国产卡训练,模型效果会差吗?
取决于软件栈成熟度,不取决于芯片本身。算力够不够是数量问题,能不能跑通是工程问题。后者更难。
这对普通用户有什么影响?
短期没有。中期可能表现为价格下调和吞吐提升。
结语
这件事真正的看点不是"国产替代"这四个字。
是一个团队愿意把最核心的生产环节——预训练——搬到一条新路上。这比做推理适配难得多,因为一旦失败,损失的是几个月的时间和整批算力。
9 月 30 日那批开源组件,现在回头看,像是提前打的招呼:工具链我先公开了,你们可以检查我是不是认真的。
至于 V5 到底哪个月发、用哪批卡训练,等官方说话。在那之前,所有时间线都是推测。
参考资料
- 财联社:DeepSeek V5 计划基于昇腾芯片预训练 - 产业链消息与昇腾合作历程
- 财闻:V5 明年有望基于昇腾 950 完成训练 - 团队常驻、乌兰察布基地与股权澄清
- DeepSeek V5 代码库占位分析 - V5-open 与 V5-next 双轨下发机制
- 中华网:DeepSeek 下代大模型计划用国芯训练 - 推理与预训练的工程差异
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。