
一句话总结:OpenAI 的 GPT-Image-2.6 全量上线,出图时间缩短一半、最快 6 秒。它的 GIF 功能不是生成视频,而是先画一张 3×2 的六帧序列图,再切片合成——绕开了视频模型的帧间一致性和延迟问题。同一版本还把 API 拆成 Flare 和 Sunburst 两个型号,新增 complexity 参数把「场景复杂度」和「画质」分开控制。
前阵子想让 AI 做个动图,试过两条路。
一条是文生视频,生成五秒,等了两分钟,出来一看,人物的手在前三帧是五根指头,后两帧变成六根。
另一条是自己画四张图,用 PIL 合成 GIF。四张图风格对不上,颜色一个比一个偏。
两条路都不好用。然后看到 OpenAI 这个做法,我愣了一下——它没走这两条路里的任何一条。
一、GPT-Image-2.6 改了什么:6 秒、两个型号、一个参数
先把这次更新的东西列清楚。
| 项目 | 变化 |
|---|---|
| 上线范围 | ChatGPT、Codex、API 全量 |
| 生成时间 | 缩短约 50%,最快 6 秒 |
| API 型号 | 拆成 Flare 和 Sunburst 两个 |
| 新增参数 | complexity,控制场景规划算力 |
| 新能力 | GIF、SVG 矢量导出、圈选局部重绘(开放给 API) |
两个型号的分工:
- Flare:主打速度和排版
- Sunburst:主打多轮修改的一致性
这个拆分挺有意思。以前一个模型要同时满足「快」和「改十轮不跑偏」,两个目标互相拉扯。拆成两个之后,各管一头。
complexity 这个参数更值得说,下面单独讲。
二、GIF 不生成视频,它画了一张序列图
这是这次更新里最巧的一处。
它的做法是:先生成一张 3×2 的六格图,每格是一帧,然后按顺序切成六张,拼成 GIF。
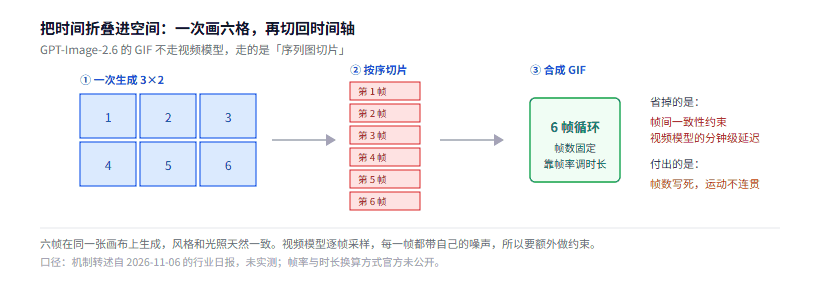
图 1:一次生成保证风格统一,切片只是搬运像素
为什么这么绕?因为它绕开了视频模型的两个硬伤。
硬伤一,帧间一致性。 视频模型是逐帧(或逐段)生成的,每一帧都有自己的采样噪声。要让六帧里的人物长得一样、背景不漂移,得额外做约束。而画一张图里的六个格子,它们天生在同一张画布上,共享同一套风格和光照。
硬伤二,延迟。 视频模型生成五秒要一两分钟。图片模型生成一张六格图,六秒。差一个数量级。
用一句话概括这个设计的本质:它把「时间」压缩进了「空间」。
动画本来就是时间轴上的一系列帧,它把这个轴折叠到画布的第二个维度上——横向三格、纵向两格,一次画完,再展开回时间轴。
这个思路不新(雪碧图、精灵图就是这么来的),但用在生成式模型上,是个聪明的迁移。
同类思路在视频生成那边也出现过:Pika 把采样从 50 步压到 6 步是砍掉「不必要的计算」,这里是砍掉「不必要的生成次数」。两者都在回答同一个问题:为了让结果能用,最少需要算多少。
三、为什么用序列图切 GIF,而不是生成视频
再往深想一层,这个方案还有两个隐含的好处。
好处一:可以重画单帧。 如果第六帧不满意,理论上可以只重绘那一格,其他五帧不动。视频模型做不到这一点——你改一帧,整段都要重生成。
好处二:算力花在「画」上,不花在「算运动」上。 视频模型要学物理、学运动轨迹、学遮挡关系。六格图不需要,它只要每一格都画得像,读者自己会脑补中间的运动。
代价也很明显:帧数固定,运动不连贯。
六个格子就是六帧。想要更长的动画,要么画更多格子(4×3、5×4),要么循环播放。而且帧与帧之间的过渡是「跳」的,不是「滑」的——适合做表情包、加载动画、简单的循环效果,不适合做流畅的动作。
这就是它的定位:不是视频的替代品,是「轻动图」的新做法。
四、complexity 和 quality 解耦是什么意思
这个参数我觉得是这次更新里对开发者最实用的。
以前控制出图质量,只有一个旋钮:quality。调高,画质好,但慢、贵。调低,快、便宜,但糊。
问题是「画质」和「场景复杂度」是两件事:
- 一个简单的图标,需要高锐度、高精度,但场景本身不复杂
- 一个复杂的街景,需要很多元素、正确的空间关系,但每个元素不需要极致清晰
GPT-Image-2.6 把这两件事拆开了:quality 管画质,complexity 管「场景规划的算力」。
这个拆法的意义是省钱。 画一个图标,你可以 quality 拉满、complexity 拉低——它不需要花算力去规划一个复杂场景。反过来画街景,complexity 拉高、quality 中等,因为元素多比像素锐更重要。
这类「把单一旋钮拆成两个」的设计,在别的地方也见过。量化档位那篇算过类似的账:Q4 和 Q8 的差别不只是「好和不好」,是「哪个维度上更好」。
五、SVG 和局部重绘:把输出格式也管了
两个附带的能力,但对企业用户可能比 GIF 更重要。
原生 SVG 导出。 生成的图直接是矢量,可以无损放大、可以改颜色、可以进设计工具二次编辑。这对做 logo、图标、UI 元素的人来说是刚需——位图放大就糊,矢量不会。
圈选局部重绘开放给 API。 以前这个功能只在界面里能用,现在可以调接口。意味着可以写脚本批量处理:把一批图里的某个元素统一换掉,或者把水印区域重绘。
这两件事合起来看,OpenAI 在把「图片生成」往「设计工具」的方向推。 一次性的图谁都能生成,能进工作流的图才有黏性。
六、常见问题
六格 GIF 最多几秒?
取决于播放速度。六帧按每秒 6 帧播是一秒,按每秒 2 帧播是三秒。但帧数不变,所以「时长」是靠放慢速度换来的,会显得卡。官方没给推荐的帧率。
能生成更长的 GIF 吗?
按这个机制,要更长就得多画格子。3×3 是九帧,4×4 是十六帧。但格子越多,每格分到的分辨率越低,单帧质量会下降。
Flare 和 Sunburst 该选哪个?
一次成型、要快要排版的选 Flare;要反复改、要求十轮之后还一致的选 Sunburst。这是官方定位,我没实测。
complexity 具体怎么影响结果?
官方说它控制「场景规划的算力」,也就是模型在动笔前花多少力气想构图。调低会更凭直觉画,调高会先规划再画。具体差多少,得实测。
这些能力在国内能用吗?
API 层面要看账号权限和网络。国内厂商也在做类似功能,但「六格切 GIF」这个具体做法我没见到对标的。
七、结语
这个更新里,我认为最值得学的不是任何一项能力,是那个「把时间折叠进空间」的思路。
遇到「需要序列、但逐帧生成代价高」的问题时,先问一句:能不能一次画完,再切开?
这个问法能省掉很多东西——不用做帧间约束、不用等长时间生成、不用为了一帧重跑整段。
代价是灵活性。但这个代价,对「轻动图」这个场景来说,付得起。
参考资料
- 腾讯研究院 AI 速递 20261106 - 本文功能细节与六格切 GIF 机制的主要来源
- AI科技日报 2026 年 11 月 6 日 - Flare/Sunburst 型号划分与 complexity 参数的补充说明
- OpenAI Images API 文档 - 参数定义与调用方式的官方参考
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。