
一句话总结:港中文和上海 AI 实验室的研究发现,现有图像编辑模型有两个串联的缺口。一个是给一张图加一个问题,它判断不出该改哪里;另一个是指令明确了,但执行步骤一多就开始崩——路径长度 1 步时几乎全对,10 步时准确率接近零。ETCHR 用两阶段训练分别补这两头。
前几天让一个模型帮我把一张流程图里的错误连线改掉,它把整张图重画了一遍。
风格变了,配色变了,我原来那版的所有细节都没了。它确实按我说的做了,只是做的不是我要的事。
这种体验背后有个挺具体的问题:模型不知道我要改什么,它只知道我说了什么。
一、ETCHR 的两个缺口:图像编辑模型漏在哪
这篇论文来自香港中文大学和上海 AI 实验室,做的就是这件事。它把图像编辑拆成一条流水线,然后指出线上有两个断点。
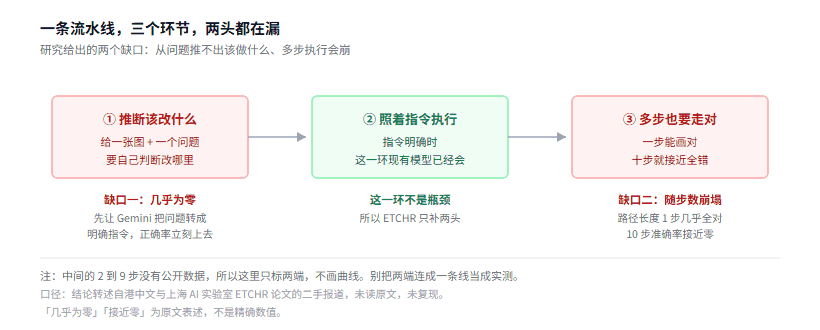
图 1:中间那环已经能用,两头都在漏
第一个缺口:推断缺口。用户给的是「这张图哪里不对」这种感觉,模型要自己判断「该改哪一块」。这一步现在几乎不会。
第二个缺口:生成侧推理缺口。指令明确了之后,模型能执行单步操作,但需要连续多步推理的操作(比如按最短路径在迷宫上画线)会随着步数增加迅速失效。
中间那环反而是好的:指令明确、单步执行,现有模型做得不错。
这个拆法我觉得很实用,因为它把「AI 修图不好用」这句抱怨拆成了两个可以分别解决的问题。
二、缺口一:它不知道该改什么
论文做了个很聪明的对照实验。
同一批任务,两种喂法。一种是直接把问题原文给编辑器;另一种先用 Gemini 把问题转成明确指令(改哪里、改成什么),再交给编辑器执行。
结果是:有明确指令的情况下,编辑正确率远高于只有抽象问题的情况。
这个对比说明什么?说明编辑器的「执行」能力和「理解」能力差得很远。你告诉它「把第三个节点往左移 20 像素」,它能做;你告诉它「这个流程图读起来不顺」,它就不知道从哪下手。
我们平时用 AI 修图,给的恰恰都是后者。
这一点和桌面上那类 Agent 的困境一样。 agent-desktop 那篇里讲过,让 Agent 操作界面时不走截图、走无障碍树,本质也是把「看着像按钮的地方」换成「role 是 button、name 是提交的节点」——把模糊的视觉判断换成明确的元素定位,成功率立刻不一样。
三、缺口二:知道要改,但多步会崩
第二个缺口更隐蔽,因为它在单步任务上完全看不出来。
论文用迷宫路径和冰湖路径做测试:给定最短路径的文字描述,让模型在图上把它画出来。
结果:路径长度 1 步时,几乎总能画对。长度增加,准确率急剧下降。到 10 步,准确率接近于零。
这个数字我第一反应是「怎么会崩得这么彻底」。想了一下明白了:多步绘制不是「一次画十条线」,是「画完第一条,基于当前图像状态画第二条」。每一步的输入都包含上一步的结果,上一步歪一点,后面全部跟着歪。
误差是累积的,而且是视觉层面的累积——不是数字算错了,是画出来的东西越来越不像。
这跟大模型做长链推理时的失效模式是一个道理:单步都对,串起来就崩。区别在于图像编辑的误差还会被「看」回来,形成正反馈。
四、ETCHR 的补法:两阶段训练加一道验收
论文的方案分两段,对应两个缺口。
第一段,推理模仿监督微调。 用「原图 + 问题 → 目标修改图 + 答案」这种成对数据训练,让模型学会从问题推断出该做什么编辑。训练数据覆盖五类任务:
| 任务类型 | 数据来源 | 要模型学会的事 |
|---|---|---|
| 细粒度感知 | V* 数据集 | 在高清图里找到很小的目标并圈出来 |
| 图表理解 | RefChartQA | 读懂柱状图、折线图,圈出与问题相关的区域 |
| 逻辑推理 | 迷宫 | 在迷宫图上画出正确通行路径 |
| 拼图还原 | Spatial-SSRL | 把打乱的图恢复成正确顺序 |
四类任务的共同点:都要先想再画,不是直接画。 选这些数据不是随机的,是在针对第一个缺口下药。
第二段加一道验收。 论文把它叫「一道验收」,具体机制在二手报道里没讲清楚,我不猜。
五、图像编辑的拆法能迁移到哪
我认为最有价值的部分不是 ETCHR 本身,是它的拆法。
任何「AI 做不好某件事」的抱怨,都可以先拆成「不知道该做什么」和「知道但做不好」两半。 这两半的解法完全不同:前者要补训练数据里的判断样本,后者要解决误差累积。
按这个框架看几个常见场景:
AI 写代码改错文件。 大部分情况是第一个缺口——它不知道你要改哪,只好把整段重写。给它明确的文件路径和函数名,成功率立刻上去。
AI 做数据分析给错结论。 更像第二个缺口——每一步计算都对,但中间结论传下来就歪了。解法是让它每步输出中间结果,人抽查。
AI 翻译风格不对。 第一个缺口。它不知道你要什么风格,只能给个平均值。
我的经验是,八成的问题在第一个缺口上。 大家抱怨「AI 不听话」,多数时候不是它不听话,是我们说的话在它那里没有对应的动作。
六、多步推理归零这事,我没看到原始数据
三件事得说清。
一,我没有复现。 所有数字(1 步几乎全对、10 步接近零)都来自二手报道对论文的转述,我没读原文,也没跑过 ETCHR。
二,中间那 8 个步数点没有公开数据。 报道只给了两端,所以图里我只标两端,没连成曲线。如果中间是线性下降还是断崖式崩塌,现在不知道,这两种情况对应的解法不一样。
三,「几乎为零」不是精确数值。 原文用的是这种表述,可能指 5%,也可能指 0.5%。差别在工程上很大。
另外这类论文有个共同的验证难题:图像编辑的「正确」很难自动判定。 迷宫路径可以比对,但「这张图修得自不自然」没法用指标衡量。所以这类评测里,能用客观指标的部分(迷宫、拼图)会被反复测,真正难的部分(自然度、风格保持)反而测不准。
同一个方向的另一条路是微信那个视觉模型,960 万参数、敢在目标不存在时返回 None。两篇讲的都是「让视觉模型学会判断边界」,只是一个在编辑侧、一个在检测侧。
七、常见问题
ETCHR 是产品还是论文?
论文。港中文和上海 AI 实验室的研究工作,不是可以直接下载来用的工具。
它能用来修图吗?
短期内不能。它是方法论层面的贡献,指出了两个缺口和一种补法,离产品化还有距离。
为什么中间那环不用补?
因为现有模型已经会了。指令明确 + 单步执行这两件事,图像编辑模型做得不错,瓶颈不在这里。把资源投在已经能用的环节上是浪费。
这个拆法对我用 AI 工具有什么用?
一个具体做法:下次 AI 做得不对,先问自己「是我没说清要改什么,还是它执行歪了」。如果是前者,把要求写细;如果是后者,把任务拆小。
多步绘制的准确率能提高到什么程度?
论文说 ETCHR 在推理任务上有改善,但没有给出和基座的完整对比数字,二手报道里也没有。这个我没法判断。
八、结语
1 步几乎全对、10 步接近零,这个对比比任何跑分都直观地说明了:AI 的能力不是一条平滑的线,是一段一段断的。
断点在哪,决定了该怎么用它。图像编辑的断点在第十步左右,那就在第九步之前把任务切开,别指望它一口气走完。
这不是妥协,是对工具的准确认识。
参考资料
- 搜狐 - 香港中文大学与上海 AI 实验室找到让 AI「边看边想」的新办法 - 本文所有数字与实验设计均转述自此文
- Microsoft - UI Automation 树结构概述 - 无障碍树的结构参考,用于对照「结构化定位 vs 视觉判断」
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。