
一句话总结:觅深知源开源了生物分子基础模型 Mol-1,抗体—抗原结构预测成功率 75.0%,与 Isomorphic Labs 的 IsoDDE(75.6%)基本持平。更有意思的是加表位约束之后,同一个模型能到 88.3%——多了 13.3 个百分点,靠的不是更多参数,是多给了一条先验。
抗体结构预测这件事,过去两年基本是 DeepMind 系和几家制药巨头在做,成果发论文,代码不开源。
这次有个中国团队把权重放出来了。
一、Mol-1 的 75.0% 意味着什么
先把数字摆清楚。
在 FoldBench-AB 这个抗体—抗原测试集上:
- IsoDDE(Isomorphic Labs):75.6%
- Mol-1:75.0%
- Mol-1-constraint:88.3%
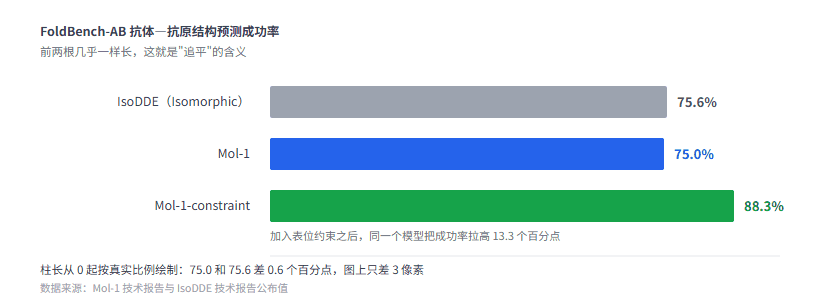
图 1:75.0 和 75.6 差 0.6 个百分点,图上只有 3 像素,这就是"追平"的实际含义
0.6 个百分点的差距,在统计上基本不具备区分度。所以准确的说法是"追平",不是"超越"。
有些中文报道用了"反超 Anthropic"这个说法。这个说法指的是另一组评测——大型复合物建模,Mol-1 的 Agent 在多数测试案例上准确度超过 Anthropic 此前公布的结果。那是另一个任务,不是抗体结构预测。 两件事不能混着说。
我把这条单独拎出来,是因为这类转述很容易被读成"全面超越",实际不是。
二、Mol-1 一个模型覆盖多种复合物
技术上的重点不在分数,在"一个模型"这四个字。
Mol-1 可以预测的复合物类型包括:
- 抗体—抗原
- 蛋白质—多肽
- 蛋白质—小分子
- 分子胶
传统做法是每类复合物训一个专用模型。Mol-1 用一个模型全覆盖,这意味着它学到的不是"某一类分子的形状规律",而是更底层的东西。
还有一个能力值得说:抗体从头设计。团队表示已获得结合与功能的实验验证。设计和预测是两回事——预测是"给结构算分数",设计是"从零造一个能结合的分子"。后者难度高一个量级。
三、开源的选择:为什么放权重
团队把代码和权重都放出来了,可以在线用,也可以下载到自己的环境跑。
这个选择值得说两句。
科学模型的商业模式和通用模型不一样。 通用模型可以卖 API,因为用户量大、调用频次高。科学模型的用户是全球几万个实验室,单次推理可能跑几天,按 token 计费根本不成立。
所以对科学模型来说,开源不是让利,是唯一能规模化的路径。让每个实验室在自己的超算上跑,比让他们排队调你的 API 现实得多。
团队在官方文章里写的是"开放能让整个领域走得更快"。这话说得客气,但商业逻辑也摆在那。
四、同期的 Hydrogen-1.0:753B 科学模型
同一周还有另一个科学模型开源。
Deep Principle 发布了 Hydrogen-1.0,基于 GLM-5.3 构建,753B 参数的 MoE 架构,面向化学、材料和生命科学,MIT 许可证。据称在 FrontierScience-Research 上表现超过 GPT-6-Astra。
753B 加上 MIT 许可,这两条放在一起不太常见。大模型配宽松许可,通常意味着发布方判断"能力本身不再是壁垒,数据和服务才是"。
两个模型、两个方向:Mol-1 走"小而专"(单模型覆盖多模态复合物),Hydrogen-1.0 走"大而全"(753B 覆盖整个科学领域)。
循环架构那篇讨论过同样的分岔:参数效率和多参数规模,是两条都在走的路。
五、生物分子模型为什么突然扎堆
我想到三个原因。
一是评测标准成熟了。 抗体结构预测有 FoldBench 这样的公开测试集,分子生成有明确的验证流程。有标准就能比,能比就有人卷。
二是数据积累到临界点。 蛋白质结构数据库(PDB)积累了几十年,加上 AlphaFold 带来的预测结构,训练数据不再稀缺。
三是算力成本下来了。 一个生物分子模型的训练规模,比通用大模型小一到两个数量级。几百张卡的集群能做的事,不再是巨头专属。
第三条最重要。它意味着这个领域的竞争会从"谁有算力"转向"谁有数据和验证能力"。
这笔账和显存那篇算的是同一类问题:当硬件成本压到某个位置,决定胜负的就不再是硬件。
六、常见问题
Mol-1 能直接用于药物研发吗?
不能。结构预测只是药物发现链条的第一环,后面还有结合亲和力、毒性、成药性、临床试验。预测得准不等于药能成。
75.0% 的成功率算高吗?
在抗体—抗原这个任务上,75% 已经是当前最好水平附近。但这个数字依赖测试集的构成,换个更难的数据集会掉。
加了约束为什么能涨 13 个点?
因为表位约束本身就是强先验——它告诉模型"抗体应该结合在这个区域"。相当于把搜索空间砍掉一大块。这也说明模型的原始能力离"自己找对位置"还有距离。
开源版本和在线平台有区别吗?
官方说都可以用。通常在线平台会包一层更好的交互和预计算,本地跑更自由但需要自己配环境。
能商用吗?
要看具体许可条款。权重开放不等于无条件商用,医药领域的专利问题比软件复杂得多。
结语
这个模型最值得记的不是 75.0 这个数字。
是 88.3 那个数字告诉我的事:同一个小模型,多给一条先验,能力能涨 13 个百分点。
这比"堆更多参数"划算得多,也比"等下一代模型"快得多。做垂直领域的人应该都从这个思路里拿点东西——你的领域里有没有那种"人一看就知道该往哪找"的先验,能不能把它塞进模型。
参考资料
- 新浪财经:中国 AI 制药开源生物分子基础模型 - Mol-1 评测数据与开源信息
- Agentic AI News 2026-11-03 - Hydrogen-1.0 发布信息
- Mol-1 开源仓库 - 代码与权重
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。